添加是机器,删除是人类:测量和缓解LLM代码编辑中的删除回避
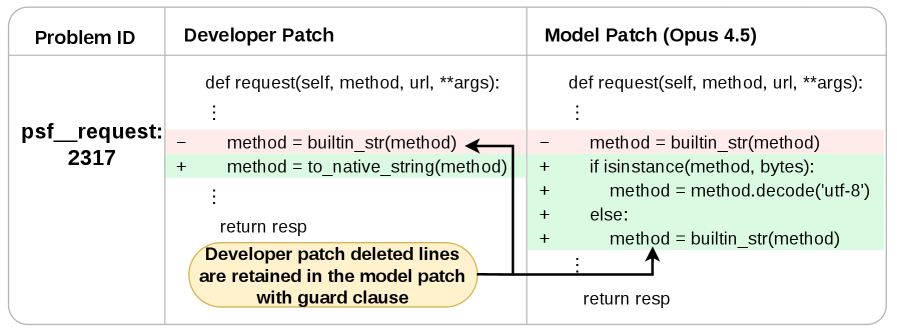
大语言模型越来越多地编写和修复生产代码,但有证据表明,它们通过测试的补丁会让代码库更难维护。我们识别出一个具体来源:删除回避 (deletion avoidance)——模型系统性地倾向于保留本应在预期编辑中删除的代码。 在官方SWE-bench Verified 排行榜前五大模型中,即便针对所有五个模型都能解决的任务,删除召回率最高也只有71.7%;模型在超过92%的必需删除中找到正确文件,但不到52%的情况下能精确删除对应行。相反,29.0%的通过补丁将目标代码包裹在守卫或回退逻辑中,我们称之为Guard-and-Go 模式。这类补丁之所以存在,是因为原始测试很少检查删除行为:当我们为34个任务改造出“目标代码保留则失败”的测试时,四个前沿模型(含闭源与开源)的通过率从63.2%降至41.9%。 鉴于真实修复混合了删除与添加,我们构建了CanItDelete 基准,包含200个从真实提交中挖出的“仅需删除”任务。即使无需添加,最佳模型仍有五分之一任务失败,较小开源模型只达18.0%。随后,我们对GPT-5.6 Sol 进行四种累积提示的消融;成功率的提升主要来自提供精确行号,这几乎消除了不完整删除,但成功率仅升至80.5%,因为模型会过度删除或新增代码。 最后,一项试点研究表明,在后期训练中教授删除行为可减少删除回避并改进整体代码编辑性能——这意味着该问题更多源于训练不足,而非能力边界。
论文精读
TL;DR LLM 修代码时系统性地避免删除旧代码,产生臃肿且难维护的补丁;本文量化此“删除回避”行为,并提出基准与训练方法以显著缓解。
问题
问题背景
大型语言模型 (LLM) 在自动化代码修复与生成领域取得显著进展,主流评测如 SWE-bench 高度关注补丁的测试通过率,但对此类“通过”补丁的实际维护代价关注不足。
现有方法局限
- 测试驱动的漏洞:SWE-bench 等基准仅检查测试结果,而项目测试套件通常缺少对“应删除代码”的覆盖,导致模型输出大量 Guard-and-Go 模式——用条件分支包裹目标代码而非真正删除,表面上测试通过,实则保留冗余逻辑。
- 指标缺失:现有评估不衡量删除操作的召回率与精确率,论文数据显示五个领先模型的删除召回率最高仅 71.7%,且 29% 的通过补丁包含 Guard-and-Go,但现有榜单仍判定其为成功修复。
- 训练偏差:主流模型在指令微调时处理的大量样本为“添加功能”,删除行为在预训练语料中本就稀疏,模型天然倾向于保留原有代码,缺乏安全删除的动机。
为什么难且重要
删除回避不是一个简单的指令跟随问题:模型需要在文件级定位、行级精确切割、不引入多余代码的前提下完成移除。在真实修复中,删除与新增常同时发生,模型必须正确解耦两者。若删除不彻底,会累积技术债务,长期降低代码库可维护性,在持续集成流水线中引发隐性故障。业界对自动化修复的高可靠性要求,使该问题成为从学术榜单到生产落地必须跨越的障碍。
行业类比
类似自动驾驶在突发障碍前倾向保守刹车而非绕行,短期安全但极端场景下会导致通行瘫痪;代码修复中回避删除同样以“伪通过”掩盖风险,最终拖慢软件系统演进节奏。
核心洞察
- LLM 在代码修复中系统性回避删除,通过测试的补丁常保留应删代码,形成隐蔽技术债务。这暴露出现有评估以测试通过率为核心的盲区——测试集很少验证删除是否执行。该视角将焦点从“能否通过测试”转移到“修改是否符合开发者意图”,对自动化代码修复的工程可靠性提出了根本性质疑。
- 在后训练阶段显式教导删除操作,可有效降低删除回避,并提升整体代码编辑性能。这表明该行为并非模型能力瓶颈,而是训练数据中“添加主导”的统计偏差,为从数据配比和训练目标层面优化模型提供了可操作的路径。
方法
研究框架:从现象度量到病因诊断与缓解
输入:研究基于两类代码编辑任务。一是 SWE-bench Verified 官方榜单 中所有五个前沿模型(如 GPT-5.6 Sol、Claude 等)均能解决的 issue 子集,用于对比 开发者补丁 与模型生成的补丁。二是团队从真实 Git 提交中挖掘的 200 个 纯删除任务,构成 CanItDelete 基准,每个任务仅需删除代码,不涉及任何新增。
关键分析模块
删除行为量化
- 对开发者补丁与模型生成的通过测试的补丁,计算删除召回率(Recall,需删除的代码中被模型删除的比例)和定位能力(模型是否找到需删除的行)。
- 识别出一种系统性的规避模式:Guard-and-Go——模型用
if/try-catch等控制流包裹应删除代码,而非真正删除,导致 29.0% 的错误补丁通过测试。这类补丁之所以有效,是因为原有测试很少验证代码是否被移除。
补强测试以暴露缺失删除
- 对 34 个 SWE-bench Verified 任务,手工构造 “删除必失败”断言(fail-to-pass tests),若目标代码未被删除则测试失败。
- 重新评测四个闭源/开源模型,通过率从 63.2% 骤降至 41.9%,证明现有测试低估了删除避免的影响。
CanItDelete 隔离诊断
- 将编辑行为简化为纯删除,排除新增代码的干扰。
- 在基准上测试多个模型,发现即使最强的模型仍有 五分之一任务失败;小型开源模型成功率低至 18.0%。
- 对 GPT-5.6 Sol 进行渐进式提示消融:逐步给出文件路径、需删除的行号等,直到提供确切的删除行,不完整删除几乎消失,但成功率仅升至 80.5%,因为模型反而越界删除或额外添加代码。
后训练干预(概念验证)
- 在训练数据中混入删除示范,微调模型。
- 结果表明:删除专项训练不仅减少删除避免,还泛化提升整体代码编辑性能,暗示该行为源于训练不足而非能力上限。
输出:一系列可复现的度量指标、一个纯删除基准,以及指向数据侧改善的初步证据。
与同类方法差异:以往代码编辑评估聚焦于生成正确补丁,而本研究首次将“删除”作为独立行为维度进行系统性拆解,揭示了测试信号盲区与训练数据偏差驱动的删除避免现象,并提出了可操作的基准与缓解方向。
实验
实验设计
- 第一阶段:在 SWE-bench Verified 上评估五个顶级 LLM 的补丁,测量删除回避行为:统计 deletion recall 与开发者补丁的差距,并分析未能删除时引入的 Guard-and-Go 模式(即用 guard 或 fallback 包裹代码而非真正删除)。
- 第二阶段:为 34 个 SWE-bench 任务构造 deletion-specific F2P (fail-to-pass) 测试,检验标准测试是否遗漏关键删除。
- 第三阶段:构建专用基准 CanItDelete,从真实 commit 中抽取仅需删除的 200 个任务,彻底剥离新增代码干扰,并在 四种提示累计消融 下测量模型表现,从 baseline 到显式提供精确行号。
- 第四阶段:通过后训练注入删除样本,初步验证 deletion-focused post-training 能否缓解该问题。
关键发现
- 删除回避普遍存在:即使是在所有模型均能解决的简单任务上,最佳模型的 deletion recall 仅 71.7%,且 92% 的需删除代码能被文件级定位,但仅有 52% 精确到行。
- Guard-and-Go 泛滥:29.0% 的通过补丁采用 条件跳过或默认回退 来回避真正删除,这些补丁能通过测试仅为原有测试不检查旧代码是否残留。
- 测试覆盖盲区:加入 F2P 删除测试后,四个前沿模型的 通过率从 63.2% 骤降至 41.9%,证明标准测试集严重低估了删除行为的重要性。
- 纯删除任务仍困难:在 CanItDelete 上,最好模型仍失败 20% 的任务,小参数量开源模型仅成功 18.0%;即使提示指明精确行号,成功率也仅升至 80.5%,此时错误转为过度删除或误增新代码。
- 后训练可干预:在微调中加入删除示例后,模型的不完全删除减少,但 范围保持(scope preservation) 能力仍恶化,提示该行为是训练不足而非不可达。
与基线对比深度解读
基线本质是完全匹配开发者意图的 delete 操作。现有评估以 test-pass@k 为核心,但实验揭示:模型补丁通过测试 ≠ 完成预期删除,其补丁维护性劣化源于系统性的删除规避。对比同类代码修复评测(如 SWE-bench、HumanEval),本研究首次量化了删除回避的规模与模式,并指出仅靠提示工程(即使提供行号)不足根治;删除能力需纳入训练目标。这为代码智能工具的评估体系引入新维度:必须从“能否通过测试”转向“能否保持代码简洁并真正删除冗余”,否则将积累技术债。
行业影响
落地场景
该方法直接作用于 AI 辅助编程 和 自动化代码修复 产品。
- 智能代码审查:集成到 GitHub Copilot、Cursor、Codeium 等工具中,在生成补丁后自动检查是否真正移除了目标函数 / 变量,而非通过
if False:或try-except等 Guard-and-Go 模式绕开。 - 自动化漏洞修复:在安全修复场景(如删除危险 API 调用)中,确保模型不会遗留可被攻击者利用的旧代码路径。
- 重构辅助:协助开发者彻底移除废弃功能,防止代码库因“软删除”而膨胀。
商业价值
- 降低技术债务:研究表明 29.0% 的通过补丁只是把问题代码包裹而非移除,导致长期维护成本攀升。采用该技术可减少隐式技术债,降低宕机风险——在金融交易或医疗系统中,一条未删除的旧鉴权逻辑可能引发严重事故。
- 提升开发者效率:模型能准确删除时,工程师无需手动清理残留代码,每次修复可节省数十分钟审查时间。
- 强化测试有效性:结合 failure-to-pass (F2P) 测试,将缺失删除暴露为测试失败,倒逼补丁质量,减少因不完整补丁导致的二次修复成本。
与现有产品 / 工作流的接口
- CI/CD 流水线:将 CanItDelete 评估器 作为 gate,检测 PR 中生成补丁的删除召回率,低于阈值则自动拒绝合并。
- IDE 插件:在 Copilot 或 Cursor 生成补丁后,实时高亮未被删除的目标代码,并提供一键清理建议。
- 训练数据生产:将该方法用于数据筛选,优先采集包含完整删除操作的高质量 commit,减轻模型在 post-training 中的 删除回避 倾向。
具体用例
- 电商支付系统修复:某支付网关升级需要移除旧费率计算函数
calculate_legacy_fee()。AI 生成的补丁若用if legacy_mode: return calculate_legacy_fee()包覆,而非真正删除调用,可能导致双计费或审计失败。接入该评估后,系统可强制要求补丁中不再出现该函数符号,避免资金风险。 - 云基础设施配置管理:自动化工具移除废弃 IAM 角色时,若仅注释掉角色声明而未删除绑定关系,可能造成权限残留,被误用于横向移动。采用删除感知的补丁验证,能确保资源定义与引用同步清理,维持安全基线。
局限
- **后训练干预的规模与泛化性有限。** 论文仅在一款模型上进行了概念验证实验,未在更大参数规模或不同架构的模型上验证删除教学的效果,因此尚不能断定该策略可普遍降低删除回避倾向。此外,**CanItDelete** 基准虽然从真实提交中挖掘了 200 个纯删除任务,但其覆盖的编程语言和项目领域有限,可能遗漏了特定生态下删除需求的复杂性,降低了结论的通用性。
- **评估体系可能高估或低估实际删除行为。** 改造的 **Fail-to-Pass (F2P)** 测试用于检测缺失删除,但测试构造依赖于人工判断,可能不能捕捉所有必要的删除逻辑;同时,**Guard-and-Go** 模式的分类仅聚焦于控制流保护,其他变相的代码保留方式(如注释、条件编译)未被充分覆盖。另外,删除回避的根本原因(例如预训练语料中删除操作的比例偏低)仅被推测为“欠训练”,缺乏归因分析,限制了根治性改进的方向。
- **解决方案的创新层级较低。** 虽然首次系统命名并度量了删除回避,但缓解手段仍以提示词工程和后训练数据增强为主,未提出新的模型架构或训练范式。与一些端到端代码编辑模型(如 CodeBERT-based 补丁生成)相比,该工作更像诊断工具而非重构方案。此外,**CanItDelete** 只考虑纯删除任务,现实场景中删除往往与新增代码耦合,其外部效度仍需在混合编辑的异构基准上验证。