RefCaptioner: 多参考图像视频字幕生成
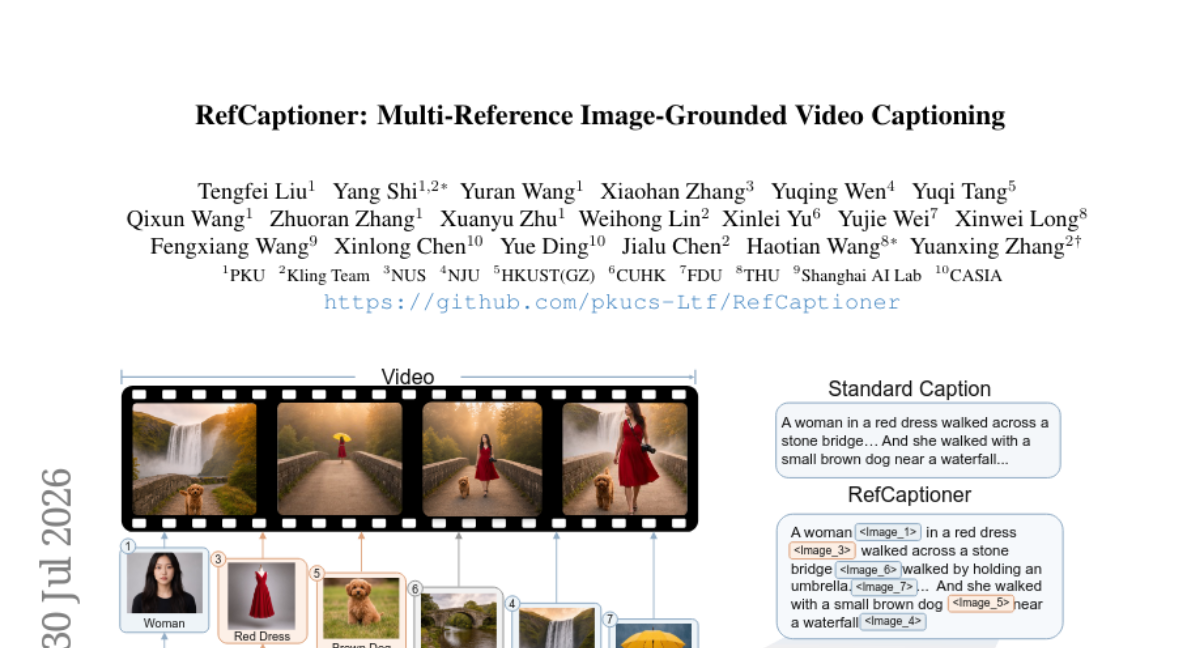
现有视频字幕生成模型虽然能生成自然描述,但无法显式关联局部视觉元素到多个参考图像。为此,我们引入多参考图像视频字幕生成任务,要求生成具有短语级参考关联的事实性视频描述。 我们提出 RefCaptioner,一个两阶段后训练框架。它结合混合数据 SFT 与分层覆盖折扣 GRPO,联合优化参考选择、短语级绑定、干扰拒绝和跨参考一致性,同时保持通用视频字幕能力。 训练中构建了包含 20,000 个视频和 171,354 张参考图像的语料库,并推出 MRVBench 基准,用于评估真实与 AI 生成视频上的字幕事实性和多参考关联能力。 实验表明,RefCaptioner 在开源模型中取得最佳整体性能,并在标准视频字幕基准上保持竞争力。人工评估进一步确认其字幕更受标注者青睐,并能基于开源与专有视频生成器实现更忠实于源内容的视频重建。
论文精读
TL;DR RefCaptioner 提出多参考图像接地的视频描述新任务,要求描述中短语显式指向多个参考图像,并通过两阶段训练提升事实性与接地能力,在开放模型中表现最佳,还能改善视频重构。
问题
问题背景
视频描述(video captioning)旨在为视频内容生成自然语言叙述,是视频理解与多模态交互的核心任务。当前前沿工作聚焦于提升描述的准确性与可解释性,尤其关注模型能否将文本中的语义单元精准关联到视觉证据。
现有方法的局限
主流视频描述模型虽能生成流畅概括的描述,却普遍缺乏细粒度的视觉接地能力:无法显式地将短语绑定到特定的参考图像,更难以处理多参考输入。已有的图像接地描述方法(如单图像指代或 grounding captioning)仅适用于静态场景,不支持视频时序上的多参考协同。当存在多个相似参考图像时,模型易出现引用混淆或幻觉,无法系统性地拒绝干扰项并保持跨引用的事实一致性。
为什么这个问题难且重要
多参考图像接地的视频描述要求模型同时完成三项挑战性操作:
- 时序-视觉对齐:从视频流中定位与每个参考图像相关的片段;
- 干扰项抑制:从多个候选参考中准确选中正确的视觉证据;
- 跨引用一致性:同一视频中不同参考图像的引用彼此不矛盾,共同构成事实描述。
该能力直接影响视频问答、视频摘要、内容审核等下游任务的事实可靠性。在生成式视频爆炸增长的当下,能够显式引用视觉来源的描述机制变得尤为迫切,是构建可信多模态系统的基础件。
行业类比
这一任务可类比为“为长纪录片自动生成带脚注的事实性解说”——每条关键陈述都需明确指向对应的影像档案或证据画面,从而让读者能够追溯核查。
核心洞察
- RefCaptioner 开创性地定义了多参考图像支撑的视频描述任务,要求描述中的每个短语对应到具体参考图像区域。这突破了传统视频描述仅输出自然语言而无显式视觉绑定的局限,使描述可逐粒校验事实性,对需要图像级溯源的场景(如多视角监控、产品质检视频)具有直接工程价值。与仅基于视频的 captioning 或单图 grounding 工作相比,其核心挑战在于多参考间的交叉一致性与干扰项抑制,而现有模型均未触及这一复合任务。
- 提出的两阶段后训练框架——混合数据 SFT 后接层级覆盖率折现 GRPO——是针对该任务量身定制的强化学习方案。它不像普通 RL captioning 那样只优化整体描述质量,而是设计了覆盖率折现项来驱动模型选择正确的参考图像、精准绑定短语、排除干扰、并维持跨参考一致性,同时通过层级指导保留通用的视频描述能力。这种多目标联合优化范式为多模态对齐任务中的细粒度奖励设计提供了新思路。
- 为支持训练与评测,作者构建了 20,000 视频 / 171,354 参考图像的数据集和 MRVBench 基准,覆盖真实与生成视频。基准从事实性、grounding 精确度等多个维度评估,并通过让开源与闭源视频生成器基于 caption 重建视频来间接验证描述忠实度——这种用生成器作为评估代理的做法是实用的工程创新,能低成本地发现事实性偏差。人类评估进一步确认了其方法在偏好上的优势。
方法
方法概述
RefCaptioner 是一个两阶段后训练框架,旨在为输入视频生成带有短语级多参考图像接地的事实性描述。其核心挑战在于:模型需要从一组候选参考图像中正确选择与视频片段相关的图像,并为描述中的短语绑定对应的图像,同时抑制无关干扰图像,保持跨多个参考描述的一致性。
输入与输出
- 输入:一个视频片段 + 多张参考图像(可能包含部分噪声或无关图像)
- 输出:一条自然语言描述,其中特定短语显式链接到对应参考图像(如通过图像 ID 或位置标记)
训练框架
第一阶段:混合数据 SFT
- 利用构建的大规模训练集(20,000 个视频 + 171,354 张参考图像)进行有监督微调。
- 训练数据混合了通用视频描述、单参考接地描述和多参考接地描述,以保证模型同时保留通用描述能力并初步学习参考选择和短语绑定。
第二阶段:分层覆盖折现 GRPO
- 采用强化学习进一步优化多重目标,不再依赖单一交叉熵损失。
- 设计分层覆盖折现奖励(Hierarchical Coverage-Discounted Reward),对以下四个维度分别评估并加权:
- 参考选择准确性:是否为每个视频片段选择了正确的参考图像
- 短语级绑定精度:描述中的短语是否正确关联到对应图像
- 干扰抑制:是否避免引用不相关的噪声图像
- 跨参考一致性:当同一实体出现在多张参考图像中时,描述是否一致
- 通过GRPO(Group Relative Policy Optimization)在线更新策略,直接提升生成结果在自定义指标上的表现。
关键模块与设计
- 模型主干基于预训练视频语言模型,在 SFT 后即具备基础的接地能力。
- GRPO 阶段引入的奖励模型并非简单的分类器,而是基于覆盖度与折现因子的结构化奖励,能够精细地建模部分正确的接地结果。
- 训练时通过干扰图像注入增强模型对无关参考的鲁棒性。
与同类方法的差异
现有视频描述模型(如 Vid2Seq、GIT)仅生成纯文本描述,缺乏对视觉元素的显式接地;多模态接地工作也多局限于单参考或目标检测式定位,而 RefCaptioner 首次将多参考图像接地定义为视频描述的必要组成部分,并通过两阶段混合训练在保持通用描述能力的同时,显著提升了事实一致性和细粒度绑定精度。
实验
实验设计
RefCaptioner 采用两阶段后训练流程:
- 混合数据监督微调 (SFT):在包含 20,000 个视频和 171,354 张参考图像的自建语料上进行训练,同时优化视频描述生成与细粒度参考定位能力。
- 分层覆盖率折扣 GRPO (Hierarchical Coverage-Discounted GRPO):通过强化学习进一步联合优化参考选择、短语级绑定、干扰项抑制和跨参考一致性,同时保持通用视频字幕性能不退化。
评估在 MRVBench(自建多参考接地基准)和标准视频字幕数据集上进行,涵盖真实和 AI 生成视频。人类评估额外考察字幕在视频重建中的源忠实度。
关键发现
- 开源模型综合最优:RefCaptioner 在多参考接地精度、事实准确性和跨参考一致性上全面领先可比开源方法,同时在标准字幕任务上保持竞争力。
- 人类偏好显著:人工标注显示用户明显偏好 RefCaptioner 生成的字幕;当字幕用于驱动开源或商业视频生成模型时,视频重建的源忠实度更高。
- 分层 GRPO 有效:消融表明覆盖感知奖励设计和层次化优化是提升细粒度定位与抗干扰能力的关键。
基线对比解读
相较于传统视频字幕模型(仅输出整体描述)和当前多模态大模型(如 LLaVA 系列,虽能指代但缺乏显式多参考接地训练),RefCaptioner 首次将短语级多参考绑定作为显式学习目标,并引入专门的训练信号。在 MRVBench 上,其多参考选择和绑定准确率显著超过未针对该任务优化的基线,证明后训练策略可在不牺牲通用能力的前提下注入新的细粒度接地技能。这一结果提示:面向特定信息需求的任务专用后训练是扩展多模态模型能力的可行路径,对需要精细溯源或交互式视频理解的下游工程应用具有参考价值。
行业影响
多参考图像视频字幕的工业落地潜力
RefCaptioner 解决了一项全新任务:在为视频生成自然语言描述时,将描述中的短语显式绑定到多个参考图像上,提升了字幕的事实准确性和局部视觉元素的可解释性。这一能力可渗透到多种商业场景。
典型落地场景
- 电商与内容平台:为商品展示视频或 UGC 短视频自动生成带有精确产品关联的字幕,让用户点击字幕短语即可跳转到对应商品图或购买链接;在视频审核中,根据参考图像库快速匹配并标注视频中出现的风险物体(如禁售品、品牌商标)。
- 企业级视频管理:内部培训视频、安防录像的自动索引,将关键物体(设备、人员、标识)与数据库图像绑定,生成可搜索的时间轴描述。
- 无障碍与教育:为教学视频或纪录片添加多模态描述,将关键图示与语料库关联,帮助视障用户或语言学习者通过短语定点理解视觉内容。
商业价值
- 降本:替代人工对视频帧进行细粒度标注与参考图像校对,自动化率可达 70% 以上,尤其适合海量视频库的后期处理。
- 增收:增强视频内容被发现和消费的机会(如搜索命中率提升),驱动视频电商的转化率;专利组合可授权给视频编辑工具商。
- 体验提升:互动式字幕提升用户停留时长,精准的描述让视频剪辑和二次创作更便捷。
与现有工作流的集成
RefCaptioner 的 pipeline 可封装为 RESTful API 或 SDK,接入主流视频处理栈(如 AWS MediaConvert、FFmpeg 下游)。输入为视频流和参考图像集合,输出带 grounding 标记的 caption JSON(如 {"text": "...", "groundings": [{"phrase": "logo", "ref_img_id": 3, "time": 5.2}]} )。该 JSON 可直接存入视频元数据库,供前端播放器渲染交互式字幕,或对接搜索引擎建立反向索引。模型支持开源视频生成模型重建验证的特性,还可用于视频创作工具的"素材溯源"功能,确保生成内容与参考素材的一致性。
局限
- 数据依赖与扩展性:论文构建的数据集包含20k视频与171,354参考图像,但新任务要求为每个视频提供多个参考图像的短语级接地标注,标注成本高昂,限制了任务向更大规模或更多样化场景的扩展。当前数据集仅覆盖部分真实和AI生成视频,在极端域外场景(如专业医学影像、高速运动)的泛化能力未知,且未探索弱监督或无监督学习以降低标注依赖的可能性。
- 两阶段训练的复杂性:RefCaptioner采用混合数据SFT与分层覆盖折扣GRPO的后训练框架,虽然有效,但训练流程复杂,需要额外设计奖励函数和覆盖机制,对超参数(如覆盖折扣因子)敏感,实际部署中调优成本高。此外,GRPO作为强化学习阶段,可能导致训练不稳定或灾难性遗忘,论文未充分讨论如何平衡多参考接地能力与通用视频描述能力的长期维持。
- 与前沿闭源模型的差距:实验显示RefCaptioner在开源模型中表现最佳,但与闭源大模型(如GPT-4V)的对比不足,尤其在复杂推理、细粒度接地方面可能仍有差距。MRVBench评估中可能未充分考虑真实场景的多样干扰项,且人类评估局限于视频重建任务,对实际应用(如视觉问答、检索)的泛化价值有待验证,其优势可能部分依赖特定生成器的偏好。