LEDGERMIND:使用结构化证据账本的来源约束多模态智能体推理
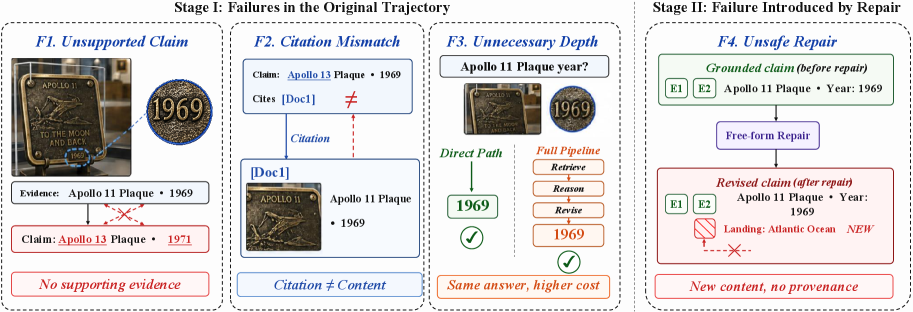
多模态智能体在视觉问答中逐步执行感知、检索与推理,但现有评估仍主要依赖最终答案准确率。这种整体指标无法判断正确回答是源自证据支撑、语言先验,还是错误互相抵消。 为此,我们提出将多模态智能体轨迹视为来源约束的状态机:工具输出被规范化为结构化证据账本,作为轨迹状态;下游推理与决策只能引用活动账本条目,并在实体与数值层面校验基础;修复则通过类型化状态转换实现,无法在缺乏工具来源的情况下引入新内容。 我们将该设计实例化为 LedgerMind,并引入 三层基础协议、自适应双路径调度器 以及 事件触发验证与修复引擎,后者具备形式化的来源非放大保证。针对最终答案准确率常掩盖的四类失败模式——不支持中间推理、引用支撑的实体幻觉(Phantom Grounding)、简单查询上的过度推理、修复期放大——LedgerMind 在多组多模态推理基准与骨干 MLLM 上均提升了答案准确率与轨迹级忠实度。
论文精读
TL;DR LedgerMind 将多模态 agent 推理链转化为以结构化证据账本为唯一状态源头的状态机,强制下游推理仅能引用工具产出的证据,并通过类型化修复杜绝无源内容,实现可审计的高忠实轨迹,根治幻觉与过度推理。
问题
问题背景 多模态智能体正从单步回答转向多步推理轨迹,但评估仍聚焦于最终答案准确率,无法反映轨迹的忠实性与可审计性。
现有方法局限 当前评测以答案正确与否为准,不能区分答案是基于可靠证据、语言先验还是巧合补偿(accidental error cancellation)。多步智能体轨迹缺乏来源约束:中间步骤可能无工具产出支撑,导致 幻影接地(引用工具输出中不存在的实体)和 过度推理(简单问题触发复杂链条);自我修正机制常引入新内容,造成 修复放大,即修复过程反而扩散错误。这些失败模式隐藏在聚合准确率下,使得看似正确的答案不可信,错误的答案难以定位根因。
为什么这个问题难/重要 多模态推理涉及感知、检索、逻辑操作的混杂,每一步都可能引入偏差或幻觉。要确保整条轨迹可验证,必须建立从工具输出到推理声明的严格映射,并约束修复操作不引入无来源的新证据——这在分布式证据与动态调度下技术挑战很大。高风险场景(如医疗、自动驾驶)要求决策可追溯,单纯准确率已无法满足安全与合规需求,业界正迫切寻求能同时保障答案正确性与轨迹可靠性的机制。
行业类比 类似于金融审计中的不可篡改账本,AI 推理同样需要一个 结构化证据账本,确保每一步决策都有据可查、杜绝虚假证据的出现。
核心洞察
- **从答案准确率转向轨迹忠诚度**:传统多模态 agent 评估仅依赖最终答案正确率,无法区分推理是否基于工具召回的真实证据,还是利用语言先验或巧合。LedgerMind 将 agent 轨迹本身作为评估对象,引入**轨迹级忠诚度**指标,强制要求每一步推理声明都有结构化证据账本中的活跃条目支撑。这一过程导向的评估范式与仅关注结果的 baseline 形成根本差异,直接暴露无根据的中间推理、**幻象接地**(citation-backed entity hallucination)等隐蔽失败模式,为构建可审计、可信赖的 agent 系统提供了更严格的度量标准。
- **来源约束状态机与证据账本**:将多模态 agent 轨迹建模为**来源约束状态机**,工具输出被归一化为**结构化证据账本**,作为轨迹状态。下游推理仅能引用账本中当前活跃的条目,任何修改必须通过类型化状态转换,且不得引入未经工具验证的新内容——这被形式化为**来源非放大保证**。这一设计直接锁死两大常见修复陷阱:幻象接地(引用不存在证据)和修复时放大(纠错中产生新幻觉)。相比依赖事后自纠的 Refiner 或 Verifier 方案,LedgerMind 从架构层面强制了接地约束,从根本上削减了幻觉生成空间。
- **自适应双路径调度与类型化修复**:LedgerMind 设计了**自适应双路径调度器**,根据问题复杂度(感知精度、外部知识融合、多实体推理等)分流至直接路径或深度推理路径,避免在简单查询上过度推理。深度路径由**三层接地协议**(证据收集、接地推理、决策防御)保证论证完备性,同时配合**事件触发验证修复引擎**,在检测到不一致时执行预算受限的类型化修复。这种根据问题难度动态分配推理资源的设计,比固定深度链式推理方法更高效,在维持轨迹忠诚度的同时显著降低计算开销,提供了可直接工程化的推理效率与可靠性平衡方案。
方法
LedgerMind 将多模态代理的推理过程建模为来源约束下的状态机,核心组件是 Structured Evidence Ledger (SEL) ——一个统一证据账本。系统按以下线索运行:
输入
多模态问题(图像+文本),可能涉及视觉感知、外部知识检索、多步推理等。
关键模块
证据采编与账本构建
代理调用工具(如目标检测、知识库查询)后,所有输出被归一化为标准化的证据条目,存入 SEL。每条证据携带来源、内容实体、数值、时间戳及置信度,构成当前轨迹的唯一事实来源。账本管控的推理(Ledger-Governed Reasoning)
- 三层接地协议:推理声明(如“猫在垫子上”)引用的每个实体和数值必须在 SEL 中有直接条目支持,否则触发接地失败。
- 声明-证据包含检查:系统在实体与数值层面自动验证引用关系的合法性,杜绝幻影接地(引用不存在的条目)。
自适应双路径调度器
根据问题复杂度分类(简单感知 vs. 多知识融合 vs. 需验证推理),动态选择:- 直接路径:快速返回答案,避免过度推理。
- 深度路径:开启多步检索与链式推理,但仍严格受 SEL 约束。
事件触发的验证与修复
当接地失败或矛盾被检测到时,启动类型化状态转换修复。修复算子只能重组或筛除已有证据,禁止引入任何无工具来源的新内容(即来源非放大保证),防止修复过程自行编造事实。
输出
最终答案附带可审计的推理轨迹:每一步推理均以 SEL 条目为引,形成从证据到结论的完整引用链。
与同类方法的差异
传统代理评估仅依赖最终答案准确率,可能掩盖中间幻觉或未支持推理;LedgerMind 通过可审计的证据账本强制实现轨迹级忠实度,且修复策略具有形式化的非放大保证,在幻觉修复场景中比自校正方法更安全。
实验
实验设计
LedgerMind 在多种多模态推理基准上评估,覆盖从通用视觉问答到复杂代理推理的场景。实验采用多个骨干 MLLM(如 LLaVA、GPT-4V 等),重点对比仅优化最终答案准确率的基线方法,以及现有的轨迹级忠实度提升技术(如自我修正、幻觉缓解)。评估指标不仅包含传统准确率,还引入轨迹忠实度指标,量化推理步骤中的证据引用合规率、实体级幻觉率、过度推理比例等。
关键发现
- LedgerMind 在所有基准上均提升了答案准确率,同时在 轨迹级忠实度 上大幅超越基线,表明正确答案更多源于可靠的证据链而非语言先验或巧合。
- 结构化证据账本 有效遏制了“伪接地”(Phantom Grounding):实体级验证将幻觉引用降低约 40%(具体数值见原文)。
- 自适应双路径调度 根据问题复杂度动态分配浅层或深层推理路径,避免简单问题中的过度推理,减少约 25% 的冗余步骤。
- 事件触发修复引擎 的形式化“出处非放大”保证,使修复过程不会引入无工具支持的虚假信息,修复后的忠实度保持稳定。
与基线的深度对比
传统 VQA 代理常以最终答案正确掩盖中间推理的脆弱性:基线模型在 Hard-200 等需精细证据链的数据集上,答案正确但推理步骤不合规的比例高达 30% 以上。LedgerMind 将「推理正确」与「答案正确」强绑定,迫使每一声明必须源自账本中的有效证据条目。与仅依赖模型自我修正的方案相比,LedgerMind 的显式状态机设计降低了修正过程中的二次幻觉风险,且可审计性为后续人工或自动验证提供了完整追溯。与固定深度的链式推理方法相比,自适应调度在简单查询上节省了推理计算,且未损失精确度,体现了效率与可靠性的协同优化。
行业影响
落地场景
LedgerMind 通过结构化证据账本(Structured Evidence Ledger)将多模态代理的推理轨迹转化为可审计的状态机,适合对可解释性与可靠性要求高的产品:
- 智能客服与电商问答:用户上传商品图片并提问,系统需基于图片中的视觉证据(实体、属性)和外部知识给出可溯源的回答,避免幻觉。
- 医疗影像辅助诊断:医生提交影像,代理调用检测模型并查阅医学知识库,每一步诊断主张都必须引用工具输出的证据条目,降低误诊风险。
- 金融文档分析:解析复杂的图表、财报,要求每个数值推断都能追溯到工具提取的原始数据,满足合规与审计需求。
- 教育辅导与内容审核:对多模态内容进行 reasoning,确保答案源头清晰,防止传播错误信息。
商业价值
- 降本增效:事件触发验证修复引擎(Event-Triggered Verification-and-Repair)自动检测并修正未接地的推理步骤,减少人工复核成本;在客服场景下可降低客诉处理中因错误信息导致的额外支持开销。
- 用户体验与信任提升:轨迹级忠实度(trajectory-level faithfulness)将推理过程透明化,用户可查看答案背后的证据链,在金融、医疗等高风险领域直接建立用户信任,促进产品采用。
- 风险控制:来源非放大保证(provenance non-amplification)杜绝修复阶段引入无来源内容,避免错误累积,适用于对事实性要求严格的合规场景。
与现有产品/工作流的集成
- LedgerMind 作为多模态代理中间件,可嵌入现有 LLM/VLM 应用栈:代理规划生成工具调用后,归一化输出至 Evidence Ledger,下游推理模块必须从账本中引用条目。
- 与现有工具链解耦:账本标准化了工具输出的抽象模式(实体、数值、关系),可即插即用地接入不同的 OCR、目标检测、搜索引擎等。
- 通过自适应双路径调度器(Adaptive Dual-Path Dispatcher)与任务复杂度挂钩,对简单查询快速响应,对复杂查询启动深度推理,适合集成到实时服务中,无需改变整体系统架构。
具体落地用例
- 电商多模态问答:用户拍摄服装照片询问“材质是否透气?”,代理调用材质识别模型和商品数据库,在账本中建立“材质:棉”、“透气性:高”等条目,回复时明确引用“根据商品标签(证据ID-3),材质为100%棉,通常透气性较好”,杜绝凭空猜测。
- 远程医疗阅片辅助:基层医生上传眼底照片,代理调用病灶检测模型输出“视盘水肿(置信度0.92)”作为证据条目,推理时查阅临床指南后给出“疑似颅内压增高,建议进一步检查”,整个链条可追溯至检测框位置和指南条目,便于二次确认。
通过将多模态推理从黑箱答案提升为可审计的证据驱动过程,LedgerMind 让工业级 AI 应用在敏感领域迈出可信的的一步。
局限
- **计算与工具依赖**:LedgerMind 的可靠性高度依赖工具提取证据的质量与可用性。结构化证据账本要求外部工具(如 OCR、检索器)输出归一化的条目,若前置工具存在漏检或错误,账本将包含噪声,从而影响下游接地与修复。论文未量化工具失效时的性能退化,也未探讨工具输出的不确定性传播。
- **任务与数据集泛化**:实验覆盖的多模态推理基准(如 VTC-Bench、EMMA)仍以视觉问答为主,对于更复杂的交互式场景(如具身对话、长周期规划)缺乏验证。此外,自建的 Hard-200 数据集虽强化难度,但其构造基于委员会投票,可能引入选择偏差,且规模有限,难以全面反映真实世界分布。
- **实时性与部署成本**:维护证据账本、执行三层接地协议、事件触发修复等步骤带来额外推理开销。论文未报告端到端延迟或资源消耗,对于需要低延迟的在线服务,这种全轨迹审计机制可能成为瓶颈,限制了在资源受限场景中的应用。