Fairness Pruning: 通过差分激活定位 GLU-MLP 层中的人口统计偏见
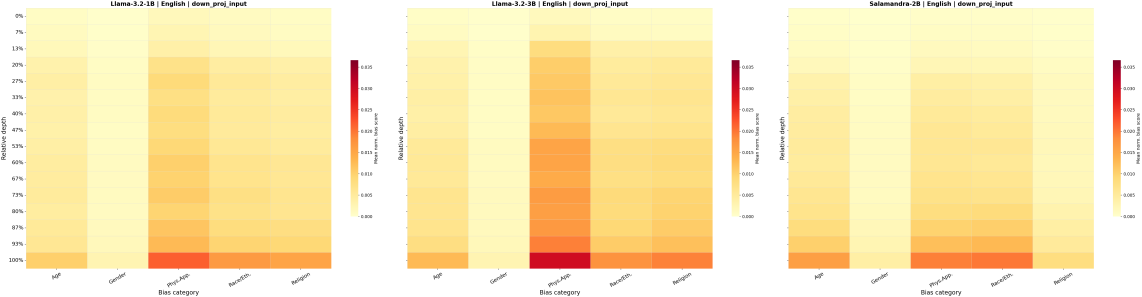
Fairness Pruning 是一种轻量级结构化干预方法,旨在管理和缓解大语言模型(LLM)中的人口统计偏见。作为该方法的实证验证基础,本文聚焦于因果偏见定位:使用最小对比提示对并在推理时捕获激活,识别 GLU 架构中处理人口统计属性时产生差异反应的神经元,并在 downproj 输入端评估信号。 实验在最高 30 亿参数 的模型(Llama-3.2 系列和 Salamandra-2B)上进行,结合标准化基准评估与定性文本生成实验。结果表明,将识别出的神经元置零会改变模型对相关人口统计变量的响应方式。然而,干预并未产生单向缓解,而是引起双向偏见失稳:由于 BiasScore 无符号,候选集混合了推动和抵制刻板印象的神经元,对总体偏见的净效应取决于哪一方向占主导。 干预具有极高的外科手术式精准度:在 Llama-3.2-1B 中置零至多 40 个神经元(不到总 MLP 宽度的 0.031%),即可保持 99.49% 的推理和通用知识能力。这些发现实证确认,人口统计偏见处理与模型能力运行在可分离的电路上,为从盲目标零转向方向性行为调制奠定了方法论基础。
论文精读
TL;DR 通过对比提示对的微分激活,精确定位 GLU-MLP 层中的偏见神经元;仅零化 ≤40 个神经元(<0.031% 参数)即可干预偏见,保持 99% 推理能力,证实偏见与能力回路可分离。
问题
问题背景
大语言模型(LLMs)在广泛部署中暴露的人口统计偏差(demographic bias,如性别、种族刻板印象)已成为可信AI 的核心关注点,研究者正试图从模型内部定位并干预这些偏差,而非仅依赖外部后处理。
现有方法的局限
当前主流策略存在明显不足:
- 数据层面:过滤或合成数据易导致分布偏移,且需要大量计算资源,无法从根本上消除模型已内化的偏差。
- 微调层面:RLHF/DPO 等方法依赖昂贵的人工偏好标注,只能间接抑制偏差,常以牺牲通用能力为代价,且无法定位偏差来源。
- 表征编辑:如通过线性方向进行激活操控 (activation steering),需预先定义偏差方向,缺乏因果验证;它们往往作用于粗粒度子空间,无法区隔真正驱动偏差的稀疏神经元。
- 机械解释性:虽能提供因果证据,但现有方法高度依赖人工分析,难以扩展到数十亿参数模型。 这些方法或过粗(影响整体行为),或依赖强先验假设,无法实现“只移除偏差而不伤能力”的精准干预。
技术挑战与行业重要性
实现精准偏差定位存在双重挑战:
- 混合信号问题:在GLU-MLP 架构中,偏差相关神经元的激活既有正向(强化刻板印象)也有负向(抑制刻板印象),其净效应取决于符号主导。基于无符号评分(如
BiasScore)选取神经元时,正负向神经元可能混杂,导致干预后偏差出现双向不稳定——这是现有方法普遍忽视的因果复杂性。 - 能力-偏差解耦:需证明偏差处理与通用推理能力使用可分离的电路 (dissociable circuits),要求定位方法具有极高的稀疏性和选择性;否则对极少参数(如<0.03% 的 MLP 宽度)的扰动也可能引发能力雪崩。 业界对可解释且轻量的偏差审计工具需求迫切,高风险应用(如招聘、信贷、医疗对话)的法规遵从要求模型决策可追溯、可干预。
行业类比
类似在推荐系统中精准干预某类偏见特征(如对特定创作主体的系统性低估),而不影响整体排序质量与多样性——要求干预像手术刀般精确,仅触及极少数关键神经元。
核心洞察
- 偏差电路与通用能力在神经元级别高度可分离,为精确定向干预提供实证基础。与依赖全模型微调或大规模提示工程的主流去偏方法不同,Fairness Pruning 通过差分激活在 GLU-MLP 的 down_proj 输入处定位偏差神经元,仅零化最多 40 个单元(不足总 MLP 宽度的 0.031%)即可明显改变模型的偏差响应,同时推理和常识能力保留均值 99.49%。这证实了 LLM 中的偏差并非遍布全链路,而是浓缩在极少数可解释的神经元子集中,为开发超低侵入性的公平性管理工具开辟了新范式。
- 无符号偏差评分导致剪枝效果的方向不确定性,暴露了当前基于激活幅度的定位方法的根本局限。论文指出 BiasScore 未带方向,以致选出的神经元集合混合了“助推”与“抑制”刻板印象的单元,零化后偏差可能上升、下降或不变,取决于两种方向的主导比例。这一发现直接挑战了盲目消融高激活神经元的简单逻辑,表明要实现可控的偏差缓解,必须引入带符号的电路级因果分析,从单纯的“定位-消除”转向“定位-调制”,为下一代公平性干预工具的设计提供了重要方法论警示。
方法
方法流程
输入阶段:构建最小对比提示对(minimally contrastive prompt pairs),每一对仅在人口统计属性(如性别、种族)上存在差异,其余上下文完全一致。例如:“The nurse said that [he/she] would be back soon.” 这些提示对在推理时分别送入目标大语言模型(LLM)。
关键模块——偏见神经元定位:
- 激活捕获:对于每一层 GLU-MLP(如 Llama-3.2 或 Salamandra 中的结构),在
down_proj输入处采集神经元激活值,该位置能反映经门控线性单元变换后的信息流。 - 差分激活计算:针对每个神经元,计算其在含有不同人口属性提示下的激活差异,取其绝对值作为 BiasScore。该分数衡量神经元对属性变化的敏感程度,而不区分偏差方向。
- 候选集选择:按 BiasScore 降序排序,选取 top-k 个神经元作为偏见候选集。在 Llama-3.2-1B 中,k 最多为 40(不足总 MLP 宽度 0.031%)。
输出与干预:将选中神经元的输出直接置零(即 Fairness Pruning),无需微调或额外训练。此举会同时削弱“推高偏见”和“压低偏见”的神经元,因为 BiasScore 是无符号的。净效应取决于两种方向神经元的强度对比,从而产生双向偏见不稳定性,而非单一的偏差消除。
与同类方法的差异:Fairness Pruning 是纯推理时、无需梯度的结构性干预,通过极少量神经元的定位即可分离偏见处理与通用能力回路,且不影响模型在知识推理等任务上的表现(能力保留度 99.49%),区别于需要训练或表征编辑的常见偏见缓解方法。
实验
实验设计
Fairness Pruning 在 Llama-3.2(≤3B) 和 Salamandra-2B 上验证其偏见定位能力。核心数据集包括:
- 最小对比提示对(仅人口统计属性变化),用于捕获 GLU-MLP 中
down_proj输入的差异激活 - BBQ/EsBBQ 标准化偏见基准
- 定性文本生成 评估
实验流程:
- 用对比对识别“偏见神经元”(差分激活得分最高的 top-k 神经元)
- 直接零化这些神经元(不微调)
- 测量 BiasScore 变化与通用能力退化
关键发现
- 极度稀疏干预:最多零化 40 个神经元(Llama-3.2-1B 中占比 < 0.031%),即可显著改变模型对人口统计变量的响应
- 能力近乎无损:推理与常识保持率均值 99.49%,验证了偏见回路与功能回路的高度可分离
- 双向偏见动摇:零化后偏见并非单向减轻,因为 BiasScore 无符号,候选神经元集合中同时包含“强化刻板印象”和“反刻板印象”的神经元,净效应取决于主导符号,呈现不稳定重构
与基线及同类方法对比
- 与盲目神经元剪枝 + 微调相比:本方法无需任何训练,仅推理时操作,且定位粒度精确到单个神经元,避免了大规模扰动带来的灾难性遗忘
- 与激活操控(activation steering)相比:差异激活直接定位到 MLP 内部子结构(
down_proj),而非简单在残差流上添加方向向量,提供了更结构化的干预入口 - 启示:偏见缓解不能依赖“归零即干净”的假设,必须考虑方向性;高效且无训练的干预为动态偏见管理提供了工程可行性
行业影响
落地场景
Fairness Pruning 为 LLM 的实时偏见干预提供了手术刀式工具,可直接应用于对公平性敏感的交互式产品:
- 对话式 AI 助手:客服、虚拟伴侣、教育辅导等,避免针对特定人口属性生成刻板印象回复。
- 内容审核与生成平台:自动识别并抑制涉及性别、种族等敏感属性的偏见输出,降低违规风险。
- 组织内部 HR/招聘工具:在简历筛选或面试模拟中,阻断模型对候选人姓名、地域等属性的不公平关联。
- 金融风控与信贷评估:防止模型在文本分析中引入人口统计偏差,影响审批公平性。
商业价值
方法仅需零化最多 40 个神经元(占 Llama-3.2-1B 中 MLP 宽度的 0.031%),即可显著扰动偏见信号,同时保留 99.49% 的推理能力,带来三重收益:
- 降本:无需全模型重训练或昂贵的人工复审,可在线动态加载神经元屏蔽列表,节省算力。
- 增收 / 体验提升:减少歧视性回复,提升用户信任与品牌口碑,对国际化产品尤为重要。
- 合规避险:为满足各项 AI 伦理法规(如 EU AI Act)提供可解释、可审计的技术方案,降低法律风险。
与现有产品/工作流的集成
该方法定位在模型的 GLU‑MLP 层(down_proj 输入),无需修改架构,集成方式灵活:
- 推理框架插件:在 forward 过程中注入 hook,根据预计算的神经元 ID 表对激活进行掩码,可作为中间件嵌入 vLLM、TGI 等推理引擎。
- MLOps 管道自动化:结合持续偏见监测(如 BBQ/EsBBQ 基准),当检测到特定偏见漂移时,自动触发 Fairness Pruning 校准,更新掩码列表并部署。
- 可解释性仪表盘:将定位到的神经元高亮在模型激活可视化工具中,供审计员审查偏见回路。
具体落地用例
- 社交媒体内容安全:某平台在评论审核模型中,对“女性+职业” prompt 触发的高
BiasScore神经元进行零化,防止系统自动标记“女性不适合 STEM”等侮辱性内容,实现更公平的审核策略。 - 智能招聘系统:OCR 解析简历后,LLM 对候选人进行初步匹配分析。应用 Fairness Pruning 屏蔽对不同族裔姓名产生差异化激活的神经元,确保推荐的公平性,可配合差分隐私审计。
局限
- **偏差影响的方向性不可控**:方法识别出的神经元集合包含同时“推动”和“对抗”刻板印象的神经元,归零后净效果取决于正负信号的相对强度。这使得干预结果不可预测,无法保证偏差缓解,甚至可能导致偏差加剧。作者称此为“双向偏差不稳定”,本质上是因为偏差得分(BiasScore)仅度量反应差异的大小,不区分方向。因此,当前方法更适用于定位偏差相关电路,尚不能直接作为偏差缓解工具,需要后续开发定向调节策略。
- **实验规模与模型的泛化性有限**:实验仅在 Llama-3.2(最高3B参数)和 Salamandra-2B 上进行,均为中等规模模型。对于更大的模型(如7B、13B、70B),GLU 层的维度和偏差电路的分布可能显著不同,神经元的稀疏性假设可能不成立。此外,只评估了 GLU-MLP 层,未考察注意力头等其他组件在人口统计偏差中的作用,可能遗漏关键处理路径。
- **数据集依赖性强且缺乏跨任务验证**:偏差神经元的定位完全依赖于所使用的对比提示对数据集,不同设计的数据集可能得出不同的神经元集合,方法的稳健性和可迁移性存疑。实验中主要使用 BBQ/EsBBQ 等标准偏差基准测试,但未在其他下游任务(如文本分类、对话系统)中验证剪枝对偏差和性能的影响,实际部署的可行性仍不明确。