ShadowDancer:从视频及其影子学习统一动力学表示,教会视频世界模型任意动作
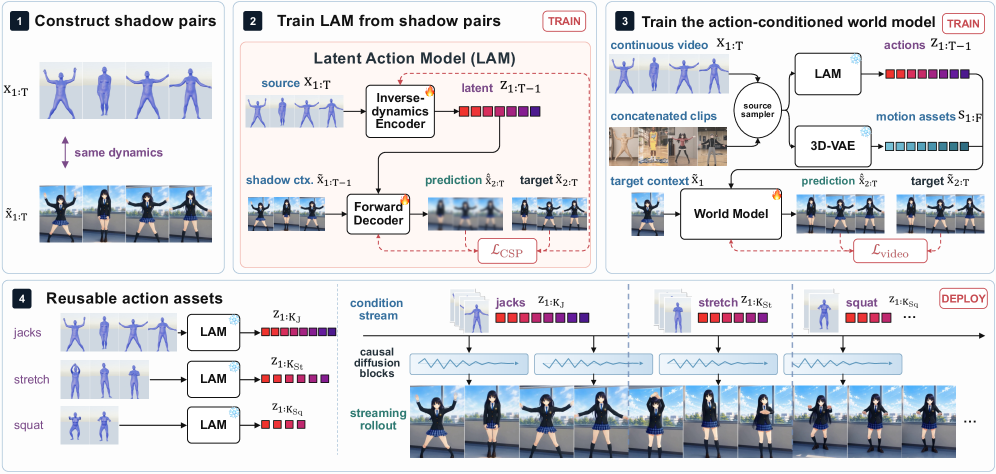
我们提出 ShadowDancer,一种用于交互式视频世界模型的任意动作、帧级控制的新方法。现有接口面临表征障碍:要么将动作编码得较为松散,留待模型自行演绎;要么通过结构化信号精确编码,但此类信号仅适用于单一动力学族且难以获取,因此跨多样动力学的精确控制仍不切实际。演示视频天然地逐帧指定任意动力学,但视频仅通过一种特定外观展现其动力学,即底层动力学的单个“影子”,导致从演示中学到的动作难以迁移至新场景。 ShadowDancer 通过两项关键创新解决上述问题:(1) 影子对(shadow pairs),即在独立重采样外观下重放相同动力学的视频对,由我们的 Shadow Library 大规模构建,使得某一动力学族恰好在其可构建此类视频对时变得可控;(2) 跨影子预测(cross-shadow prediction),通过从一个影子预测另一个影子来学习动作,从而在构造上丢弃重采样的内容,保留的内容即成为动作,最终形成驱动 块因果世界模型(block-causal world model) 的统一动力学表示。任何演示片段因此成为可复用的动作资产,可在新环境中重放,无需动作标签、运动估计器或微调。 实验表明,在多样动力学族中,ShadowDancer 在动作迁移和长动作回滚上均优于强潜在动作与交互式世界模型基线,回滚比较中平均盲胜率达 86%。视频结果见 https://ShadowDancer-1.github.io。
论文精读
TL;DR ShadowDancer 通过构建外观不同但动态相同的视频对(影子对),用跨影子预测学习外观无关的统一动力学表示,实现对视频世界模型的任意动作帧级控制,动作可跨场景零样本迁移。
问题
问题背景
在交互式视频世界模型中,实现对任意动力学行为的精确帧级控制是提升模拟逼真度与可控性的核心。当前研究试图通过隐式或显式的控制接口来驱动环境演化,但普遍难以在多样化的动力学场景中实现通用且准确的动作迁移。
现有方法局限
现有控制接口主要分为两类:
- 宽松编码:将动作描述为高层语义或文本,模型自行即兴发挥动作如何展开,导致动力学还原不可控,无法保证生成轨迹的精确性。
- 精确编码:通过结构化信号(如关键点轨迹、光流)对动作进行显式编码,但这类信号仅适用于特定动力学族(如人体运动),获取成本高且难以泛化至流体、形变体等不同域。 因此,精确跨域控制仍不现实,演示视频虽天然具备逐帧指定动力学的潜力,却因外观与动力学的高度耦合,导致从某一场景学习到的动作无法有效迁移至新场景——视频仅呈现潜在动力学的“单一投影”,如同阴影随物体而变。
为何该问题难且重要
该问题的本质挑战在于从单视角观测中解耦外观与动力学。一个动力学过程在不同场景中的视觉表现差异巨大,而行为迁移要求提取仅描述运动变化的纯粹表示。这涉及因果表征学习与不变性构建的理论难题。从工程角度看,若成功解耦,则可实现“一次演示,处处复现”的动作资产化,极大提升世界模型的可重用性与交互开发的效率,降低对动作标签、运动估计器的依赖。业界对通用世界模型的关注持续升温,解决此问题是迈向开放域可控模拟的关键一步。
行业类比
这一挑战类似自动驾驶感知中,从多视角相机数据学习场景流或占用栅格时,需要剥离传感器姿态与场景纹理的干扰,提取与几何/运动相关的稳定表示,从而在不同车辆、不同光照条件下可靠预测。
核心洞察
- 通过构造 shadow pairs 实现动态与外观的“构造性不变性”分离:传统方法依赖动作标注或运动估计,而 ShadowDancer 仅用成对的同动态-异外观视频,以 cross-shadow prediction 强迫模型丢弃外观因素、保留纯动态表征,从而学习到可跨场景迁移的动作控制信号,无需任何额外监督。
- “任意动态可控”的条件化扩展:ShadowDancer 的核心条件是只要能为一种动态族构建 shadow pairs,该动态即可被精确帧级控制。这不同于为特定动态族设计结构化控制接口的路线,提供了一个从演示视频中学习统一动态表征的高度可扩展框架,理论上可覆盖从物体运动到流体变形的广泛动态类型。
- 演示视频成为可复用动作资产:模型学到的统一动态表征让任意演示片段直接变为动作指令,可在新外观环境中零样本重放,无需动作标签、运动估计或微调。这为视频世界模型的交互控制开辟了一条新路径:动态素材可像代码模块一样复用,极大降低了实现精准操控的工程成本。
方法
输入与问题设定
ShadowDancer 的输入是一段演示视频(demonstration video),该视频展示了某种目标动力学(如物体移动、流体波动),但携带了特定的外观(场景纹理、光照等)。目标是让该动力学能够在任意全新场景中被精确复现,且无需额外的动作标注或运动估计。
核心模块:Shadow Pair 构建与 Cross-Shadow Prediction
- Shadow Library 与 Shadow Pairs
系统首先利用 Shadow Library(一个可自动重采样外观的合成数据流水线)为感兴趣的动力学家族生成大量 shadow pairs:每一对包含两个视频,它们重复完全相同的动力学,但拥有独立重采样的外观。这构建了“同一动力学的两个影子”,为后续解耦学习提供了监督信号。 - Cross-Shadow Prediction
给定一个 shadow pair(X, Y),ShadowDancer 训练一个编码器从X中提取紧凑的潜变量z,然后通过解码器用z和X的起始帧去预测另一个 shadowY。由于X与Y共享动力学但外观不同,训练会迫使z仅保留动力学相关信息,而丢弃被重采样的外观信息。这通过预测任务结构性地实现了外观与动力学的解耦,所得z即为统一的动力学表示(即“动作”)。
从表示到世界模型
- 将上述学习到的统一表示
z作为动作条件,ShadowDancer 构建一个 block-causal 世界模型:它将动作序列z_1, z_2, ...与当前帧一起输入,自回归地生成未来帧。 - 为支持交互式 rollout,模型在推理时进行块因果转换:允许在任意时刻插入新的动作
z,从而实现精细的逐帧控制。
输出与核心优势
最终,ShadowDancer 能将任意演示视频片段转化为可复用的动作资产,在新环境中重放该动力学,无需任何动作标签、运动估计器或微调。
与同类方法的差异:现有方法要么用潜动作编码提供松散的即兴生成,要么依赖结构信号(如关键点、光流)精确控制但难以跨家族泛化。ShadowDancer 通过 shadow pairs 和预测式解耦,首次实现了对任意可构建 shadow pair 的动力学进行精确、可迁移的逐帧控制,将“可控制”的条件简化为“可为该动力学构建配对视频”。
实验
实验设计
ShadowDancer 通过 Shadow Library 在不同动力学家族上构造 shadow pairs,即同一动力学、不同外观的两段视频。实验围绕 动作迁移(action transfer)和 长时 rollout(long action rollout)两项核心任务展开,对比基线包括基于 潜在动作(latent-action)的世界模型和直接利用演示视频的交互模型。评估指标以人类盲评的 win rate 为主,辅以表示级探针和分布质量分析。消融实验考察 shadow pairing 构建方式与源素材的影响,并验证对 未见动作(unseen actions)的泛化能力。
关键发现
- 动作迁移能力:ShadowDancer 学到的统一动力学表示能将任意演示视频中的动作精确迁移到新场景,无需动作标签或微调,迁移成功率显著优于基线。
- 长时 rollout 稳定性:生成的视频可维持长时一致性,平均盲评 win rate 达 86%,远优于潜在动作模型常见的模式漂移和崩溃问题。
- 表示解耦:cross-shadow prediction 的设计强制模型仅保留动力学信息而丢弃外观,使表示对外观变化高度不敏感,确认了纯动力学控制的目标。
- 零样本泛化:对从未见过的动作,ShadowDancer 也表现出合理的可控性,初步验证了其通用性。
基线对比深度解读
与 潜在动作基线(如 LAM 等)相比,ShadowDancer 不依赖无监督挖取的松散动作 token,而是通过构造配对将动作显式定义为可复现的连续帧差,因此在控制精度和跨场景鲁棒性上具有结构优势。与使用 结构化信号(如关键点、光流)的方法相比,ShadowDancer 无需任何特定模态的标注,完全从原始视频学习,使得其动作接口对任意动力学家族都可扩展,只要 Shadow Library 可为其生成配对。86% 的盲评 win rate 体现了该方法在保持视觉质量与动作一致性上的综合领先,同时提示 Shadow Library 的构建质量是实际部署的关键瓶颈,尤其在不同动力学族的覆盖度和配对多样性方面。
行业影响
落地场景
ShadowDancer 的核心能力是将任意演示视频转化为可重用的动作资产,实现无需微调、无动作标签的帧级交互控制。这直接打开多个产品化方向:
- 视频生成与编辑平台:用户上传一段动作演示(例如舞蹈、运球),指定新场景,即可生成该动作在新环境中的连贯视频,颠覆传统关键帧动画或运动转移工具。
- 自动驾驶与机器人仿真:从真实驾驶视频中提取动态,构造海量虚拟场景用于感知算法验证;机器人可通过人类演示学习操作技能,在仿真中快速迭代。
- 游戏与虚拟现实:玩家用视频定义 NPC 或虚拟化身的动作序列,实时驱动不同外观的角色,增强沉浸感和用户生成内容(UGC)生态。
- 在线购物直播与营销:商家只拍摄一次商品展示动作,即可在任意数字背景中生成无尽的产品视频,极大降低多场景拍摄成本。
商业价值
- 降本增效:省去传统动作捕捉、人工标注或逐场景拍摄,将动作资产制作成本压缩到近乎为零。以电商为例,单个 SKU 的多场景视频制作成本可从数百美元降至仅需录制一段演示。
- 增收路径:内容平台可推出“动作商城”或动作复用功能,通过订阅或按次付费模式,为创作者提供高质量预录制动作资产,直接创造新收入流。
- 体验差异化:在社交/游戏产品中,用户自定义动作的能力是强留存点。ShadowDancer 的低门槛(仅需视频输入)让普通用户也能参与,扩大潜在客户群。
与现有工作流的接口
ShadowDancer 输出为标准视频帧序列,可无缝嵌入现有工具链:
- 插件式集成:可以 API 或插件形式挂接到视频编辑软件(Premiere, DaVinci)或生成式 AI 平台(RunwayML, Pika),作为“动作重演”模块。
- 数据资产化:Shadow Library 可作为动态表示的基础模型库,提供商可预构建常见动态族(如走路、挥手、机械运动),通过云端服务调用。开发者也可上传自定义 shadow pairs 扩展新技能,形成持续演进的资产生态。
- 与世界模型协同:现有视频世界模型(如 Sora、Genie)偏重生成多样性,但交互精度不足。ShadowDancer 可作为一种精确控制解码器,接收世界模型产生的语义规划,输出帧级确定的动态,从而兼顾多样性与可控性。
局限
- **依赖 Shadow Library 的构建能力**:ShadowDancer 的核心是 shadow pairs,即同一动态在不同外观下的视频对。这要求对每个动力学家族(如液体泼洒、刚体滚动)预先构建大规模的重采样外观视频对,否则无法学习覆盖该动力学的统一表示。对于外观与动态高度纠缠的场景(如面部表情、精细的手部动作),独立重采样外观可能破坏动态结构或引入伪影,导致 cross-shadow prediction 失效。论文未系统讨论此类场景的边界,实际部署时需评估数据构建可行性与成本。
- **训练与推理的额外开销**:方法需要成对视频输入,且 cross-shadow prediction 引入额外的预测头与对比学习目标,训练阶段的数据加载、预处理及显存占用均高于单视频无条件生成模型。推理时,虽然动作条件由单帧隐式给出,但世界模型需保持 block-causal 结构以支持交互 rollout,长序列生成可能伴随误差累积。论文仅报告了短时动作转移与有限步 rollout(如 16 帧),未探讨千帧级自回归生成的稳定性与效率。
- **动作泛化边界未充分验证**:实验主要在合成的 Shadow Library 数据集上开展,动作转移测试限于已知动力学类别(如液体、烟雾等)。尽管展示了 “transferring unseen actions”,这些“未见”只是同一动力学内新的演示片段,并非跨动力学族或真实世界场景的零样本迁移。方法的理论保证基于独立性与因果假设,但真实视频中外观与动态的分离可能不严格,实际泛化能力有待在开放域视频(如 Ego4D、Kinetics)上验证。