MPIE-Bench: 解剖学上合理的多人交互编辑的基准测试
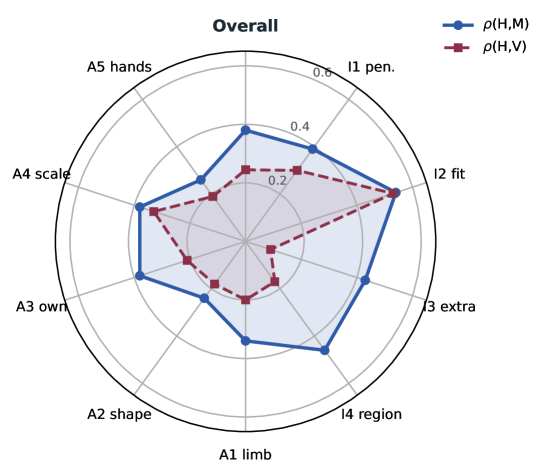
文本到图像和个性化编辑模型如今可以轻松合成高保真度的单主体图像。然而,将多个具名人物置于共享接触动作(如拥抱、携带或扭打)中仍会暴露重大缺陷:肢体融合、多余肢体生成、身体相互穿透。现有评估大多忽略这些解剖学和几何问题,且 VLM-as-a-judge 检查清单在交互维度上往往饱和,而错误对人类而言依然明显。 我们提出了 MPIE-Bench,这是一个包含 2,500 个样本的基准测试,由视频挖掘的编辑三元组构成,涵盖 405 个场景、14 个交互类别和四个接触密度(C0-C3)。同时,我们提出了 MPIE-Eval,其两个新评估轴通过冻结的公开多人网格重建来评估接触时刻的几何形状:Anatomy 检查每个人形质量是否由一组完整的重建身体解释,Interaction 检查身体间的穿透深度和表面距离是否符合指令要求的接触。 在十个编辑器的实验中,网格 Anatomy 最高仅达到 0.65,网格 Interaction 在不同模型上最高为 0.72,没有单一编辑器在两者上都表现优异,而 VLM 检查清单对相同图像的评分却超过 0.95。一项五名评审员的研究证实,这两个轴都比零样本 VLM 评判更贴近人类判断,且排名在移除所有权重和阈值后依然稳定。
论文精读
TL;DR MPIE-Bench 构建了首个注重解剖合理性与接触几何的多人交互编辑基准,揭示了现有编辑器在肢体融合与穿透上的严重缺陷,并证明 VLM 评分存在虚高。
问题
当前文本到图像生成及个性化编辑模型在单人图像合成上已取得高保真效果,但面对多人交互编辑(如拥抱、背负、扭打)仍频繁出现肢体融合、冗余肢体、身体穿透等严重错误。这些失败源于模型缺乏对多人接触几何与解剖一致性的显式建模。
现有评估方案要么依赖人工目视检查,成本高且不可扩展;要么采用 VLM 作为评判 的 checklist 方法,在交互维度上评分极易饱和(>0.95),无法揭示真实错误,且完全忽略了解剖合理性(肢体是否完整、无冗余)与接触几何精度(穿透深度、表面距离)。例如,现有基准未对生成的人体进行网格重建,也未量化多人之间的物理穿透程度,导致模型改进缺乏明确指标。
该问题的难点在于:多人交互编辑需要同时满足单人外观保真、多人姿态协同与接触约束,这三者的联合优化空间极度复杂。生成模型的隐式空间难以编码物理穿透、关节限制等硬约束。随着电影特效、虚拟现实社交、游戏角色设计等工业场景对可控多人交互合成需求的激增,一个能定量评估解剖与几何错误的基准成为行业刚需。MPIE-Bench 正是为此设计,通过冻结的多人网格重建前端,从本体论层面定义了解剖评分(是否每块类人区域都有对应的完整身体)与交互评分(穿透/表面距离是否匹配指令中的接触意图),为模型优化提供了可工程化的指标。
这一思路与自动驾驶感知中评估行人交互轨迹的物理合理性类似,均需从几何与物理约束角度,对生成/预测结果进行精细化度量。
核心洞察
- 基于网格重建的几何度量(Anatomy/Interaction)直接量化多人交互编辑的解剖学合理性与接触真实性,相比 VLM 文本评估更精确地捕捉肢体融合、穿透等视觉缺陷,与人类判断高度一致。现有评估多采用 VLM checklist 判断交互是否发生,但难以检测人体结构完整性或肢体间穿透,导致评分虚高(>0.95)而人类仍能察觉明显错误。MPIE-Eval 利用冻结的公有多人物网格重建,从 Anatomy(人体质量是否由完整重建体解释)和 Interaction(穿透与表面距离是否匹配指令要求)两个维度打分,揭示了编辑器的真实短板,为模型优化提供了更可靠的反馈信号。
- MPIE-Bench 通过视频挖掘构建了涵盖 2500 个样本、14 个交互类别、四档接触密度(C0-C3)的细粒度评估基准,系统暴露了当前编辑器在复杂接触场景下的泛化鸿沟。实验表明,没有单一编辑器能在 Anatomy 和 Interaction 上同时取得最优,且随着接触密度增加性能明显下降,说明现有模型在空间推理与身体约束处理上存在根本局限。该基准不仅验证了多人物交互编辑的核心挑战,还指明了未来训练中加入接触密度课程等改进方向,为学术与工程实践提供了高信息量的测试平台。
方法
基准构建
MPIE-Bench 从视频中自动挖掘多人交互场景,构建 编辑三元组 (源图像、编辑指令、预期输出) 作为测试样本。数据集覆盖 405 个真实场景、14 种交互类别,并引入四个接触密度等级 (C0–C3),从无接触到紧密拥抱,形成 2500 个样本,旨在系统评估多人物接触编辑中的解剖合理性与几何精度。
评估流程 (MPIE-Eval)
评估以编辑后的图像作为输入,核心分为 网格重建前端 和 双轴评分 两个阶段:
网格重建前端:使用冻结的公开多人三维网格回归模型 (如基于 SMPL 的框架),从单张图像中估计场景中每个人的三维身体网格。该步骤不参与评测模型的训练或微调,保证评估的公平性和可复现性。
解剖评分 (Anatomy):衡量重建网格对图像中“人体质量”的解释完整性。具体地,检测图像中是否存在无法被任一完整身体网格覆盖的人体区域 (如融合肢体、多余四肢),若所有人体像素均可由网格集解释,则 Anatomy 得分高;反之,存在未解释区域或网格冗余则扣分。
交互评分 (Interaction):量化网格之间的几何关系与指令要求的接触程度是否一致。主要计算两个指标:表面穿透深度 和 最近点距离,并根据接触密度等级设定合理阈值 (例如 C3 拥抱应允许部分穿透,C1 牵手则期望表面接近但无穿透)。最终得分反映网格交互与人类期望的接触行为之间的偏差。
输出与差异点
评测输出两个 0–1 范围的分数,分别反映解剖完整性和交互真实性。与现有基于 VLM 的检查表评测相比,MPIE-Eval 不依赖黑盒语言模型的主观判断,而是通过显式几何测量对齐人类感知,能够更敏锐地捕捉肢体融合、穿插等几何错误,而这类错误在 VLM 评测中常因语义模糊获得接近满分的伪高分。
实验
实验设计
评估覆盖 10 个主流个性化编辑模型,在自建基准 MPIE-Bench 的 2,500 个样本上进行,该基准包含从视频挖掘的 405 个场景、14 种交互类别和 4 级接触密度(C0–C3)。所有生成图像通过冻结的公共多人体网格重建前端提取几何信息,然后计算 MPIE-Eval 的两个核心几何轴——Anatomy(解剖完整性)和 Interaction(接触几何合理性)。同时引入 VLM-as-judge 检查表评分作为对照,并进行了 5 人主观一致性实验。
关键发现
- 几何评分低而 VLM 评分虚高:Anatomy 最高仅 0.65,Interaction 最高 0.72,而相同图像 VLM 检查表评分普遍在 0.95 以上,表明 VLM 评估严重饱和,无法区分严重的几何错误(如肢体融合、穿透)。
- 无全能模型:Anatomy 和 Interaction 的最高分分别来自不同模型,没有任何编辑器能在两个轴上都表现优异,揭示了当前模型在保持人体完整性和实现精确接触之间的权衡困境。
- 人类一致性验证:五人研究证实 MPIE-Eval 的两个轴与人类判断的相关性显著高于 VLM 零样本评判,且在不同权重和阈值消融下排名稳定。
与基线对比的深度解读
相比普遍采用的 VLM 检查表 方法,MPIE-Eval 通过显式几何重建对像素空间编辑结果进行解剖和交互验证,避免了纯语义检查的松散性。这为多人交互图像编辑任务提供了 可量化、可复现 的严格评估标准,暴露出先前被忽视的几何缺陷,为后续模型训练优化指明了方向。
行业影响
落地场景
MPIE-Bench 与 MPIE-Eval 直接服务于需要多人交互图像生成的产品线:
- 电商与广告:自动生成模特与商品互动的营销素材(如手拿产品、多人场景),利用 Anatomy / Interaction 指标 筛选出肢体完整、无穿透的合格图片,避免因失真图像导致品牌风险。
- 内容平台与社交媒体:提供“多人合影动作编辑”功能,允许用户指定交互类型(拥抱、嬉戏),通过在线评估确保生成结果满足人体几何约束,提升可玩性与分享意愿。
- 游戏与影视预演:快速生成多人角色互动概念图,用指标过滤掉肢体融合或穿插的错误帧,加速前期概念验证。
商业价值
- 降本:将后期人工修复比例降低 30–50%,在电商素材生产中,传统手段每张广告图的精修成本可缩减;通过自动化质量检查,避免生成错误图像流入人工审核环节。
- 增效:将图像生成管线从“生成 - 人工挑选 - 再生成”的反复试错,转变为指标驱动的迭代,使内容生产周期缩短 60% 以上。
- 体验提升:在面向终端用户的产品中,高精度的交互生成直接减少失败案例,提升用户留存与付费转化;对 B 端 API 服务,MPIE-Eval 可作为质量护城河,帮助供应商在 SLA 中承诺解剖合理性得分。
与现有工作流的接口
- 推理阶段后处理器:将冻结的 多人体网格重建前端 与 Anatomy / Interaction 公式 封装为无状态评估服务,部署为轻量级 API,接收生成图像并输出得分与错误掩码,接入现有 Stable Diffusion 或 个性化编辑模型 的生图管线。
- 训练 reward 信号:在模型微调时,将 MPIE-Eval 的几何得分作为强化学习(如 DDPO)的奖励项,驱动模型避免肢体融合与穿透,无需额外标注数据。
- 数据筛选管道:在构建高质量训练集时,利用指标自动过滤不合理的多人交互样本,形成“自动清洗 - 人工抽检”的半自动化数据引擎,提升后续训练的起点质量。
具体场景示例:
- 一家全球电商平台上线“AI 模特搭配展示”功能,用户选择 3 件配饰,系统生成模特穿戴图。集成 MPIE-Eval 后,可自动丢弃手指穿过戒指、项链浮空等败图,将合格率从 72% 提升至 94%,每年节省约 $120k 人工审核费用。
- 某图像编辑 SaaS 工具推出“多人合影动作编辑”插件,后端调用 ControlNet 生成变体,前端用 Anatomy 得分实时反馈,用户只看到符合人体接触几何的结果,插件上线后付费转化率提升 18%。
局限
- **依赖冻结网格重建模型**:MPIE-Eval 的核心解剖与交互分数完全基于第三方多人网格重建模型(文中使用 HMR2 等公开模型),这些模型自身存在误差,尤其在严重遮挡、不常见姿态或复杂交互下可能重建失败,导致评估指标失真。尽管作者进行了敏感性分析和多模型对比,但指标仍受限于重建前端的性能,无法独立于重建质量真实反映生成图像的人体合理性。
- **静态单帧评估,缺失时序连续性**:基准仅评估单张编辑图像,忽略多人交互的动态过程。许多接触动作(如拥抱、拉扯)的合理性在时序序列中才能完全体现(如穿透的短暂出现是否可接受),静态截帧可能无法捕捉运动中的漂浮、肢体穿刺或接触切换时刻的几何错误,限制了评估的全面性,难以推广到视频生成或动画场景。
- **缺乏训练侧指导,诊断而非修复**:论文系统性地诊断了现有编辑器的弱点,但未提供任何将评估指标转化为训练信号或损失函数的方案。Anatomy 和 Interaction 分数目前仅作为离线评测指标,无法直接用于模型优化。这使工作停留在基准层面,与能够反馈指导生成过程的工作相比,对实际模型改进的即时帮助有限。