Harness-G: 用于搜索代理的图结构 Harness
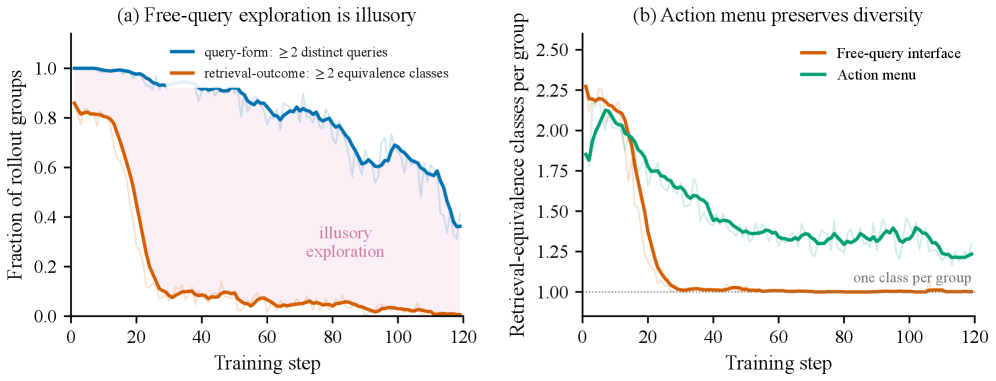
强化学习(RL)搜索代理通常将检索建模为自由形式的自然语言查询生成,并使用最终答案奖励来优化多轮交互。当前研究主要通过更密集或更结构化的信用信号来改进训练,但很少检查检索在策略-环境接口处是否被正确公式化。 我们观察到 Search-R1 训练期间存在显著的检索别名化:同一问题的 rollout 继续生成不同的查询字符串,但其累积的证据集越来越重叠。我们将这种现象称为 检索等价性坍缩;在这种状态下,轨迹在检索决策方面趋于效用等价,组内回报几乎没有有效的检索对比。 为解决此问题,我们提出 Harness-G,一种重新设计该接口的图结构检索框架。它将自由形式查询生成重新表述为有限动作选择:策略选择一个证据句子或实体,或选择回答,而环境构建菜单、跟踪检索状态,并验证和执行每个选择。该接口减少了语言别名化,使同状态替代方案可直接比较。在该接口基础上,我们引入 结构化非近视信用(SNC),使用冻结的答案评分器将选定动作与其替代方案进行比较,并将下游收益分配给使这些收益成为可能的早期动作。 在六个 QA 基准 上,Harness-G 在两个评估模型规模上均达到最高平均 F1,在 1.5B 和 3B 规模上分别超过最强基线 Graph-R1 10.74 点和 3.98 点。
论文精读
TL;DR Harness-G 将搜索代理的检索重新设计为图上的离散动作选择,结合结构化信用分配,解决检索混叠问题,在多跳 QA 上显著优于自由查询方法。
问题
强化学习 (RL) 驱动的搜索代理 通过多轮检索与推理提升复杂问答能力,但其策略优化的有效性严重依赖检索动作的可区分性。现有方法几乎全部采用自由形式自然语言查询生成作为检索接口,并以最终答案正确性作为稀疏奖励。这一设计引发检索别名 (retrieval aliasing) 现象:同一问题下,不同的查询字符串经检索后积累的证据集高度重叠,即检索等效崩溃 (retrieval-equivalence collapse)。此时,多种轨迹在检索效用上趋于等同,RL 训练中的信用分配失去有效对比信号——模型无法辨别哪些查询真正带来了信息增益,梯度更新被噪声主导,导致训练低效且不稳定。更关键的是,该问题的根源在于语言生成与检索效用的解耦:连续语义空间允许无数种表述映射到相同的证据集,而最终奖励只关心答案正确性,对中间检索质量完全不敏感。这使得搜索策略的优化极易陷入混沌,尤其损害需要多步组合推理的多跳问答场景。业界愈发重视 LLM 的自主搜索能力,但现有 RL 框架未能从策略-环境接口层面解决检索动作的同质化,限制了训练效率和跨任务泛化。类比推荐系统:若不同搜索词总是返回相同商品,则点击信号无法刻画用户细粒度偏好;搜索代理同样需要可区分的检索动作来表达信息需求。
核心洞察
- 检索等价崩溃(Retrieval-Equivalence Collapse)是自由形式查询RL搜索代理的隐式失效模式:不同查询字符串产生趋同的检索证据集,削弱了策略梯度中的检索对比度。Harness-G 将检索重新设计为在预构建图上的有限动作选择,从环境接口层面消除语言混叠,使同状态下的替代动作可直接比较。这与已有工作仅在奖励设计或训练策略上改进不同,它揭示了接口设计对 RL 搜索优化成功的关键影响。
- 结构化非短视信用分配(SNC)利用“边疆相对优势”,将最终答案质量的提升归因到早期检索动作。通过冻结的答案评分器比较所选动作与同状态下其他可行动作,SNC 计算相对优势并识别使能后续增益的先期检索步骤,为这些步骤提供结构化信用。相比基于轨迹级奖励或短视密集奖励的方法,SNC 噪声更低、粒度更细,能有效缓解延迟奖励下的信用分配难题。
方法
输入与图构建
Harness-G 接收自然语言问题及对应语料库,首先离线构建语料库诱导的三分图(Corpus-Induced Tripartite Graph):将文档拆分为句子、实体与段落节点,形成结构化的证据关联网络。该图在检索过程中静态度量候选动作的关联度,避免在线遍历庞大索引。
菜单式检索环境
核心创新是将自由形式查询生成重新定义为离散菜单导航。每个检索步,环境根据当前状态(已选句子集合)动态生成有限动作菜单:
- 证据句子:从图邻域中筛选的候选句子
- 实体:可进一步探索的相关实体
- 特殊动作
[Answer]:终止检索并输出答案
策略模型(如 Qwen2.5 基座)仅需从菜单中选择一项,环境负责验证合法性、更新检索状态并反馈观察。该设计消除了自由文本查询的别名混淆——同一句子可能被不同措辞描述,导致语义重叠但信用对比弱化,而菜单确保相同状态下各选项直接可比。
结构化非近视信用分配(SNC)
为强化检索决策的长期价值,SNC 引入冻结的答案评分器(answer scorer)评估每个状态下所有可选动作的潜在收益。具体步骤:
- 前沿(frontier)构造:对当前状态,计算每个动作的预期答案质量(如与参考答案的 F1),选择最高分作为前沿基准。
- 前沿相对优势:实际所选动作的得分与前沿之差作为即时奖励,反映选择是否优于同级选项。
- 使能信用回溯:将最终答案的高分增益沿轨迹分拆分配给早期使能动作,解决传统最后一步才分配奖励的近视问题。
SNC 与 GRPO 算法集成,直接为策略更新提供结构化信用信号,无需额外训练过程奖励模型。
工程启示与差异点
菜单接口天然支持无效动作过滤与证据去重,减少冗余交互;SNC 仅增加一次答案评分前向传播,计算开销低。与 Graph-R1 等基于自由形式查询的方法相比,Harness-G 从接口层面消解检索等价崩溃,使相同状态下动作对比更有效,对多跳推理等复杂任务提升尤为显著。
实验
实验设计
在六个多跳与单跳 QA 基准上评估 Harness-G,采用 1.5B 和 3B 参数的 Qwen2.5 作为策略网络主干。对比方法包括:无搜索的提示方法、自由形式查询的强化学习搜索代理(如 Search-R1),以及结构化图检索基线 Graph-R1。评价指标为最终答案的 Token F1,并辅以生成评估和检索相似度分析。消融实验分别去除菜单接口和 SNC 信用,以验证组件贡献;此外,还进行了跨数据集泛化和训练鲁棒性测试。
关键发现
- 整体性能:Harness-G 在两个模型规模下均取得 最高平均 F1,显著超越所有基线。
- 多跳收益:结构化导航对多跳 QA 的提升尤为明显,验证了将检索转化为显式状态转移的有效性。
- 规模效应:1.5B 模型的相对增益远大于 3B,表明小模型更容易受检索混淆影响,而 Harness-G 能有效缓解。
- 训练稳定性:与自由形式查询相比,菜单接口消除了 zero-advantage groups,避免了检索等效崩塌,训练回报曲线更平稳。
- 交互效率:虽然动作空间离散化导致更多交互轮次,但每轮响应长度大幅缩短,整体推理开销与 SNC 计算开销均可控。
与基线对比
与最强结构化基线 Graph-R1 相比,Harness-G 在 1.5B 上平均 F1 高出 10.74 点,在 3B 上高出 3.98 点。与自由形式查询的 Search-R1 相比,性能优势更为悬殊,这主要得益于 菜单接口 减少了语言同义混淆,使同一状态下的动作具有可比性,配合 SNC 提供的非短视信用分配,让智能体能够从全局证据中学习到有效的检索策略。即使与相同主干的其他 RL 算法结合,Harness-G 的接口设计仍保持鲁棒性。
行业影响
落地场景
Harness-G 将自由文本检索重构成图导航菜单决策,适用于需要多跳推理的复杂问答系统。核心场景包括:
- 企业知识库问答:支持跨文档多证据聚合,适合客服、法律、医疗等领域的深度查询。
- 电商导购助手:在商品知识图谱上导航,组合多条件筛选(如“适合油皮的平价洗面奶有哪些成分”),提高答案精确性。
- 金融研报分析:在实体关系图中检索企业、事件、指标的关联,自动生成归因报告。
商业价值
- 降本:通过菜单式行动空间减少无效查询,降低 LLM 调用次数,实验显示交互轮次增加但每轮回答更短,整体 token 消耗可控,SNC 额外计算开销低。
- 增收:在客服、咨询场景中,更高的答案 F1(3B 模型较 Graph-R1 提升 3.98 分)直接减少转人工率,提升转化。
- 体验提升:结构化导航使决策过程可解释,便于展示推理路径,增强用户信任。
与现有产品/工作流的接口
- 图形化检索即插即用:Harness-G 的菜单环境可作为插件接入 RAG 流程,替换自由文本查询生成模块,后端仍可使用现有 Elasticsearch 或图数据库。
- 训练轻量:SNC 基于冻结计分器,无需额外标注,可在现有 LLM 微调流水线中添加。
- 兼容主流 RL 算法:SNC 集成进 GRPO,训练稳定,可直接应用于参数规模为 1.5B 和 3B 的 Qwen 等开源模型。
具体落地用例
- 医疗文献循证:在 PubMed 知识图谱上,Harness-G 可逐步选择“疾病-药物-试验结果”,在循证问答中准确组合证据,替代人工文献检索。
- 智能汽车手册查询:在车辆维修手册的结构化语料库中,通过导航“故障现象→部件→检修步骤”,为用户返回精准操作指引,降低售后支持压力。
局限
- **图构建的扩展性约束**:Harness‑G 依赖预先构建的语料库诱导三部图,将文档解析为句子节点与实体节点并建立连接。图构建涉及实体链接、句子分割与索引,对动态更新的大规模语料(如实时网页索引)维护成本高,且动作空间随语料膨胀而急剧增大,虽辅以约束筛选(见附录 J),框架在实时知识库上的适应性未得到验证。实验仅在静态 QA 数据集上开展,向开放域或流式检索场景迁移时会面临工程挑战。
- **动作空间离散化的表达折损**:将检索重定义为有限动作选择(选取证据句子或实体)有效降低了语言混叠,但完全舍弃自由形式查询可能牺牲表达的灵活性。对于需要数值运算、复杂逻辑组合或创造性语义关联的查询,离散图导航难以刻画细粒度的检索意图。论文在主要在多跳 QA 上取得提升,但在需要开放式推理的任务(如长篇问答、对话式信息搜索)中,这种受限的动作空间可能成为瓶颈。