SpatialCLI: 学习先用空间工具推理,再脱离工具
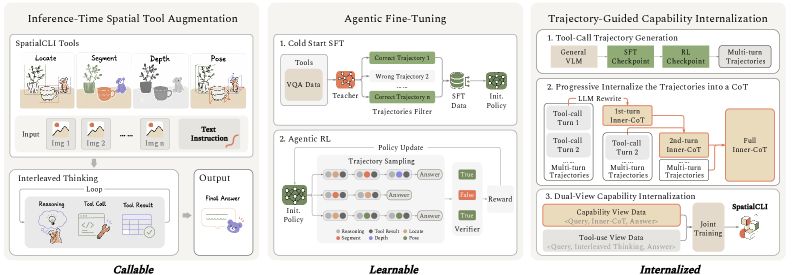
视觉语言模型(VLM)越来越多地被用于具身智能体,以解读视觉输入、推理空间关系,并基于该推理做出任务级决策。然而,一个根本的能力错配依然存在:通用 VLM 能推理整体任务,但常漏掉决定成败的视觉细节;而专家视觉模型能捕捉这些细节,却无法将其转化为任务级决策。 在本工作中,我们提出 SpatialCLI,一种教会 VLM 先用空间工具推理、再逐步内化专家感知能力的框架。SpatialCLI 分三个阶段:(1) Call:将专家视觉模型作为空间工具暴露给 VLM,增强其感知;(2) Learn:使用 Cold-Start SFT 和 agentic RL 提升工具使用能力;(3) Internalize:将成功的工具使用轨迹语言化,内化专家感知能力。我们还引入了 SpatialCLI-Bench,一个包含 516 个样本的基准,用于组合感知评测,涵盖定位、分割、深度和姿态。在 MindCube 上,SpatialCLI 将 Qwen3-VL-8B-Instruct 从 29.3% 提升至 84.6%(带工具),超过带工具的 GPT-5.6 Sol(72.1%),并且在内部化后,不带工具仍能保持 73.8% 的性能。
论文精读
TL;DR SpatialCLI 通过三阶段训练让 VLM 先调用空间工具增强感知,再内化工具轨迹,最终无需工具即可达到接近工具辅助的性能,在 MindCube 上无工具准确率从 29.3% 跃升至 73.8%,超越带工具的 GPT-5.6 Sol。
问题
问题背景
视觉语言模型 (VLM) 在具身智能中被广泛应用于理解图像输入、推理空间关系并做出任务级决策。当前领域聚焦于如何将高层语义推理与底层精确视觉感知统一到单一模型框架中,以支撑复杂交互场景。
现有方法及其局限
现有方案通常呈现两种割裂形态:
- 通用 VLM (如 GPT-4V) 能够理解整体任务,但往往忽视决定成败的细粒度视觉细节 (例如关键物体的空间坐标、遮挡关系),导致在精确操作任务中频繁失败。
- 专业视觉模型 (如检测器、分割器) 能可靠捕获这些细节,却缺乏将其转化为任务级决策的能力,无法直接驱动具身代理。
- 近期工作尝试用工具调用桥接二者,但工具通常被视为固定外挂,VLM 对工具返回的原始信号 (如坐标、深度图) 利用率低,且工具使用能力与模型自身推理能力相互孤立——依赖工具时无法脱离,不依赖工具时能力退化严重。
技术挑战与重要性
核心难点在于空间感知与任务推理的耦合深度。一方面,VLM 需要学会何时调用何种工具、如何解读工具返回的异构空间证据 (定位框、分割掩码、深度值) 并融入当前任务上下文;另一方面,长期依赖工具会导致推理路径脆弱,一旦环境不支持工具调用,模型性能急剧下降。业界对“感知-决策一体化”的需求强烈,尤其在机器人操作、AR 导航等场景,既要求执行效率 (需要时用工具),又要求优雅降级 (脱离工具后仍保持合理表现)。
行业场景类比
这一矛盾类似于自动驾驶系统中感知模块与规划模块的解耦难题:感知模块输出结构化世界状态,规划模块负责决策,但若两者接口设计僵化,则系统在传感器失效时完全瘫痪,而人类驾驶员却能通过有限信息做出可靠推断。SpatialCLI 试图让 VLM 像人类一样,在拥有完整感知工具时充分利用,在没有工具时通过内化的记忆与推理补全空间信息。
核心洞察
- **渐进式能力内化(Progressive Capability Internalization)** 让 VLM 从依赖外部空间工具到脱离工具仍能精准推理。与直接微调(Direct Fine-Tuning)容易遗忘通用能力或过度绑定工具输出不同,SpatialCLI 通过轨迹引导的 verbalization 和双视图训练,将工具返回的结构化证据转化为模型自身推理的 pattern。在 MindCube 上,Qwen3-VL-8B-Instruct 使用工具时 84.6%,内化后无工具仍保持 73.8%,证明这种‘先借助、再吸收’策略能平衡工具红利与独立推理,为构建高效、灵活的多模态代理提供了新的训练范式。
- **结构化工具返回(Structured Tool Returns)与双视图学习** 是实现空间感知内化的关键设计。SpatialCLI 发现将 specialist 模型的输出(如定位、深度)格式化为 JSON 等结构化证据,比原始视觉信号更利于 VLM 学习和口头化。同时,训练时同时暴露带工具视图(Tool-Use View)和直接回答视图(Direct Answer View),强迫模型在面对无工具场景时‘回忆’结构化信息,从而将外部感知能力高效压缩进内部参数。这为工具增强学习的接口设计和多任务训练提供了可复用的工程原则,有望推广至其他需工具辅助的感知任务。
方法
SpatialCLI 三阶段渐进学习框架
输入:多模态任务(图像 + 自然语言问题),VLM 具备宏观任务推理能力,但对细节空间感知不足。
1. 推理时工具增强 (Call)
- 将 Locate、Segment、Depth、Pose 等专家视觉模型封装为可调用的空间工具,VLM 根据问题自主决定是否调用,工具返回结构化证据(边界框、分割掩码、深度图、位姿矩阵)。
- VLM 整合证据后生成最终答案,弥补感知缺口。
2. 智能体微调 (Learn)
- Cold-Start SFT:利用少量成功工具调用轨迹进行监督微调,让模型初步学会何时及如何调用工具。
- Agentic RL:以任务完成正确性为奖励,通过强化学习优化调用策略(如工具选择顺序、参数生成),提升工具使用的有效性和泛化性。
3. 轨迹引导能力内化 (Internalize)
- 逐步言语化:将成功工具调用轨迹转化为自然语言叙事,包含工具输入输出及最终证据,使模型“看到”专家推理过程。
- 双视图训练:同时优化工具使用视图(需调用工具)和直接回答视图(无工具),共享参数;通过模仿工具辅助下的推理链条,将专家感知能力内化到模型自身参数中。
输出:一个既能灵活调用工具、也能在无工具时保持高精度空间推理的 VLM。移除工具后,模型仍能依靠内化能力正确回答问题。
差异点:SpatialCLI 首次通过轨迹言语化 + 双视图训练将工具能力蒸馏进入模型内部,区别于传统工具增强方法仅依赖外部工具而模型本身不变。
实验
实验设计
SpatialCLI 以 Qwen3-VL-8B-Instruct 为基础模型,在 MindCube 和自建的 SpatialCLI-Bench (516 例) 上评估空间推理能力。SpatialCLI-Bench 覆盖 定位、分割、深度、姿态 四类任务。实验遵循 三阶段流程:
- Call:调用空间工具 (Locate, Segment, Depth, Pose) 增强 VLM 感知;
- Learn:通过 Cold-Start SFT 与 Agentic RL 提升工具使用能力;
- Internalize:将成功工具使用轨迹口头化,通过双视角训练将专家感知能力内化到模型权重,实现在不调用工具时仍保持高性能。 基线包括原始模型直接回答、仅微调、以及 GPT-5.6 Sol 等外部模型。
关键发现
- 带工具性能飞跃:SpatialCLI 带工具时将 Qwen3-VL-8B 的 MindCube 准确率从 29.3% 提升至 84.6%,超越 GPT-5.6 Sol (72.1%)。
- 内部化后高效保留:内化后即使移除工具,准确率仍达 73.8%,大幅优于基线且推理开销更低。
- 训练策略互促:联合训练直接回答与工具使用相互促进;消融实验证实结构化工具返回、渐进式口头化及双视角训练均为关键设计。
- 可扩展性:能力内化随数据量和模型容量继续提升,表明大规模 VLM 可以高效吸收专家感知技能。
与基线对比解读
直接微调缺乏对空间推理过程的显式建模,容易过拟合表面模式。SpatialCLI 通过显式工具使用轨迹引导模型学会“如何推理”,再将推理能力浓缩到自有参数中,实现“授之以渔”。对比 GPT-5.6 Sol,8B 参数的开源模型通过工具增强超越了闭源巨模型,且内化后免去工具调用延迟,在精度与效率间取得更优平衡。消融实验明确指出了结构化证据格式与渐进式口头化的必要性,为后续工作提供了清晰的设计参考。
行业影响
落地场景
SpatialCLI 的核心是让 VLM 渐进式掌握空间推理能力,先借用专业工具(定位、分割、深度、姿态),再通过轨迹内化摆脱工具依赖。 该范式可落地于任何需要精细空间理解的 AI 产品,例如:
- 机器人操作与导航:仓储分拣中结合物品定位与姿态估计,自适应抓取;服务机器人理解室内 3D 布局进行避障与寻路。
- 自动驾驶与高级辅助驾驶:环视图像中完成多目标检测、分割与深度估计,工具调用阶段用于高精度离线验证,内化后用于车端实时推理。
- 增强现实(AR)与虚拟现实:对现实场景实时分割与深度感知,叠加虚拟信息或进行虚实遮挡计算,内化后可在移动端低延迟运行。
- 医学影像分析:病灶定位、器官分割与深度估计,辅助手术规划或筛查,工具可作为专家模型的高精度参考。
商业价值
SpatialCLI 的“先调用后内化”策略直接带来 降本 与 增效:
- 降低推理成本:内化后不再需要调用多个 specialist 模型 API,节省云端算力与网络开销;对于边缘部署场景(如机器人、AR 眼镜),大幅降低硬件资源需求。
- 提升任务成功率与用户体验:工具增强的 VLM 在 MindCube 基准上将 8B 模型从 29.3% 拉升至 84.6%,超越更大模型,可直接提升自动化水平,减少人工介入。
- 加速产品迭代:冷启动 SFT + Agentic RL 的训推链路可复用至不同领域,仅需更换工具集与少量标注,缩短新场景的落地周期。
与现有产品/工作流的接口
SpatialCLI 作为即插即用的空间能力增强框架,可无缝集成进现有 VLM 技术栈:
- 训练阶段:将工具调用封装为统一 API,以 prompt 控制工具选择(如
Locate、Segment),结合 Cold-Start SFT 和 GRPO 强化学习 优化工具使用策略,消耗少量工具使用轨迹即可完成内化蒸馏。 - 部署阶段:内化后的模型为单一 VLM checkpoint,无需特殊运行时依赖,可直接替换现有 VLM 推理节点,例如接在视觉编码器之后,输出空间结构化信息供下游规划模块消费。
- 数据与评估:提供 SpatialCLI-Bench(516 样本,覆盖 4 种空间能力)作为验收基准,方便与已有评测体系(如 Embodied QA、RoboVQA)对齐。
具体落地用例
电商 AR 虚拟试穿:商品图像需精确分割、定位并估计深度以贴合人体。SpatialCLI 可先调用 Segment 和 Depth 工具生成高精度蒙版与深度图,用于离线渲染训练;内化后模型可直接在 APP 端推理,无需云端传输原图,保护隐私的同时实现实时虚拟试穿。
自动驾驶 3D 目标检测:环视相机图像输入 VLM,SpatialCLI 调用 Locate + Depth + Pose 工具联合标定障碍物的 3D 包围框与朝向。这些带工具的证据轨迹用于内化训练,最终模型可在车端芯片上直接输出 3D 感知结果,降低对高精度地图和传感器融合算力的依赖。
局限
- **工具接口强依赖预定义专家模型**:SpatialCLI 的推理增强依赖于一组固定的空间工具(定位、分割、深度、姿态),这些工具由特化视觉模型实现。当任务超出这四个维度或需引入新感知能力(如温度、材料识别)时,必须重新设计工具接口与对应的专家模型,框架不具备自动扩展性。此外,工具调用引入的推理延迟在实时交互场景(如机器人高频闭环控制)中可能成为瓶颈。
- **内化过程对工具轨迹质量高度敏感**:Capability Internalization 通过 verbalize 成功工具调用轨迹来蒸馏空间感知能力,但论文未充分探讨当工具返回错误或歧义结果时,内化是否会放大这些偏差。实验仅假设工具输出是可依赖的,而真实部署中专家模型也可能出错。内化后的模型在分布外场景(如野外新环境)的退化风险仍缺乏评估。
- **评估环境与基准规模限制结论普适性**:主要实验在合成数据集 MindCube 上完成,虽包含多种空间推理任务,但与真实物理世界的视觉复杂性和多样性仍有差距。自建 SpatialCLI-Bench 仅包含 516 个样本,且可能偏向工具易处理的案例。论文未在真实机器人平台或大规模真实图像数据集上验证,使得从仿真到现实(Sim2Real)的迁移效果存疑。