VideoCoCo: Code-as-CoT 的物理一致性视频生成,基于智能双引擎系统
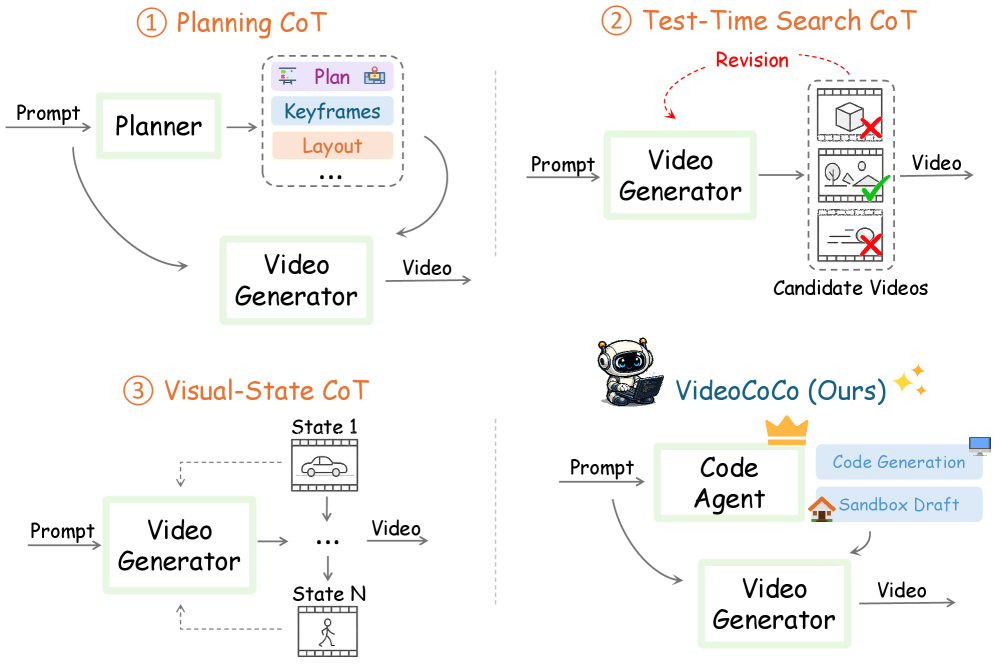
文本生成视频模型已取得惊人的视觉质量,但仍难以生成物理一致的动态,因为场景的时间演化必须从高度压缩的文本提示中隐式推断。现有的思维链方法引入了中间计划或视觉状态,但这些表示通常不可执行或时间稀疏,限制了它们实例化和控制完整时空过程的能力。 为解决这一局限,我们提出VideoCoCo,一个智能双引擎框架,其中可执行的 Blender 代码充当过程级思维链。给定文本提示,编码智能体合成一个 Blender 程序,显式指定场景及其时间演化。可执行模拟引擎运行该程序,生成确定性的时空草稿,随后由生成式视频引擎通过草稿条件编辑,将其转化为逼真视频。这种分解将过程级推理与高保真视觉实现分离。为让视频编辑器适应模拟草稿,我们构建了VideoCoCo-3K,一个包含草稿-指令-目标三元组的精选数据集。 VideoCoCo 将 OmniWeaving 基线在 PhyGenBench 上从 0.475 提升至 0.558,在 VBench-2.0 上从 52.18 提升至 77.88,在两个基准上均取得最佳平均分。这些结果表明,可执行代码为物理一致的视频生成提供了一种有效、可控且可检查的中间表示。
论文精读
TL;DR VideoCoCo 以可执行 Blender 代码作为思维链,将物理仿真与视频生成分离为双引擎,显著提升了文本到视频的物理一致性,在 PhyGenBench 和 VBench-2.0 上均取得最优成绩。
问题
文生视频(Text-to-Video)领域正从追求视觉质量转向关注生成视频的物理一致性(Physical Consistency),即确保物体运动、碰撞、光影变化等符合现实规律。
现有方法通过引入中间表征来增强物理合理性,如自然语言规划或稀疏关键帧,但这些表征往往是非可执行的,无法精确描述每一帧的状态,导致约束力不足。端到端的扩散模型仅从海量视频中隐式学习物理模式,缺乏显式物理规则先验,使得生成的视频常出现物体漂浮、穿模、运动轨迹不连贯等“反物理”问题。此外,纯语言提示高度压缩,难以充分表达精细时空动态,而现有CoT方法生成的中间状态稠密度不足,难以全面指导生成过程。
解决该问题对构建世界模型至关重要。若生成视频无法遵循物理定律,在机器人仿真、自动驾驶场景生成等需要可靠环境交互的下游应用中会产生灾难性后果。技术挑战主要来自两个方面:一是文本语义与连续时空演变之间的跨模态鸿沟难以弥合;二是生成过程本身是概率性的,缺乏确定性物理方程的约束,需要一种既能精确编程又能无缝衔接视觉生成的可执行中间表示。业界已将物理一致性视为文生视频下一步突破的关键指标,主流基准如 PhyGenBench 和 VBench-2.0 均专项评估此项能力。
这一思路可类比于自动驾驶仿真中,用可执行脚本(如 OpenSCENARIO)精确描述车辆与行人轨迹,再渲染为高保真图像——代码作为中间语言既可控又便于调试。
核心洞察
- 用可执行代码作为过程级思维链,实现物理一致的视频生成:与基于文本计划或稀疏视觉状态的链式思维方法不同,可执行代码能够完整、确定地指定场景几何和时序演变,从而在仿真环境中显式推理物理过程,生成的草稿确保时空一致性,并作为可检查和可编辑的中间表示,显著提高最终视频的物理合理性。
- 双引擎架构解耦物理推理与视觉生成:通过在仿真引擎中专注于物理过程和空间布局,然后在生成视频引擎中基于物理草稿进行逼真渲染或编辑,这种设计让每个模块专注于自身优势,避免单模型同时处理物理一致性和视觉质量的困难,类似于将“慢思考”的符号推理与“快感知”的生成过程相结合,实现性能的显著提升(PhyGenBench从0.475到0.558,VBench-2.0从52.18到77.88)。
方法
方法概览
VideoCoCo 采用 Code-as-CoT 的代理式双引擎架构,将视频生成分解为两个阶段:过程级推理与高保真视觉实现。整体流程为:
- 输入文本提示 →
- 编码代理(Coding Agent) → 合成可执行的 Blender 程序(作为思维链) →
- 可执行模拟引擎 → 沙盒执行程序,渲染得到确定性的时空草稿(spatiotemporal draft) →
- 生成视频引擎 → 基于草稿和编辑指令,通过 draft-conditioned image-to-video 编辑,输出照片级视频。
关键模块
- Code-as-CoT 程序合成:给定文本提示,编码代理(基于 LLM)生成 Blender Python 脚本,显式定义场景元素(几何体、材质、光照)及其随时间变化的物理过程(刚体运动、碰撞、流体等)。该程序是对动态过程的可执行、稠密描述,弥补了纯文本或静态草图的时空稀疏性。
- 沙盒执行与草稿渲染:在约束环境中运行生成的 Blender 程序,获得确定性的、物理一致的中间视觉表示。草稿虽视觉质量有限,但保留了完整的运动结构与物理交互信息。
- 生成视频引擎与编辑适配:采用预训练的 image-to-video 扩散模型作为基础,通过 draft-conditioned 编辑将草稿转换为写实视频。为弥合模拟草稿与生成模型的分布差异,构建了 VideoCoCo-3K 数据集——使用教师模型根据草稿和指令生成目标视频,形成 (草稿, 编辑指令, 目标) 三元组,用于微调编辑器。训练时冻结基础模型部分权重,仅优化新加入的草稿控制模块,使生成视频在保持草稿运动结构的同时提升画质。
- 端到端推理:微调后,整个流水线可直接从文本到视频,无需中间人工介入。
与同类方法的差异
现有思维链方法多引入不可执行或时空稀疏的中间表示(如语义布局、关键帧草图),难以精确控制动态过程;VideoCoCo 首次将可执行代码作为视频生成的思维链,通过 Blender 引擎获得稠密、确定性的时空草稿,实现了物理一致性与视觉真实性的显式分离,从而在基准测试上显著提升。
实验
实验设计
VideoCoCo 采用双引擎架构:可执行模拟引擎生成 Blender 草稿,生成视频引擎进行草稿条件编辑。评估在两个专门度量物理一致性的基准上进行:PhyGenBench 和 VBench-2.0。基线模型为 OmniWeaving,一种视频编辑方法。为适配模拟草稿的分布,作者构建了 VideoCoCo-3K 数据集,包含 3000 个草稿-指令-目标视频三元组,用于微调视频编辑器。
关键发现
- 在 PhyGenBench 上,VideoCoCo 将 OmniWeaving 基线从 0.475 提升到 0.558 (+17.5%),证明了可执行代码作为 CoT 的有效性。
- 在 VBench-2.0 上,分数从 52.18 跃升至 77.88 (+49.2%),显示出该方法在更广泛物理一致性评价中的优势。
- 消融实验表明,同时使用草稿生成和编辑器微调对性能提升均有贡献,单独使用任一部分均会导致下降。
与基线对比的深度解读
OmniWeaving 作为基线本质上是文本驱动的视频编辑,缺乏对场景物理演化的显式建模。VideoCoCo 的 Code-as-CoT 策略通过 Blender 程序显式表达时空过程,将隐式推理转化为确定性模拟,因此能生成更一致的动态。在 PhyGenBench 上,提升主要集中在需要精确物理交互(如碰撞、重力)的类别;在 VBench-2.0 上,全局一致性的增强反映了这种过程级推理对整体视觉质量的正向迁移。该框架将高层语义与底层物理建模解耦,为后续研究提供了一种可控、可解释的中间表示。
行业影响
落地场景
VideoCoCo 通过可执行代码实现物理一致的视频生成,可应用于对时空逻辑要求严格的领域:
- 影视与广告:自动生成符合物理规律的视觉特效、动态故事板或产品演示视频,减少手动调整关键帧的工作量。
- 电商与内容平台:基于商品描述自动合成真实交互场景(如流体倾倒、物体碰撞),提升素材的真实感与转化率。
- 模拟与数字孪生:在自动驾驶、机器人仿真中生成带有物理过程(如滚动、弹跳)的合成数据,补充稀有场景。
- 教育娱乐:将科学定律(如抛物线运动)可视化,生成教学动画或游戏原型。
商业价值
- 降本:将物理合理性从隐性提示中分离,通过
Blender代码显式控制,大幅降低后期人工修正成本。传统流程中一个复杂物理镜头可能需要数小时手工微调,而 VideoCoCo 的 agentic 框架可在分钟内完成可复现草稿。 - 提效与体验:
Code-as-CoT使生成过程可检查、可干预。创作者能用自然语言迭代修改代码逻辑,无需深入底层模拟引擎,降低了物理仿真视频的创作门槛。在 PhyGenBench 和 VBench-2.0 上的指标提升(如 OmniWeaving 基线分数由 0.475 提升至 0.558)表明物理一致性增强可直接转化为更高质量的视频资产,进而提升用户留存与广告点击率。
与现有产品/工作流的接口
VideoCoCo 可作为模块嵌入现有视频制作管线:
- API 集成:提供文本到视频的 REST API,输入提示词与物理约束,返回仿真草稿和最终视频,对接内容管理系统或自动化营销工具。
- 插件化:封装为 Blender 或 After Effects 插件,让熟悉节点编辑的艺术家在已有环境下调用“代码驱动的物理草稿”能力。
- 数据闭环:
VideoCoCo-3K数据集可用于微调通用视频扩散模型(如 Stable Video Diffusion),使其适配仿真草稿风格,从而实现将物理推理能力注入现有模型生态。
具体落地 Use Case
- 电商产品展示:某运动鞋品牌需生成篮球撞击地板反弹的视频。传统 3D 建模需绑定物理属性并逐帧渲染,耗时 2-3 天。使用 VideoCoCo,输入“a basketball bouncing and then rolling to a stop on a wooden court”,coding agent 自动合成 Blender 脚本,仿真引擎输出精确的反弹轨迹与形变草稿,生成引擎转换为逼真视频,全流程压缩至 15 分钟,可批量生成不同视角与地面材质的变体,直接用于商品详情页。
- 自动驾驶仿真:需要模拟轮胎溅起水花的物理过程来训练感知模型。通过 VideoCoCo 的
Code-as-CoT,可生成多样的“车辆驶过水坑”仿真数据,显式控制车辆速度、水深等参数,确保水花飞溅符合流体力学。这些数据标注成本低(仿真引擎自带精确语义分割),能作为现实数据的补充,提升模型在雨天场景的鲁棒性。
局限
- **依赖 Blender 仿真环境与代码生成质量**:方法的核心是编程代理生成可执行的 Blender 程序,但复杂物理现象(如流体、非刚性碰撞)可能难以用简单脚本精确描述,仿真精度受限于 Blender 物理引擎的建模能力。同时,代码生成存在随机性,若生成程序有语法或逻辑错误,将直接影响后续视频质量。论文未讨论对错误代码的鲁棒处理机制,在实际部署中可能需要额外验证步骤。
- **VideoCoCo-3K 数据集规模有限且覆盖场景可能偏窄**:该数据集仅包含约 3K 条草稿-指令-目标三元组,虽然实验证明足以适配编辑器,但对需要复杂物理交互或长时序的视频,其覆盖率可能不足。此外,数据构建依赖教师模型生成草稿,可能存在分布偏移,导致编辑模型对真实用户输入的泛化能力受限。
- **双引擎架构带来推理开销与编辑伪影风险**:相比端到端生成模型,VideoCoCo 需额外运行 Blender 仿真和代码生成,推理延迟和计算成本增加,可能不适合实时应用。同时,草稿到逼真视频的编辑步骤可能引入纹理闪烁、运动不一致等伪影,虽在整体指标上提升,但个别场景的保真度仍受限于生成式编辑器的能力上限。