TurboVLA: 在RTX 4090上以32 Hz运行、占用少于1 GB显存的实时视觉-语言-动作模型
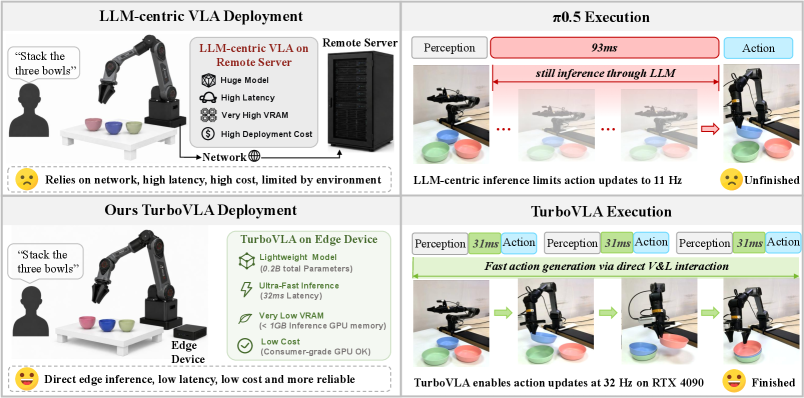
当前视觉-语言-动作(VLA)模型通常采用以LLM为中心的“视觉到语言再到动作”路径,将视觉观测投射到大语言模型表示空间后再解码为机器人动作。这种设计每次策略调用都会产生大量计算和内存开销。 TurboVLA 提出一种新范式,将传统路径重构为 直接 V+L 到 A 映射。模型独立编码视觉和语言指令,通过 轻量双向视觉-语言交互 直接交换信息,并用 紧凑解码器 预测连续动作块,显著降低计算和内存成本。 在 LIBERO 基准上,TurboVLA 仅用 0.2B 参数 即实现 97.7% 平均成功率,推理延迟仅 31.2 ms,显存占用 0.9 GB(RTX 4090),匹配或超越更大规模的 VLA 策略。 TurboVLA 为高效机器人操作提供了简单有效的替代方案,开辟了连接视觉、语言与动作的新视角。
论文精读
TL;DR TurboVLA 将 VLA 模型从 V→L→A 范式重构为 V+L→A 直接映射,用轻量双向交互替代大语言模型,以 0.2B 参数在 RTX 4090 上实现 32Hz 实时推理且成功率高达 97.7%,极大降低资源开销。
问题
问题背景
VLA 模型旨在联合视觉、语言与动作,驱动通用机器人操作,当前领域关注如何在有限计算资源下实现实时、高效的推理。
现有方法局限
主流方案采用 LLM-centric 的 V → L → A 路径(如 RT-2、Octo),视觉特征被投影至大语言模型的表示空间,经由 LLM 推理后再解码动作。该范式暴露出明显的工程短板:
- 计算与内存冗余:每次策略调用都触发完整 LLM 前向传播,权重与 KV 缓存常占用数 GB 显存,对边缘设备极不友好。
- 推理延迟高:LLM 自回归或单步解码带来显著延迟,难以达到 30 Hz 以上的实时控制需求。
- 效率-规模不匹配:简单操作任务仍需承载全尺寸 LLM 开销,造成算力浪费。
难点与重要性
在保障高成功率(如 97%+)的前提下,将推理延迟压缩至 30 ms 级别、显存降至 1 GB 以内,是 VLA 从实验室走向真实机器人的核心瓶颈。LLM 赋予强大语言理解力,却与实时性形成根本冲突;构建能绕开 LLM 瓶颈的轻量级多模态融合机制,成为业界共同关切的技术高地。
行业类比
类似将云端大模型压缩为终端高效模型——正如 MobileNet 让图像分类在手机端实时运行,TurboVLA 尝试为 VLA 寻找一条“边缘友好”的轻量架构路线。
核心洞察
- TurboVLA 将 VLA 流水线重构为视觉与语言特征的直接交互,摒弃了 LLM 作为中介,揭示了 LLM-centric 范式在实时控制任务中的结构性冗余。当前 VLA 模型普遍沿用“视觉 token 化后馈入 LLM 再解码动作”的路径,LLM 承担了信息融合与推理的全部压力,导致每步推理都需重算整个语言模型,计算量与显存占用居高不下。TurboVLA 用独立视觉编码器与语言编码器提取特征,再通过轻量双向交互模块直接在多模态特征空间对齐与融合,最后用紧凑解码器预测连续动作序列。这种设计不会将 LLM 前向传播的延迟和内存负担引入控制循环,从架构层面避免了为“语言理解”支付不必要的计算成本,对实时性要求苛刻的机器人操控具有重要意义。
- TurboVLA 在仅 0.2B 参数、单张消费级 GPU 下实现 32 Hz 推理和 97.7% 成功率,证明小型模型通过定制化多模态融合完全可以匹敌甚至超越大模型,挑战了 VLA 领域的“规模至上”预设。与 RT-2、Octo 等需要数十亿参数和大量 GPU 显存的 VLA 方案不同,TurboVLA 的成功来自高效的特征交互而非参数堆叠,其 0.9 GB 推理显存和 31.2 ms 延迟意味着可在边缘设备上实现闭环高频控制。这提示 VLA 系统的性能瓶颈常在于多模态对齐质量与动作解码效率,而非语言模型的绝对规模,为后续工作提供了从“压缩推理栈”而非“扩展模型”出发的新优化方向。
方法
TurboVLA 将传统 VLA 的 V→L→A 路径重构为直接 V+L→A 映射。输入为机器人观测的视觉图像(如多视角 RGB)和语言指令(任务描述)。整个方法分为三个关键模块:
- 多模态特征编码:视觉与语言分别独立编码。视觉编码器(如 SigLIP)提取图像特征,语言编码器(如轻量 Transformer)将指令转换为文本特征,两者不经过 LLM 投影,避免庞大的中间表示。
- 视觉-语言交互模块:这是轻量级的双向融合单元。它通过交叉注意力或类似机制,让视觉特征感知语言指令,同时语言特征也利用视觉上下文,生成任务条件化的联合表示。该模块参数极少,避免了 LLM 自回归的串行开销。
- 连续动作块预测:融合后的特征送入一个紧凑的动作解码器(如多层 MLP 或小型 Transformer),直接输出未来 t 步的连续动作块(action chunks),每个动作包含末端执行器位姿、夹爪状态等连续量。模型通过行为克隆(如 L1 损失)以端到端方式训练。
输出为机器人可执行的连续动作序列。与主流 LLM-centric VLA(如 RT-2、Octo)相比,TurboVLA 完全去除了大语言模型,用直接的特征交互替代“视觉入 LLM、LLM 出动作”的模式,从而将推理延迟降至 31.2 ms,显存占用不到 1 GB,同时保持高成功率。
实验
实验设计
在 LIBERO 基准上进行语言条件机器人操控评测,涵盖多种子任务。以任务成功率为主要指标,同时记录推理延迟、GPU 显存占用和模型参数量。对比基线包括 RT-2、Octo、OpenVLA 等主流 LLM 中心式 VLA 模型。所有推理在消费级 RTX 4090 上测量,反映真实部署效率。
关键发现
- TurboVLA 仅 0.2B 参数,却取得 97.7% 平均成功率,性能匹配甚至超越数十亿参数级模型。
- 单次推理仅需 31.2 ms(32 Hz),满足实时控制需求。
- 显存占用不到 1 GB(0.9 GB),大幅降低硬件门槛,可直接在边缘设备运行。
- 轻量级 双向视觉-语言交互 模块替代了笨重的 LLM,直接构建任务条件表示,是高效的核心。
与基线对比解读
传统 VLA 遵循 V → L → A 流水线:视觉 token 必须先注入 LLM,再由 LLM 解码控制信号,导致每次推理都需完整的大模型前向传播,计算和内存开销极大。TurboVLA 将通路重构为 V + L → A:视觉和语言独立编码后,通过轻量交互模块直接融合,再由紧凑解码器预测连续动作块。这一范式转变省去了 LLM 推理的巨大成本,在准确率不降的前提下,速度提升数十倍、内存降低一个数量级,使高性能 VLA 策略从实验室迈向实际工程部署成为可能。
行业影响
落地场景
TurboVLA 的极致轻量化(0.2B 参数、<1 GB 显存)和实时性(32 Hz)使得它非常适合部署在算力有限的边缘设备上,例如 AGV、机械臂控制器、嵌入式视觉模块 等。它可直接应用于需要快速视觉伺服和语言理解的任务:物流分拣、柔性装配、零售服务机器人、家用辅助机器人等。产品侧可作为机器人控制软件库或 SDK 中的核心策略模块,服务于自动化设备 OEM 或系统集成商。
商业价值
- 降本:仅需消费级 GPU(如 RTX 4090)即可达到工业级性能,单机部署成本从高端数据中心 GPU(A100/H100)的数千美元降至几百美元,且支持更低功耗的 Jetson 等平台,大幅降低 BOM 和运维开销。
- 增收:32 Hz 高频控制缩短节拍时间,提升拣选、装配等任务的吞吐量;低延迟使机器人能更密集地作业,直接增加单位时间产出。
- 体验提升:在协作场景中,低延迟让机器人对自然语言指令的响应近乎实时,带来更流畅的人机交互,减少等待感,提升用户接受度。
与现有产品/工作流的集成
TurboVLA 可作为一个解耦的动作预测模块集成进现有机器人堆栈。
- 接口标准化:输入为多模态观测(RGB 图像、语言指令),输出为连续动作块(如末端位姿变化),可直接对接 ROS 2 Action 或 gRPC 服务,与运动规划器、底层控制器无缝衔接。
- 推理引擎适配:简洁的前向结构便于模型转换,可导出 ONNX 或 TensorRT 引擎,实现跨平台低延迟推理,快速嵌入到现有的商用机器人控制柜或工业 PC 中。
- 数据与仿真闭环:兼容 LIBERO、Isaac Sim 等仿真框架,支持在特定场景下做少量域适应微调,降低从开发到部署的迁移成本。
具体落地 Use Case
- 电商仓储自动化:在高吞吐量订单拣选中,移动机械臂接收 WMS 下达的自然语言指令(如“从 C 区第 2 层取红色料箱放至传送带”),通过板载的 RTX 4090 实时推理,以 32 Hz 频率生成抓取和放置动作,适应动态来料与避障需求,显著降低单件履约成本。
- 辅助生活服务机器人:家用机器人仅靠内置的 Jetson Orin 即可运行 TurboVLA,根据老人或残障人士的语音指令(“把桌上的药和水杯拿给我”),在本地完成多步操作规划与执行,无需上云,兼顾隐私与实时性,降低网络抖动带来的安全风险。
局限
- **泛化性验证不足**:实验仅在 **LIBERO** 模拟基准上进行,该环境聚焦于特定的桌面操作任务(拾取、放置、开关抽屉等),未在真实机器人或更具挑战性的场景(如移动操作、长序列多步规划)中评估。与 **LLM-centric VLA** 方法(如 RT-2 / Octo)相比,后者常在大规模互联网数据或多样化机器人数据上预训练,具备更强的视觉、语言理解与迁移能力。TurboVLA 的轻量架构是否同样适用于分布外任务、动态变化或从未见过的物体仍有待证明,限制了其在开放世界部署的可靠性。
- **复杂推理能力可能较弱**:模型采用直接 **V+L→A** 映射,省略了大语言模型作为中间推理引擎的步骤。相比 **LLM-centric VLA**,它缺少链式思维(chain-of-thought)或多轮交互规划的能力,当任务需要根据语言指令进行多步推理、条件判断或工具使用等复杂决策时,可能会遇到困难。论文未提供针对需要推理的 subtask 的成功率分析,因此其对高阶语义的理解上限尚不明确。
- **参数规模与预训练知识的局限**:**0.2B** 参数远小于主流 VLA 模型(通常数 B 至数十 B),虽然带来了效率优势,但也可能限制了其从大规模多模态预训练中受益的程度。轻量的 **Vision-Language Interaction** 模块仅针对机器人操作数据训练,未利用 internet-scale vision-language 预训练权重的丰富常识知识,可能导致其在长尾语言指令或罕见视觉组合上的鲁棒性下降。此外,模型仅支持离散动作 chunk 预测,未探索扩散策略等更先进的 action 生成方式。