MemSFT: 通过外部参数化记忆缓解对齐税
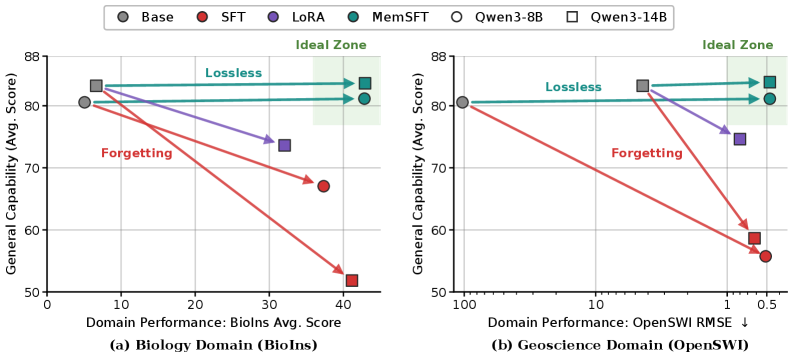
将大型语言模型(LLMs)适配到专业领域常带来 对齐税 问题:在领域数据上微调会导致灾难性遗忘,并明显降低通用任务性能。 为此,我们提出 MemSFT,通过即插即用的 外部参数化记忆 将领域适配与主干参数更新解耦。该记忆被训练为模仿领域数据上非参数检索器的行为,从而记住原本需要通过检索获取的知识与模式。训练完成后,记忆可在不同规模的 LLM 间复用。 生成时,一个学习到的 路由网络 在每一步解码时动态融合记忆与主干的输出分布,有选择地调用领域知识。在生物、地理、法律等领域的评估中,从 Qwen3-8B 到 Qwen3-235B-A22B 的模型均显示 MemSFT 显著提升领域性能,而通用性能几乎不受影响;相比之下,全量 SFT 在通用任务上出现严重遗忘。 结果表明,我们在参数层面走出了将通用能力与领域知识解耦的可行路径,使 LLM 在不牺牲通用能力的前提下获得新专长。
论文精读
TL;DR MemSFT 通过即插即用的外部参数化记忆和动态路由,将领域知识从基座模型参数中解耦,在提升领域性能的同时几乎不损失通用能力,有效缓解了微调带来的对齐税。
问题
问题背景
大语言模型(LLM)的领域适配(domain adaptation)通常通过微调完成,但直接对骨干参数进行领域监督微调(full SFT)会严重损害其在通用任务上的能力,即对齐税(alignment tax)或灾难性遗忘。业界希望在不牺牲通用能力的前提下注入领域知识。
现有方法局限
- 参数级解耦不足:LoRA 等参数高效微调虽然冻结骨干,但仍需修改模型自身的前向计算路径,遗忘现象依旧存在,且适配能力受限于低秩空间。
- 检索增强生成(RAG) 将领域知识外置于文本库,推理时需要实时检索,但检索精度、延迟和上下文窗口限制成为瓶颈,且无法真正“内化”领域特有的推理模式。
- 模型合并与路由策略:近期工作尝试融合多个领域模型,但需要维护多份参数副本,且对路由器设计敏感,难以在 token 级粒度进行动态融合。
为什么这个问题难/重要
领域专精化本质是 稳定性-可塑性困境(stability-plasticity dilemma)的工程化体现:模型必须在学习新知识的同时不覆盖已有的通用能力。全参数微调将领域信号直接写入骨干权重,导致对旧任务的表征破坏。即使引入正则化或重放,也无法彻底消除分布漂移。随着模型规模从 8B 扩展到 235B,全量微调的计算和遗忘代价均急剧升高,而工业界对“一个模型服务多场景”的需求日益强烈,因此可插拔、无需回溯骨干的训练范式成为刚需。
行业类比
如同 自动驾驶感知栈 需要同时保持通用物体识别与新增场景(如施工区锥筒)的准确率,MemSFT 通过外挂“领域记忆模块”实现技能扩展,而非每次改写底层骨干网络。
核心洞察
- **参数化记忆解耦领域知识与模型参数**:MemSFT 将一个可插拔的参数化记忆模块与骨干 LLM 分离,记忆体通过模仿非参数检索器来编码领域知识,从而避免直接更新骨干参数导致的灾难性遗忘。这与全量微调(SFT)或基于回放/正则化的遗忘缓解方法截然不同——它不需要修改或访问原始训练数据,也不依赖骨干梯度,记忆体训练完成后可以直接挂载到不同规模的模型上复用,实现了领域专精与通用能力的参数级彻底分离。
- **Token 级动态路由实现选择性知识调用**:MemSFT 在推理时通过一个轻量路由器在每一步解码动态融合记忆与骨干的输出分布,模型自主决定何时需要领域专长。相比固定插值系数或静态 prompt 组合,这种颗粒度避免了无关 token 上的记忆干扰,既保留了通用任务的流畅性,又在需要时精准激活领域知识,兼顾了专业性与效率,提供了一种更优雅的集成方式。
方法
MemSFT 将领域适配与主干模型参数解耦,引入外部参数化记忆模块和可学习路由器,在不修改原始权重的前提下注入领域知识。
记忆构建与训练
- 首先为领域数据建立非参数检索器(如基于 BM25 或稠密检索),用作教师。
- 参数化记忆(轻量 Transformer decoder)以检索器蒸馏方式训练:输入 query,记忆直接输出 token 分布,目标是最小化其分布与检索器给出的 ground-truth 分布之间的 KL 散度。这样记忆将领域知识内化为参数,相当于将检索过程“编译”进一个小模型。
- 记忆仅需领域数据,与主干 LLM 无关,一份记忆可复用给不同尺寸或家族的模型。
路由器训练
- 路由器为一个小型 MLP,接收当前解码状态(如主干隐状态)为输入,输出融合权重 α ∈ [0,1]。
- 训练时冻结主干和记忆,仅优化路由器参数,使用下一 token 预测的交叉熵损失,通过逐 token 动态混合记忆分布与主干分布实现自适应调用。
推理流程
- 输入 prompt 送入主干和记忆;
- 每一步解码,路由器输出权重 α;
- 最终分布 = α × 记忆分布 + (1-α) × 主干分布;
- 从混合分布采样 token,继续生成。
与 LoRA 等参数高效微调不同,MemSFT 完全不更新主干参数,从而几乎消除灾难性遗忘;与普通检索增强生成(RAG)相比,它通过紧凑的参数化记忆和端到端训练的路由,避免了每次生成的检索开销,并实现更细粒度的 token 级知识融合。
实验
实验设计
MemSFT 在三个垂直领域(生物学、地球科学、法律)上进行验证,覆盖 Biology-Instructions、OpenSWI 和 LawBench 等数据集。评估采用 Qwen3 系列模型(8B 到 235B-A22B),既考察领域专精任务性能,也考察通用基准(如 MMLU)的保持率,以量化对齐税。对比基线包括:全量 SFT、LoRA 微调以及各类遗忘缓解策略。记忆模块针对每个领域独立训练,轻量级路由器 在每步解码时动态融合主干与记忆的输出分布,记忆本身可跨不同尺寸模型复用。
关键发现
- 领域性能提升:在所有领域中,MemSFT 均带来显著的任务指标增益,而通用性能退化极小,接近零遗忘。
- 全量 SFT 严重遗忘:相比之下,标准 SFT 在领域数据上微调后,通用能力大幅下降,体现了显著的对齐税。
- 跨模型复用:同一领域记忆模块可直接应用于不同规模的 Qwen3 模型,无需重复训练,节省算力。
- 选择性路由:路由器能识别与领域相关的 token,仅在必要时调用记忆,避免干扰非领域上下文。
与基线对比的深度解读
与全量 SFT 相比,MemSFT 解耦了参数更新,主干权重保持不变,从而根治灾难性遗忘。相较于检索增强生成(RAG),MemSFT 将检索知识“蒸馏”进参数记忆,在推理时避免延迟和检索误差,且记忆输出的分布可直接与模型预测融合。与 LoRA 等参数高效微调相比,MemSFT 的记忆不仅可累加、可复用,还通过 token 级路由实现更精细的控制。此外,实验表明,学习型路由 优于固定插值权重,因为它能根据上下文动态决定融合强度,在保持通用能力的同时最大化领域专长。这种机制为多领域扩展提供了清晰路径:只需插入对应记忆,无需修改基座模型。
行业影响
落地场景
MemSFT 通过外部参数化记忆模块实现领域专业化,无需修改骨干模型权重,适合以下场景:
- 垂直领域客服或知识助手:如法律咨询、医疗问诊、金融投研,需要模型精确引用领域知识,同时保持通用对话能力。
- 多租户 SaaS 平台:同一基座模型为不同客户提供定制化服务,每个客户可加载独立记忆模块,避免模型膨胀和版本管理混乱。
- 频繁更新的知识库:如电商搜索、新闻推荐,领域数据持续变化,记忆模块可独立重训或替换,不影响基座稳定性。
商业价值
- 降低维护成本:告别全参数微调(Full SFT),对于千亿级模型,记忆模块参数量远小于骨干,训练与推理的 FLOPs 开销显著降低,且可跨模型尺寸复用,避免重复训练。
- 提升用户体验与留存:在专业任务上准确率提升,同时通用任务性能几乎无损(遗忘问题缓解),用户无需在“专业版”和“通用版”之间二选一,有助于产品在专业场景下的采纳率。
- 加速交付周期:新领域知识的上线从重训大模型变为训练轻量记忆模块,结合动态路由实现热插拔,缩短模型迭代时间,快速响应业务需求。
与现有产品/工作流的接口
MemSFT 以即插即用模式集成:
- 推理部署:记忆模块与路由器的输出分布通过动态融合介入生成过程,可在现有 vLLM、TGI 等推理框架中通过自定义 logits processor 或 adapter 层实现,无需改动模型主体。
- 检索增强流水线:记忆模块可视为对非参数检索器(retriever)行为的压缩蒸馏,可替代或补充 RAG 中的查询-文档检索步骤,减少检索延迟和上下文窗口占用。
- 模型管理:采用类似 LoRA 插件的管理方式,记忆权重独立存储,通过配置注入不同领域,便于版本控制和 A/B 测试。
具体落地 use case
- 跨国电商平台的多语言商品问答:基座模型为通用多语言 ChatBot,为每个主打市场(如电子、家居品类)训练一个 MemSFT 模块,动态路由在用户询问具体商品参数、保修政策时自动激活对应领域知识,避免全模型微调带来的语言能力退化。
- 医疗影像报告生成辅助:在通用视觉语言模型之上,为不同科室(放射科、病理科)训练记忆模块,路由器根据当前影像类型和描述上下文选择调用,确保报告术语准确,且不影响模型对正常解剖变异的描述能力,同时降低因全参数微调导致的罕见病知识遗忘风险。
局限
- **对检索教师质量的依赖**:MemSFT 的记忆训练以非参数检索器(如 BM25)为教师,模仿其从领域数据库中检索的结果。因此,记忆模块的上限受到检索器性能的约束;若检索器在特定任务上召回质量差或噪声高,记忆习得的知识也会受限。论文未系统消融不同质量教师对最终性能的影响,实际部署中若领域数据稀疏或检索退化,可能导致记忆效果下降。
- **推理开销与动态路由复杂度**:推理时每一步解码都需要将输入同时通过记忆骨干和原 LLM 骨干,并由路由器计算融合权重,增加了计算和显存负担,尤其在大模型上可能不可忽视。虽然论文给出了适配计算量(Adaptation FLOPs)的分析,但未详细报告端到端推理延迟增加。与直接使用检索增强生成(RAG)相比,MemSFT 将检索过程隐式参数化,失去了实时检索的灵活性和可解释性,知识更新需重新训练记忆。
- **领域专项训练代价与泛化风险**:尽管记忆模块训后可跨不同尺寸 LLM 重用,但每个新领域仍需构建检索教师、收集训练数据并训练记忆和路由器,当领域众多时总训练成本不低。此外,路由器的训练数据需覆盖领域与通用场景的混合样本,否则可能出现路由器偏向某一侧或通用任务上误触发记忆的情况。论文只在三个领域(生物、地球科学、法律)验证,更多异构领域的记忆训练稳定性和跨任务泛化尚未充分探索。