Mage-VL: 高效编解码原生流式多模态基础模型
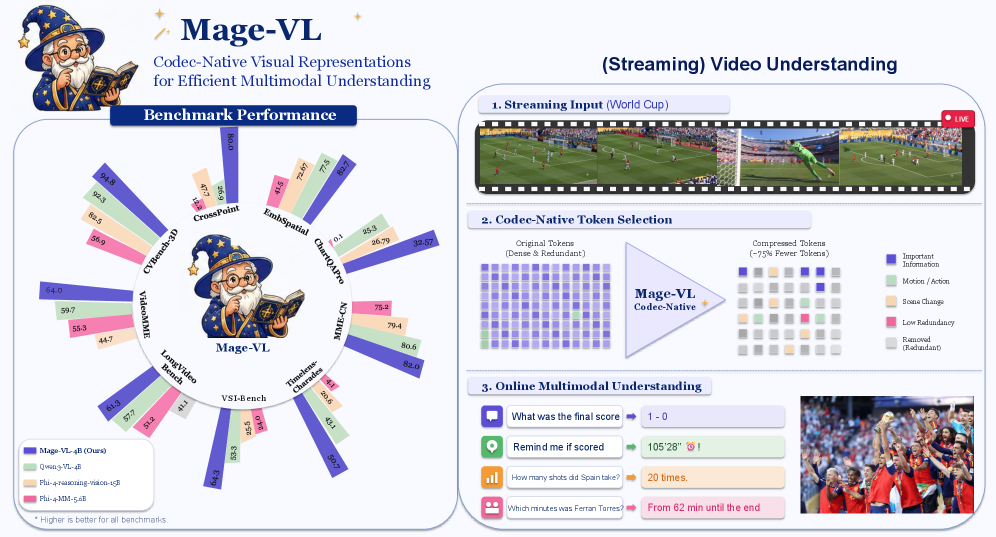
标准视觉语言模型 (VLM) 面临 Moravec's paradox:在复杂离线视觉推理中表现优异,却难以高效处理简单的流式感知任务。本文提出 Mage-VL,一种高效编解码原生流式基础模型,专为实时多模态理解与交互设计。 核心创新在于自定义分词器 Mage-ViT:它抛弃均匀帧采样,转而利用运动向量和残差能量选择性编码动态、熵密集区域,在稀疏锚 (I) 帧与预测 (P) 帧上进行操作。以 16x16 块粒度运行,视觉令牌消耗降低 75% 以上,同时保留时空上下文。在约 5.6 亿未标注图像和 1 亿未标注视频帧上从头训练,Mage-ViT 匹配甚至超越基于数十亿图文对训练的旗舰编码器。此外,我们建立了 AI4AI 数据流水线,涵盖提示-代码联合优化多模态字幕生成,以及 AI 驱动性能诊断以指导训练配方。 通过生物启发的双系统架构——轻量 System 1 事件门与因果 System 2 解码器——Mage-VL 实现主动流式感知。大量评估表明,Mage-VL-4B 在静态任务上匹配 Qwen3-VL-4B,在视频理解与 2D/3D 空间推理上取得强劲提升,推理速度加速高达 3.5x,全面超越 15B 的 Phi-4-reasoning-vision 基线。除模型本身外,我们还贡献了七项关键实证发现,涵盖预训练数据效率、可变分辨率缩放、编解码系统加速、VideoQA SFT 冗余、运动-空间协同、AI4AI 数据流水线以及用于多模态 RL 的 Zero-Vision SFT。
论文精读
TL;DR Mage-VL 通过 codec 原生视觉分词器选择性编码运动丰富区域,将视觉 token 减少 75% 以上,结合双系统流式架构,在实时视频理解上实现 3.5 倍加速,4B 模型性能超越 15B 基线。
问题
问题背景
当前,视觉-语言模型(VLM)在离线图像理解、复杂视觉推理等静态任务上已取得显著进展,然而在实时流式视频感知场景中,其能力与效率仍远未满足实际需求。业界对自主驾驶、机器人操控、沉浸式交互等应用的实时性要求,使得流式多模态理解成为前沿热点。
现有方法局限
主流 VLM 大多采用均匀帧采样策略,将每一帧的全体 patch 无差别编码为视觉 token,导致大量计算浪费在静态背景或冗余信息上。这种设计带来三个关键问题:
- 计算-感知失衡:简单流式任务(如运动检测)消耗与复杂推理同等的算力,违反 Moravec 悖论;
- 长视频不可持续:随着输入帧数增长,视觉 token 数量线性膨胀,推理延迟和内存占用急剧上升;
- 缺乏时间选择性:对帧间变化不敏感,难以在不增加预算的前提下捕获短时突发动态。 部分流式模型尝试降低帧率或使用轻量编码器,但通常牺牲了时空上下文精度,无法在吞吐与准确度之间取得 Pareto 最优。
技术挑战与重要性
流式视频理解的难点在于如何用低 token 预算表达高熵时空区域。这要求 tokenizer 具备选择性编码能力,能自主判断哪些时空块需要被模型处理,而这种选择的“门控”机制又必须与下游语言解码器无缝衔接。同时,如何在预训练数据匮乏(未标注视频庞大但精细标注少)的条件下训练出强大的流式编码器,也是一大瓶颈。业界对实时多模态交互的需求日益迫切,能兼顾效率与性能的流式基础模型将成为下一代 VLM 的关键进化方向。
行业类比
这类似于自动驾驶感知系统:激光雷达/摄像头需要以毫秒级延迟识别切入车辆或行人,却无需对护栏、天空等静态背景逐帧“深度思考”,高效的感兴趣区域 token 选择直接決定系统安全边界。
核心洞察
- 编解码器原生选择性 token 化 (codec-native selective tokenization) 打破了视觉冗余与实时性之间的矛盾。现有 VLM 依赖均匀帧采样, 在流式场景中产生大量冗余 token, 导致计算浪费与延迟。Mage-ViT 利用 I/P 帧的运动向量与残差能量, 仅在 16×16 patch 级动态选择熵密集区域编码, token 减少超 75%, 同时保持时空上下文。对比常规固定分辨率或随机稀疏采样, 这一策略从编解码层天然对齐流式传输的压缩结构, 使得推理墙钟加速可达 3.5 倍, 为实时多模态应用提供了新的效率基准。
- 生物启发式双系统架构 (System 1 event gate + System 2 decoder) 将流式感知从被动等待转为主动触发。模型通过轻量级事件门持续监测输入流, 当检测到关键事件(如动作切换、物体出现)时, 才唤醒因果解码器进行上下文推理, 而非对每一帧都做全量计算。该设计模仿了人类认知中快速直觉系统与慢速分析系统的协同, 与现有在线 VLM 的全帧密集处理形成鲜明对比, 在流式视频问答和空间推理中表现出更强的响应及时性与准确性, 为机器人、自动驾驶等代理型任务提供了低延迟、高可靠的架构范式。
方法
整体流程
Mage-VL 的输入为图像或视频流,输出为自然语言响应或动作。其核心流水线可概括为:原始像素 → Codec-Native 视觉编码 → 视觉-语言投影 → 双系统推理 → 文本生成。
关键模块
Mage-ViT(Codec-Native 视觉编码器)
抛弃了均匀帧采样,直接利用视频编解码器(codec)中的运动向量与残差能量来识别动态、高熵区域。它将稀疏的 I 帧(完整图像)和 P 帧(预测差异)下采样到 16×16 的 patch 级别,仅对显著变化的 patch 进行编码,而非对整个帧做密集 tokenization。这一设计使视觉 token 消耗降低 75% 以上,同时保留了时空上下文。预训练分两阶段:先用 5.6 亿张无标注图像进行可变分辨率图像预训练,再联合 1 亿段无标注视频帧进行联合预训练,仅用对比学习就取得了与十亿级图文对训练的旗舰编码器相当的性能。统一架构
Mage-ViT 输出的视觉 token 通过一个轻量级视觉-语言投影器(MLP)映射到大语言模型的词嵌入空间。后续的因果语言解码器(即 System 2)负责深层理解和生成。模型采用了一套仿生双系统机制:- System 1 事件门:一个极其轻量的模块,持续监控特征流,快速判断是否有值得响应的“事件”,从而实现主动流式感知,而非被动等待固定时间窗。
- System 2 因果解码器:当事件门被触发时激活,对累积的视觉 token 进行因果推理并生成回复。
训练策略
- 渐进式课程:依次进行多模态对齐(caption)、指令微调与短时序定位、时间跨度扩展(长视频)、codec-native 长上下文适应,最后通过认知-门控微调实现主动流式对齐。
- AI4AI 数据管道:利用 prompt-code 联合优化生成高质量多模态标注,并由 AI 诊断训练效果以调整配方。
与同类工作的关键差异
传统 VLM 需将压缩视频完全解码为全帧后再均匀采样,计算量大且忽略时域冗余;Mage-VL 直接在压缩域内基于运动特征进行选择性编码,并与双系统流式推理深度耦合,因而在保持离线任务精度的同时,取得了显著的推理加速和流式感知能力提升。
实验
实验从两个层面展开:首先验证Mage-ViT 视觉编码器的表示质量和数据效率,其次评估集成后的Mage-VL 多模态模型在静态图像、视频理解及流式感知上的表现。Mage-ViT仅用560M图像和100M视频帧预训练,在图像和视频表征基准上与使用数十亿图文对训练的旗舰编码器不相上下。Mage-VL-4B模型在静态任务上与Qwen3-VL-4B 持平,同时在视频理解和2D/3D空间推理上获得显著提升,推理时延降低最高3.5倍;并且全面超越15B参数量的Phi-4-reasoning-vision 基线。这些结果表明,选择性编解码驱动token化策略(减少>75%视觉token)与双系统流式架构相结合,在保持高精度前提下显著提升了多模态模型的实时处理效率,为实际部署带来了实质性加速。
行业影响
落地场景
Mage-VL 的codec-native 流式架构天然适配对实时性敏感的多模态交互场景:
- 视频监控与工业质检:利用 motion vector 与残差能量选择性编码动态区域,可在边缘设备上实现高效异常事件检测,减少 75% 以上的 token 消耗,显著降低带宽与计算需求。
- 实时音视频会议与直播:通过 System 1 事件门控 机制,模型可主动识别关键帧并触发即时响应(如自动字幕、实时翻译、内容审核),取代传统的 uniform sampling 模式。
- 自动驾驶与机器人视觉:codec 原生的锚帧(I)与预测帧(P)机制与车辆总线数据流高度匹配,支持在线 2D/3D 空间推理与预测性规划。
- 教育/内容平台:动态编码视频文本,用于实时课堂互动、视频问答,或流式生成高密度文案(如体育集锦自动解说)。
商业价值
- 降本:在同等视觉性能下,token 预算减少超过 75%,直接降低大模型推理的算力开销;在低功耗设备上实现接近旗舰模型的精度,减少对云端 GPU 的依赖。
- 增收:流式能力催生新的交互形态,例如实时视频购物助手可在用户浏览商品时即刻提供属性解释与优惠推荐,提升转化率。
- 体验提升:3.5× wall-clock 加速与毫秒级响应使应用体验更流畅,尤其在视频客服、远程医疗等场景中,延迟降低可增加用户信任和满意度。
与现有产品/工作流的接口
Mage-VL 的codec-native 设计可与现有多媒体编解码管线高效集成:
- 视频处理 pipeline:直接对接 H.264/H.265/AV1 等标准码流,无需重新训练专用 tokenizer。Mage-ViT 可嵌入现有视频分析框架,替代传统帧采样模块。
- 大模型 stack:项目级 MLP 投影层和 causal language decoder 兼容主流 LLaMA/Qwen 家族,可作为 drop-in 替换视觉编码器,搭配 vLLM 或 SGLang 等推理引擎实现流式输出。
- 数据闭环:其 AI4AI data pipeline 提供从 prompt 联合优化到性能诊断的全链路自动化,可集成到 MLOps 平台中,持续优化多模态模型。
具体落地用例
- 电商直播实时交互:在商品展示过程中,模型根据主播动作和画面熵变化动态提取关键帧,实时理解产品细节并生成个性化推荐话术,延迟低于 200ms。相比现有基于均匀采样的 VLM,推理速度快 3 倍以上,允许在同一 GPU 上支撑更多路流。
- 自动驾驶在线场景理解:直接消费车载摄像头的编码流,利用 P 帧运动向量快速追踪移动目标,并在 I 帧上进行细粒度语义分析。由于无需解码全帧,端侧芯片推理功耗降低 60% 以上,同时保持与高精度离线模型一致的感知结果,支持 L2+ 级辅助驾驶功能。
局限
- **Codec 依赖性限制通用性**:Mage-ViT 的 token 选择完全依赖视频编码器提供的运动向量与残差能量信息,这要求输入视频必须经过预先编码(如 H.264/H.265)。在直接处理原始传感器流或非压缩域数据(如某些机器人视觉输入)时,需额外引入在线编码步骤,可能引入延迟并增加计算开销。此外,运动向量难以捕捉语义显著但运动微弱的区域(如缓慢变化的仪表读数),导致这类信息可能被系统性遗漏。
- **流式事件门控的漏检风险**:System 1 事件门采用轻量设计以降低延迟,但其基于运动、对比度等低层线索的触发机制,可能漏掉高语义重要性但外观变化细微的事件(如远距离小目标出现、文本提示变化)。论文在 streaming 基准上的评估主要针对常见动作识别与时空定位,尚未覆盖长尾、多模态的细粒度事件检测,因此该机制在复杂真实场景中的召回率仍需验证。
- **Zero-Vision SFT 仍属早期探索**:论文提出 Zero-Vision SFT 旨在解锁 agent 能力,但仅做了初步验证,未与现有强化学习或多模态 agent 框架进行全面对比。目前实验局限于少数模拟环境,其泛化到开放域物理交互任务的能力未知。同时,将视觉编码器完全剥离后,模型对视觉常识的依赖大幅降低,可能不利于需要精确空间感知的指令执行,这一权衡的边界尚未量化。