DecoupleMix: 解耦比率搜索与凸分配用于可扩展的VLM数据配方
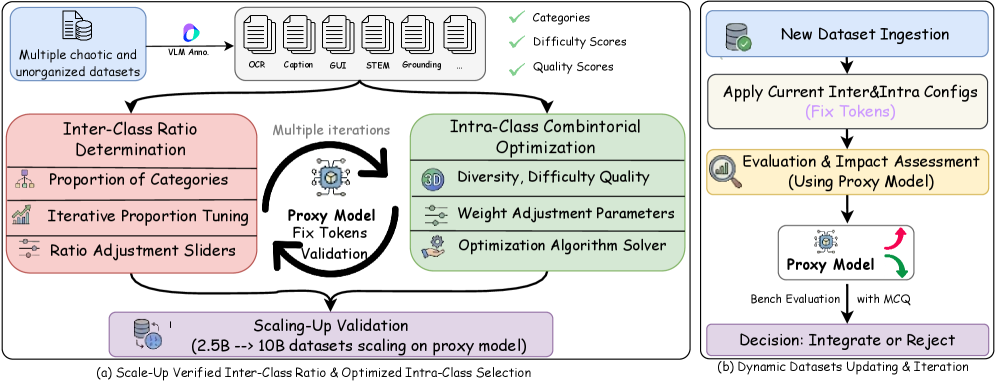
尽管视觉语言模型(VLM)的数据整理日益活跃,但构建预训练混合数据的公开实践仍主要依赖启发式方法:从业者堆叠通过质量过滤的数据集,凭直觉设定跨域比率,缺乏接纳新数据的可归因原则,而前沿配方仍未公开。 本文将数据构建形式化为一个系统性的混合优化问题,通过将混合解耦为两个正交子问题——跨能力的类间比率和类别内的类内比率,将其转化为可复现的工程学科。对于类间分配,采用单变量迭代搜索;对于类内组合,应用多维数据集级评估评分质量和难度,并将选择形式化为具有多样性目标的约束凸优化。DecoupleMix框架具备两个关键能力:指导下一步收集何种数据,以及使数据集验证成为可控、可归因的实验。 实验表明,该方法始终优于启发式基线。此外,在小规模代理上发现的最优比率无需重新调整即可无缝迁移至更大规模。使用额外的80B多模态继续预训练令牌,我们的VLM与使用更大多模态预算训练的强开源模型具有竞争力。
论文精读
TL;DR 解耦 VLM 预训练数据配比,用迭代搜索与凸优化自动构建多模态数据配方,性能超越启发式方法且可扩展迁移。
问题
问题背景
VLM 多模态预训练的数据配方日益重要,但公开方法仍停留在启发式直觉阶段,前沿团队的配方并未公开,导致工程实践缺乏可复现的准则。
现有方法局限
- 堆砌式构建:只简单合并通过质量筛选的数据集,忽视数据集间的交互与冗余。
- 比例设定主观:跨域(如图文对齐、OCR、数学等)的配比依赖人工经验,无量化指标支撑。
- 新数据接纳无原则:加入新数据集时无可归因的实验设计,无法判断其独立贡献。
- 问题耦合:跨类别能力覆盖(宏观比例)与类别内样本组成(微观分配)被混为一谈,导致搜索空间呈指数级爆炸,难以系统优化。
技术挑战与重要性
- 组合优化复杂度高:同时优化数十个数据集的混合比例,传统网格搜索或手工调参无法胜任。
- 评估成本巨大:每次完整的预训练与评测开销极高,要求方法在小规模代理上快速收敛且结果可迁移。
- 可迁移性关键:小规模上发现的最优比例必须能无缝迁移至大规模训练,否则搜索成本无法摊销,失去工程价值。
- 业界壁垒:数据配方直接决定模型性能上限,是 VLM 竞争的核心护城河,亟需工程化的优化框架。
行业类比
类似推荐系统中召回与排序的解耦设计,将混合优化拆分为跨类别比例的一维搜索与类别内凸优化分配,使问题可解且结果可归因。
核心洞察
- **解耦数据混合优化**:将 VLM 预训练数据配方分解为跨类别的比例搜索与类别内的多样性凸优化,使数据工程从启发式堆叠变为可复现的系统化流程。与以往仅凭直觉或质量过滤后堆叠数据集的做法不同,DecoupleMix 首次在类间用单变量迭代搜索全局比例,在类内通过 **质量** 与 **难度** 评分构建带多样性约束的凸优化,使得每次数据选入都有明确的归因依据,并能为“下一步该收集什么数据”提供决策信号,具有极高的工程可操作性。
- **小规模代理搜索的缩放可迁移性**:在小模型和小数据上搜索到的最优类别比例,可直接迁移到更大的模型与训练规模,无需重新调优,显著降低配方寻优的算力成本。过往方法常因训练动态的耦合导致代理任务最优解在放量后失效,而 DecoupleMix 利用解耦后的比例搜索,证明了该比例具有跨模型尺寸与数据量的鲁棒性,只需在低预算代理上摊销一次寻优,即可持续为更大尺度训练提供指导,这对工业化数据工程具有重要启示。
方法
输入:候选多模态数据池
将多模态预训练数据按能力(如 OCR、自然图像理解、图表推理等)划分为多个类别,每个类别下包含若干候选数据集。
关键模块
1. 自动数据集级评估 (Automated Dataset-Level Assessment) 对每个数据集进行质量和难度评分。质量评估考察数据是否清晰、无噪声、与任务对齐;难度评估衡量样本对当前模型的挑战程度。同时,利用 embedder 对数据集进行多样性表征,为后续优化提供距离度量。
2. 解耦混合优化 (Decoupled Mixture Optimization) 将数据配方设计分解为两个正交子问题:
- 类间比例搜索 (Inter-class Ratio Search):跨能力类别的宏观预算分配。采用单变量迭代搜索,每次固定其他类别比例,仅优化一个类别的采样权重,以验证集性能指标(如 MMBench 得分)作为反馈信号,逐步收敛至全局最优的类别级配比。
- 类内凸优化分配 (Intra-class Convex Allocation):在每个类别内部,基于数据集的质量、难度评分及多样性嵌入,构建以最大化多样性为目标的约束凸优化问题。优化目标为最大化所选数据集子集之间的总多样性,同时受质量阈值与难度范围约束,通过求解该凸问题得到每个数据集的精细采样权重。算法确保在保持高质量和高困惑度的同时,避免冗余数据过度采样。
3. 可归因验证 (Attributable Validation) 新数据集的加入被设计为受控实验:固定其他类别的类间比例,仅在对应类内重新运行凸优化,从而将性能变化严格归因于新数据集的引入。这一能力使数据工程从“尝试堆叠”走向“可衡量的增量迭代”。
输出:可迁移的混合配方
最终产出一组解耦的采样权重配置(类间比例 + 各类内数据集分配),在小规模代理模型上搜索出的最优配方可直接应用于更大规模训练,无需重新调参。
与同类方法的差异点:DecoupleMix 将宏观比例搜索与微观数据集选择彻底解耦,并通过凸优化保证类内分配的全局最优性,相较启发式或联合优化方法,显著提升了可扩展性与配方迁移性。
实验
实验设计
作者将多模态预训练数据配比建模为系统性优化问题,并解耦为两个正交子问题:类间比例(跨能力类别,如 OCR、通用视觉理解等)和类内比例(同一能力类别下不同数据集的混合比)。类间采用单变量迭代搜索,类内则引入数据集级的多维评估(质量与难度),以多样性为目标的约束凸优化进行分配。实验在小规模代理任务上搜索最优配比,然后直接应用到 80B token 级别的多模态继续预训练,验证缩放迁移性。评估矩阵涵盖 MMBench、CharXiv 等多模态基准。
关键发现
- 一致优于启发式基线:在所有评测集合上,DecoupleMix 搜索到的数据配比显著超越简单堆砌高质量数据、凭直觉分配比例的常用做法。
- 缩放定律与迁移性:在代理尺度(小模型、少 token)获得的类间/类内比例,可直接迁移到 80B token 的大规模训练,无需重新调整,展现了极强的泛化能力。
- 收益集中区域:提升主要来自类间比例的宏观结构优化,类内凸优化在平衡数据分布中进一步带来稳定增益。
- 可归因验证:方法支持单数据集准入的受控实验,能清晰量化新增数据集对整体性能的边际贡献,从而指导数据采集策略。
与基线对比的深度解读
主流实践仍依赖启发式:从业者堆叠通过质量过滤的数据集,凭直觉设定跨域比例,缺乏系统性的、可归因的准入标准。这种方式在面对海量新数据时难以决策,且最优配比不可复现。DecoupleMix 将其转化为可重复的工程准则:通过解耦,将复杂的多维搜索降解为低成本的迭代与凸优化,使决策过程透明、可解释、可迁移。实验表明,该方法在同等数据预算下可获得更好性能,并且发现的配比无需随着数据或模型规模增大而重新搜索,大幅降低了实际工程中的试验成本。这种“小规模搜索、大规模应用”的范式为大规模多模态数据工程提供了新的工作流程模板。
行业影响
落地场景
DecoupleMix 将多模态预训练数据配比从依赖直觉的启发式工程,转变为可解耦、可归因的优化流程,直接适用于任何需要构建大规模图文混合预训练语料的场景。典型应用包括:
- 基础视觉语言模型(VLM)厂商:在训练通用多模态模型(如 LLaVA-Next、Qwen-VL 系列)时,自动搜索各类多模态能力(OCR、图表理解、常识推理等)间的类别间配比,并基于 Quality & Difficulty 维度做类别内数据集级凸优化筛选,取代人工堆叠过滤数据集。
- 垂直行业模型开发:例如医疗影像报告生成、电商多模态搜索、工业缺陷检测等,可利用该框架在小规模代理任务上快速搜出最优数据配方,直接迁移到大模型训练,避免反复试错。
商业价值
- 降本:将配方搜索在小规模代理实验上完成,最优配比直接迁移到 full-scale 训练,大幅降低大模型实验的算力浪费。论文在 80B token 继续预训练上即获得竞争力,相比动辄使用数百 B token 的方案节省大量 GPU 预算。
- 可归因的数据投资决策:通过可归因验证流程,团队能明确量化每新增一个数据集的边际收益,直接指导数据采集外包的投入方向,避免采集无用数据。
- 缩短研发周期:从“直觉式配比→全量训练→评估→重调”的循环,变为一次小规模自动化搜索 + 一次 scale-up,显著加速模型迭代。
与现有产品/工作流的接口
- 数据管线:框架要求对候选数据集进行自动化评估(Quality 和 Difficulty 的打分),这可通过调用现有 VLM 评估模型(如 GPT-4V、Qwen-VL-2.5-72B)或内部评分服务实现,可自然嵌入已有数据治理平台。
- 训练框架:解耦后的配比仅影响数据采样阶段的权重和 shuffle 逻辑,与主流分布式训练框架(如 Megatron-Core、FSDP)完全兼容,无需改动模型结构或优化器。
- 实验管理:代理搜索与大规模训练沿用同一评估基准(如 MMBench、CharXiv),可直接整合进 MLflow 或 Weights & Biases,实现从配方搜索到模型交付的全链路追踪。
具体落地 Use Case
- 电商多模态搜索模型训练:平台拥有海量商品图、多语言描述、属性表、用户问答等多源数据。使用 DecoupleMix 可以将“商品识别”“属性抽取”“跨模态匹配”等能力定义为不同类别,通过自动搜索给出各类数据的最优配比;类别内再依据难度/质量筛选出高价值样本组合。最终在 1/10 的 token 预算下训练出同等效果的搜索基座模型,直接降低 GPU 成本,同时加快模型季度更新节奏。
- 自动驾驶感知模型数据配比:场景数据(白天/黑夜、城市/高速、晴/雨)和任务类型(检测、跟踪、预测)构成天然的多类别结构。团队可在少量里程代理集上搜出最佳类别间比例,并将难以处理的 corner case 样本通过 Difficulty 评分提权采样,避免昂贵的长尾数据人工筛选,实现数据驱动的高效模型迭代。
局限
- **自动化评估的准确性依赖人工校准**。论文通过自动化流程对数据集进行 Quality 和 Difficulty 评分,但其可靠性取决于评分 prompt 与人类偏好的一致性。作者仅在附录 B.1 中进行了有限的人类对齐验证,如果评分器对某些数据分布存在系统性偏差,将直接传导至最终的混合比例,导致次优配方。此外,评估流程本身也需要计算资源,当新增大量数据集时,预评估成本可能不可忽视。
- **解耦假设与搜索的局限性**。方法将混合优化分解为独立的 inter-class 和 intra-class 子问题,假设类别间比率固定后类别内选择不受影响。但实际不同类别的数据难度和多样性可能存在交叉影响,完全解耦可能损失全局最优性。同时,inter-class 采用单变量迭代搜索,在高维类别空间下容易陷入局部最优,且搜索时使用的代理模型规模较小,虽然实验显示可迁移,但不排除在更大规模或不同架构上出现偏移。
- **未考虑数据顺序与动态分配**。DecoupleMix 仅确定静态的全局混合比例,忽略了训练过程中不同阶段对数据需求的变化(如课程学习效果)。相比一些在线数据选择方法(如 DoReMi、动态重加权),静态配方可能在后期导致低效或遗忘。此外,与直接对每个样本加权的优化方法(如 DRO)相比,DecoupleMix 的样本选择粒度较粗,仅限于数据集级别,可能在样本级多样性和重要性捕捉上存在不足。