相关性的新角色:引导智能搜索中的语料库交互
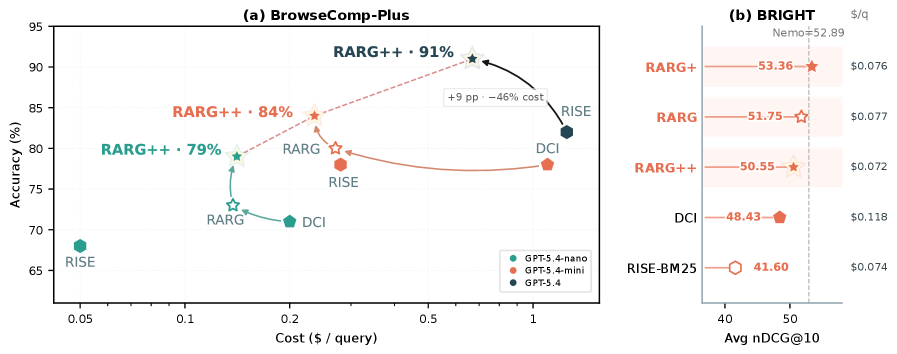
相关性(relevance)是一种基于查询的估计,判断文档或片段是否包含有用证据。现有检索代理使用相关性来选择 top-k 内容,但仅凭文档相关性无法定位、组合或验证复杂问题所需的证据。直接语料库交互(Direct Corpus Interaction, DCI) 通过 grep 式探索实现此类细粒度操作,但其无关相关性的搜索可能延迟揭示有用线索,导致收敛缓慢。 近期进展利用相关性将语料库缩小为交互的工作空间。然而,一旦交互开始,相关性仍未直接指导 grep 优先搜索哪些文档,或从大量匹配中区分信息丰富的片段,以便让 LLM 优先查看。我们提出 RARG(Relevance-Aware RipGrep Search Agent),将相关性转化为语料库交互的执行先验。RARG 提供从粗到细的相关性引导: 1. 对文档进行排序以实现顺序的 ripgrep 遍历,从而更早暴露全局相关线索; 2. 用查询相关段落初始化有潜力的入口点; 3. 对 grep 匹配进行重排序,以展示文档级排序可能掩盖的信息丰富片段。 在具有挑战性的浏览问答和推理密集型检索任务中,与基于检索和直接交互的代理相比,RARG 提升了准确率-效率前沿。这些结果表明,相关性感知交互能够实现更快、更可靠的搜索收敛。
论文精读
TL;DR RARG 将相关性作为搜索执行先验,通过文档排序、入口初始化和匹配重排序,引导 grep 搜索提前暴露关键证据,在复杂检索中实现更快收敛和更高准确率。
问题
近年来,Agentic Search 成为信息检索的焦点方向,旨在让 LLM 自主与大规模语料交互,以解决多跳推理、证据验证等复杂问题。
现有方法的局限
- 检索式智能体 仅利用文档级相关性截取 top-k 内容,无法执行细粒度的证据定位、组合与验证。
- 直接语料交互(DCI) 通过类 grep 工具提供灵活的探索能力,但其搜索过程 完全忽略相关性信号,使得关键线索出现滞后,导致 LLM 上下文窗口浪费与收敛缓慢。
- 即使有工作先用相关性预筛出子语料,交互启动后,相关性便不再参与——既不决定文档的搜索优先级,也难以从大量同类匹配中自动识别信息量更高的片段。
为何困难且重要
传统相关性排序设计面向静态结果展示,而交互式探索要求将相关性转化为 可实时执行的粗到细引导,包括文档遍历顺序、入口段落选择及匹配重排等低延迟决策。该问题直接制约 RAG 在长尾问答、推理密集型检索任务上的 准确率–效率边界,是实现可靠 Agentic IR 的核心瓶颈。
行业类比
如同 AI 辅助编程中的代码仓库搜索:不仅要找到相关文件,更要 让最可能解决问题的代码块最先呈现,否则开发者将被大量低信息量匹配淹没,推理效率急剧下降。
核心洞察
- 传统 Direct Corpus Interaction (DCI) 将相关性仅用于选择初始语料子集,一旦交互开始,搜索顺序与匹配筛选完全由模式匹配驱动,与查询语义脱节,导致关键证据延迟暴露。RARG 首次将相关性建模为贯穿交互全过程的执行先验:文档级排序决定遍历顺序,段落级定位初始化搜索入口,匹配级重排序过滤搜索结果,使每一次 grep 探索都与查询意图对齐。这改变了 Agentic Search 中“检索—交互”两阶段割裂的现状,让交互本身成为相关性的函数。
- RARG 的粗到细引导策略在文档、入口点、匹配三个粒度上注入相关性信号,解决了复杂问答中证据需要跨段落组合与验证的难题。与现有仅依赖 top-k 文档或盲目 grep 扩散的智能体不同,RARG 先通过文档排序将全局相关线索前移,再用段落嵌入选择高质量起始点,最后用稠密检索重排序排除无关匹配——三层接力大幅减少了 LLM 看到的低信息量摘录,在浏览式 QA 和推理密集型检索任务上同时提升了精度与效率,为构建可控、可解释的搜索智能体提供了明确的架构模板。
方法
RARG 将查询相关的估计作为执行先验注入直接语料交互(DCI)流程,形成三级从粗到细的引导:
- 文档级相关性排序:利用稠密检索器获得候选文档的相关性分数,对文档列表按相关性降序排列。代理在迭代调用
ripgrep时,按此顺序依次遍历,确保全局相关度高的文档优先被搜索,提前暴露有用线索。 - 入口点初始化:对于每篇待交互文档,RARG 不再从开头盲目扫描,而是选取与查询最相关的段落(如通过 BM25 或嵌入相似度定位)作为
ripgrep的起始搜索位置,使代理直接跳转到信息密集区域,减少无效探索。 - 匹配级相关性重排序:
ripgrep返回的匹配行集合通常按文档顺序或匹配位置排列,关键摘录易被噪声淹没。RARG 在此阶段插入轻量级重排器(例如跨编码器),对匹配片段重新按查询相关性排序,将信息量高的摘录优先呈现给 LLM,让模型第一时间看到最具价值的证据。
代理通过多轮 ripgrep、open、view 等工具调用循环收集证据并生成最终答案。与纯检索代理仅使用 top-k 文档不同,RARG 保留了 DCI 对语料的细粒度定位与组合能力;与无相关性的 DCI 代理相比,RARG 利用相关性先验显著加速搜索收敛,在相同预算下获得更高准确率。
实验
实验设计
RARG 在两个挑战性任务上评估:BC+(浏览式问答)和 BRIGHT(推理密集型检索)。基线包括基于检索的代理(仅用 top-k 文档)和直接语料交互代理(无相关性引导的 grep 搜索)。实验还验证了不同相关性先验策略的消融(文档排序、入口初始化、匹配重排序),并测试了语料规模扩展(1k 到 10k 文档)。指标关注准确率与效率(如交互轮次、Token 消耗)。
关键发现
RARG 在准确率–效率前沿上均优于基线。相关性引导使搜索更早暴露有用线索,显著减少收敛所需轮次。文档级排序让全局相关文档被优先遍历,匹配重排序则在 grep 匹配集中提取信息量高的片段给 LLM 先行审阅,避免了上下文过载。扩展实验中,随语料增大,RARG 的效率优势更明显,表明相关性先验对大规模搜索更具价值。
基线对比解读
传统检索代理仅依赖文档级 Top-k,无法细粒度定位、合成或验证证据,在需要多步推理的复杂问题上容易失败。直接交互代理提供了灵活的 grep 探索,但无优先级导致大量无关匹配消耗 LLM 上下文,收敛缓慢。RARG 将相关性作为执行先验注入交互过程:它保留了 DCI 的灵活性,同时用相关性信号规划搜索路径,实现了更快、更可靠的收敛。这为 Agentic Search 提供了新范式——相关性不仅用于筛选结果,更应作为引导下一步动作的动态信号。工程上,这种 coarse-to-fine 的引导策略可平衡探索效率与准确性,在构建大规模企业级搜索代理时值得借鉴。
行业影响
落地场景
RARG 提出的 相关性感知 RipGrep 搜索代理,将传统检索的相关性信号直接注入到直接语料库交互(DCI)中,适用于需要 复杂证据定位、组合与验证 的长尾问答和推理密集型检索场景。典型产品形态包括:
- 企业知识库智能搜索:员工针对 SOP、技术文档、合同条款进行多步推理提问时,RARG 可通过有序的
ripgrep遍历快速定位关键段落,并重组验证答案。 - 电商售后与合规审核:从海量产品说明、法规文件中交叉比对特定要求,例如“某型号充电器是否符合最新安全标准的第 3.2 条与附录 B”,可利用粗到细的相关性引导减少无效扫描。
- 学术文献辅助分析:研究者想快速厘清“某基因通路在多种癌症中的表达交集”,RARG 先在全局文档级排序下介入
grep搜索,再通过匹配重排序优先暴露高信息量片段,加速证据收集。
商业价值
该工作直接在 准确率-效率前沿 上取得提升,意味着同等算力预算下可回答更多复杂问题,或在同等准确率下降低 API 调用次数和 token 消耗。对企业而言:
- 降本:减少了 LLM 无意义的
grep结果扫描和冗余交互轮次,每个问题平均所需操作步数下降,直接节省推理成本。 - 增收:在客服、合规审核等场景中,更快给出准确答案可提升服务吞吐量,支持更大规模的自动化决策。
- 体验提升:用户等待时间缩短,且答案更可靠,尤其在需要多源证据整合时,避免了因检索盲区导致的“无法回答”或错误回答。
与现有产品/工作流的接口
RARG 可作为 检索增强生成(RAG)系统中的一个插件式代理层 接入现有技术栈:
- 集成方式:在标准 RAG pipeline 的检索阶段之后,插入 RARG 工具调用模块。第一轮仍用常规检索器提供候选文档集和初始段落,然后代理进入
ripgrep交互时,由document_order和match_rerank参数控制探索顺序。 - 工具链兼容:基于
ripgrep的命令执行接口易于容器化,可部署在 Kubernetes 上,通过 Function Calling 暴露给 LLM 代理,与 LangChain、AutoGen 等框架无缝对接。 - 数据依赖:仅需配置一个文本语料库(如 Elasticsearch 索引)和对应的相关性分数字段,无需重新训练模型,适合现有企业搜索系统快速试点。
具体落地用例
- 医疗指南查询:临床决策支持系统需回答“根据 NCCN 指南 2025,对于 EGFR T790M 突变阳性 NSCLC 患者,奥希替尼耐药后有哪些二线方案?需同时满足脑转移活动性要求。”传统 RAG 可能只返回相关段落,但 RARG 可先用文档级排序优先搜索最新指南,再通过
grep定位“奥希替尼耐药”条目,最后对匹配行重排序,确保副作用和脑转移条款不被遗漏。 - 合同条款风险扫描:法律技术产品自动审查合同时,用户提问“找出所有含‘不可抗力’且未明确‘政府行为’免责的条款,按责任划分排序”。RARG 可先以文档相关性筛选主合同与附录,再按条款层级逐步
grep,并重排序上下文以确保 LLM 读到完整免责说明,大幅降低漏检风险。
局限
- **评估边界与鲁棒性**:RARG 仅在 **BrowseComp** 和 **BRIGHT** 两个基准上验证,语料限制于维基百科、网页等静态集合,对跨领域、跨语言或实时更新的动态语料的泛化能力未经验证。方法高度依赖 **相关性模型** 的排序质量,若初始文档排序出现系统性偏差,将直接传导至交互过程中的文档遍历顺序和入口点选择,可能导致搜索轨迹陷入次优区域,延迟收敛。
- **交互范式与语义瓶颈**:RARG 的深层交互仍依赖 `ripgrep` 的字符串匹配,在需要多跳推理、隐含语义关联或跨片段组合的场景中,关键词匹配可能无法捕捉逻辑线索,部分复杂查询仍需大量迭代。**入口点初始化** 和 **匹配重排序** 增加了额外的推理和排序开销,虽然提升了搜索初期的信噪比,但对大规模并发请求的实时系统,其计算成本与效率优势之间的平衡需要更精细的消融验证。
- **对比与评估完整性**:论文主要对比了纯检索代理和基础的 **直接语料交互(DCI)** 代理,但缺少与近期融合稠密检索与代码执行的高级搜索代理的对照。评估中未分析 **相关性引导策略对不同查询类型**(如事实核查、长篇综述生成)的适用边界,也未测量用户交互成本或最大迭代次数的敏感性,无法全面判断该方法在实际产品中的部署适配性。