FilmBench: 电影级视频生成的影片级基准
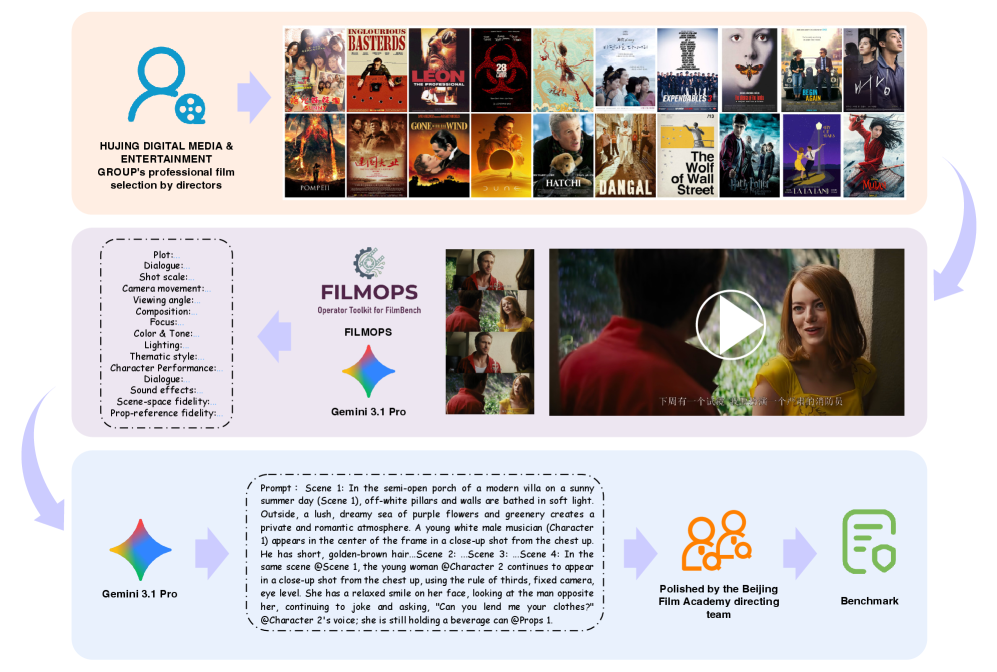
现有视频生成基准大多从网络来源或大语言模型模板获取提示,并用未经过专业训练的通用多模态模型评分,其评估分类停留在整体视觉质量、粗略文本对齐和时间平滑度等基础层面,而非专业电影语言标准。本文提出 FilmBench,一个基于电影学院传统专业电影语言的文生视频 (T2V) 和参考生视频 (R2V) 基准,与北京电影学院和湖景数字传媒集团电影工作室的导演及教师联合开发。 基准基于三个设计: 1. 提示从20种电影类型的获奖影片中逆向工程,由专业导演选择,每个提示对应真实镜头列表,且多数为多镜头(1169个提示中1056个为多镜头),区别于以往的单片段基准。 2. 评估采用三级电影分类体系:3个轴、12个组件和35个(T2V)+3个(R2V-only)子指标。 3. 开发了内部专家级自动评估代理,并开源其核心电影语言算子套件 FilmOps。 对领先视频生成模型(9个T2V,7个R2V)的基准测试表明,评估器在模型级别复现了人类排名,Spearman rho 达到0.95(T2V)和0.96(R2V)。得分远低于以往网络级基准,存在动态美感的一致性差距,且单镜头到多镜头的性能下降显著,弱模型下降幅度更大。
论文精读
TL;DR FilmBench 以电影学院专业电影语言为评价体系,从获奖影片反推多镜头提示,构建T2V/R2V基准,解决现有视频生成评测缺失电影级工艺标准的问题,其自研评估代理FilmOps与人类排名高度一致(Spearman 0.95+)。
问题
视频生成模型正迅速缩小 AI 生成内容与专业影视作品的视觉差距,但评估基准的发展明显滞后。当前领域关注的核心问题已从 “能否生成合理视频” 转向 “能否生成具备电影级工艺水准的视频”。
现有方法的局限在于:多数基准的 提示词 (prompt) 来源于网络爬取或大语言模型模板,缺乏电影创作中 分镜脚本 (shot list) 的真实结构与专业意图;评估指标 停留在基础视觉质量、粗粒度图文对齐和时序平滑性,完全忽略了 电影语言 (Cinematic Language) 所定义的构图、运镜、光线连续性、多镜头叙事等要素。此外,评分模型常使用未在电影数据上专门训练的通用多模态模型,导致自动评估结果与专业导演的人类判断相去甚远,仅能衡量视频的“物理合理性”而非“艺术表现力”。
该问题的难度与重要性体现在:电影级视频不仅要求单镜头的真实感,更需遵循 动态美学 (dynamic aesthetics) 和 多镜头连贯 (multi-shot coherence) 等深层创作规律,这些规律通常以隐式知识存在于行业内,难以被简单量化。随着 AI 视频生成逐步向专业影视创作渗透,业界急需一套能与人类专家对齐的自动化评估体系来指导模型迭代,否则模型将长期停滞在“短视频炫技”而无法进入实际生产管线。
一个可类比的场景是 自动驾驶仿真测试:如果测试场景仅由模板生成且评估指标限于碰撞避免,则无法验证车辆在真实交通复杂性与人类驾驶习惯下的表现;同样,缺乏电影语言级基准的视频生成模型,也难以实现从“demo”到“成片”的跨越。
核心洞察
- FilmBench首次将电影学院的专业电影语言体系系统性地转化为生成式视频的评估标准,弥补了此前基准仅关注视觉质量、文本对齐和时序平滑等基础指标的缺陷。通过三级评价轴(3轴12组件35+子指标),它将评估提升到了导演、制片人判断影片的水准,使模型不仅追求画面‘真实’,更需具备电影级的构图、运镜和叙事节奏。
- 提示词构建采用逆向工程从获奖实拍片段中提取,区别于随手写的LLM模板,确保了每个提示对应真实制作参考,并天然包含多镜头指令。这暴露了当前模型从单镜头到多镜头生成的显著性能下降,且弱模型下降更剧烈,为行业指明了多镜头一致性和叙事能力是下一代视频生成模型必须突破的关键瓶颈。
- 开源的FilmOps算子套件达到了与人类评审高度一致(Spearman ρ=0.95/0.96),证明了自动化专业影评的可行性。它通过多体裁训练和任务匹配算子设计,让模型评分不再依赖通用的多模态模型,而是拥有了‘电影审美’的领域知识,为大规模筛选、迭代视频模型提供了可复用的工程化方案。
方法
输入
FilmBench 从获奖电影片段出发,由专业导演筛选涵盖 20 种电影类型的片段,逆向工程生成文本提示。每个提示均锚定于真实拍摄的参考视频,且绝大多数是多镜头脚本(1,169 个提示中 1,056 个为多镜头),与以往单片段基准形成鲜明对比。对 T2V 和 R2V 任务分别提供提示与参考图像/视频。
关键模块
- 基准构建:
- 提示均来自电影制作中实际使用的分镜表风格,确保语言与电影生产对齐。
- 评估分类法遵循电影学院传统,设计为三级体系:
- L1 轴:3 个主轴(视觉表现、叙事连贯性、电影风格)。
- L2 组件:12 个,如构图、色彩、运动连续性等。
- L3 子指标:35 个(T2V)加 3 个(R2V 独有),覆盖灯光、剪辑节奏、表演等细节。
- 自动评估代理:
- 开发 FilmOps(电影语言操作符套件),包括:
- 行业对齐分类法:直接映射电影专业人员评审标准。
- 多类型训练数据:由电影学院师生标注,确保与人类判断一致。
- 任务匹配操作符:针对 T2V 和 R2V 设计不同的评估流程与指标组合。
- 评分聚合采用加权平均,保留维度级解释性。
- 开发 FilmOps(电影语言操作符套件),包括:
输出
- 模型在层级化雷达图上的详细得分,揭示模型在电影语言各维度的长短板(如动态美学、多镜头一致性)。
- 排行榜与细粒度热力图,支持 T2V 和 R2V 模型的直接比较。
与同类方法差异
相比仅依赖通用视觉质量&时间平滑度的现有基准,FilmBench 首次将电影制作语言系统性地转化为可自动计算的评估分类法,并且所有提示均源自真实电影制作流程,多镜头设定更贴近专业影视内容生产,而非源自网络或模板的简单零散描述。
实验
实验设计
FilmBench 对 9 个 T2V 和 7 个 R2V 模型进行评测,涵盖 1169 条由获奖电影逆推的专业提示(其中 1056 条为多镜头)。评测采用独创的三级电影语言分类体系,包含 3 个主轴、12 个组件和 35(T2V)+3(R2V 专属)项子指标。通过自研的FilmOps 自动评估代理计算得分,并以电影学院专家的人类评分作为对比,验证其可靠性。
关键发现
FilmOps 评估器在模型级别的 Spearman 相关系数达到 0.95(T2V)和 0.96(R2V),几乎完美复现人类专家排名。模型在 FilmBench 上的得分显著低于传统 Web 风格基准,暴露出两大系统性短板:动态美学差距(如运动自然度、镜头构图)和从单镜头到多镜头的性能骤降,弱模型在多镜头连贯性上退化尤为明显。
与基线对比的深度解读
现有主流基准(如 VBench、EvalCrafter)多依赖网络文本提示和通用 LLM 评估,仅关注基本视觉质量和时序平滑,无法衡量电影级专业技艺。FilmBench 开创性地引入**电影语言(Cinematic Language)**作为评价框架,将评判标准从“视频是否合理”提升到“是否符合专业电影制作规范”。这使得常规模型原本看似不错的成绩被打回原形,揭示出 AI 视频生成在艺术表现力与叙事连贯性上与专业制作的深层鸿沟。
行业影响
落地场景
FilmBench 的评估体系直接服务于需要高质量视频生成的行业:
- 影视与广告:剧本可视化、视效预览和品牌广告快速生成,帮助制作团队快速验证镜头构思,降低前期试错成本。
- 内容平台:赋能创作者生产具备电影级审美的短视频,提升内容生态的视觉吸引力与用户留存。
- 虚拟制作与游戏:用于预渲染过场动画、虚拟背景生成及实时引擎素材评估。
商业价值
- 降本:用 FilmOps 自动评估替代部分人工评审,压缩专业视频制作的审核周期和前期拍摄预算。
- 增收:将电影级生成能力产品化,面向影视、广告客户提供高溢价 API 或 SaaS 服务。
- 体验提升:UGC 内容质量飞跃,增强平台差异化竞争力,直接带动用户活跃与变现效率。
与现有工作流的接口
- 模型开发管线:作为评估插件嵌入视频生成模型的训练或调优循环,利用 Cinematic Language 多级指标实时监控模型在动态美学、多镜头连贯性等维度的表现,指导针对性优化。
- 内容质检:集成到后期制作工具链,依据 FilmBench 的行业对齐标准自动标记不符合电影级要求的片段,辅助精剪决策。
- 开放生态:通过开源 FilmOps 算子,与现有评测框架(如 VBench)兼容,可灵活替换或补充度量层级。
具体落地用例
- 电商平台:根据商品描述自动生成电影级展示视频,借助 FilmBench 的镜头构图、光照一致性指标确保输出符合专业审美,直接用于信息流广告投放,提升点击与转化。
- 在线教育:生成历史场景重现等沉浸式教学资源,利用 R2V 参考生成以经典影视风格控制画面,通过 FilmOps 的“Cinematic Language”自动打分,保证视觉吸引力与教学准确度。
局限
- **提示分布偏向专业电影制作**,FilmBench 的提示均从获奖电影的获奖片段中反向工程得到,并严格遵循真实的分镜头脚本,多数为多镜头长提示。这使得评估场景高度集中于专业电影级语言与美学,可能导致基准对通用视频生成(如短视频、UGC、广告等)的代表性不足。现有生成模型在此基准上得分普遍偏低,虽然揭示了差距,但过于严苛的命题可能对非电影风格生成的模型造成不公平评价,且低分范围的区分度可能受限,难以细致刻画不同模型在常见应用中的能力差异。
- **FilmOps 评估代理的泛化性与开放性有待验证**。尽管 FilmOps 在模型层级与人类专家排名实现了 Spearman 0.95/0.96 的高度一致,但其训练数据与评估分类体系主要依托北京电影学院及合作工作室的专业审美范式,可能对非学院派、跨文化或实验性电影风格的评估产生偏差。另外,论文开源了核心的 Cinematic Language 算子套件,但完整评估代理的开放性尚不明确,若关键组件(如训练数据、权重、完整流程)未充分开放,将影响社区的复现与深度定制,进而阻碍基准的广泛采纳与持续演进。