WorldDiT: 一种统一的世界与动作建模扩散架构
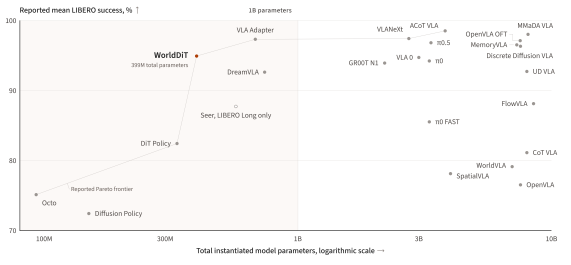
许多最近的机器人策略通过使用大型预训练视觉语言模型(VLM)作为动作骨干来追求更强的控制。 我们提出了 WorldDiT ,一种统一的扩散变换器架构,它将动作生成与视觉世界建模相结合,并在没有大型预训练VLM动作骨干的情况下实现了强性能。在训练期间,单个扩散变换器生成连续的动作块,并预测未来相机帧的归一化RGB补丁目标。 在四个 LIBERO 模拟套件中,WorldDiT位于报告的总模型参数和平均成功率 Pareto前沿 上,这些结果针对报告所有四个套件的方法。这为未来的缩放研究提供了一个强大的 十亿参数以下 的基线。
论文精读
TL;DR WorldDiT 以单一扩散 Transformer 同时建模动作与未来视觉,摆脱对巨型 VLM 的依赖,在参数效率前沿上树立强基线。
问题
问题背景
机器人视觉运动控制领域当前的核心关注点,在于如何利用大规模预训练模型提升策略的行为能力,同时保持系统的实时性与可解释性。
现有方法局限
多数前沿工作采用大型预训练视觉 - 语言模型 (VLM) 作为动作骨干,例如将 RT-2、Octo 等数十亿参数模型直接 fine-tune 到机器人任务上。这种方式存在明显局限:
- 贡献难以解耦:强控制表现可能来自庞大的预训练知识,而非专门针对具身交互设计的架构,导致后续研究无法清晰归因于规模、预训练数据还是模型设计本身。
- 计算与部署成本高:数十亿参数级别的模型推理延迟显著,难以满足高频闭环控制的实时性要求,且终端部署时的资源消耗阻碍了从仿真到真实机器人的迁移。
- 缺乏世界动态建模:多数 VLM 骨干仅将动作作为文本或离散 token 输出,忽略了与物理世界交互所必需的视觉预测能力,无法利用未来帧的监督信号来强化动作与观察之间的因果推理。
为什么这个问题难且重要
实现动作生成与视觉世界建模的统一,需要同时处理连续控制信号和高维图像预测,二者在优化目标与梯度尺度上差异巨大,极易造成任务干扰。此外,在 LIBERO 等跨任务、跨场景的基准测试中,维持所有套件的平均成功率并触及参数量的帕累托前沿,意味着需要一种极其紧凑且高效的架构——这对工业界追求降本增效的机器人学习系统极具吸引力。WorldDiT 通过共享扩散主干并加入辅助归一化 RGB patch 预测,在小参数量下(sub-billion)即可与大量采用 VLM 的方法打平或超越,为后续 scaling law 研究提供了干净的基线,也证明了 视觉世界的自监督信号可能是替代大模型预训练的一条路径。
行业类比
这类似于自然语言处理中,用 TinyBERT 等蒸馏模型替代大规模语言模型——不是为了用更少参数模拟大模型的全部能力,而是用针对性架构和辅助任务,在特定垂直场景中达成同等或更优的表现。
核心洞察
- WorldDiT 通过单一扩散模型同时对动作和未来视觉进行建模,从而将世界建模与连续控制统一在共享骨干中。多数机器人策略为追求强控制力,将动作头附接于大型预训练 VLM 之上,这使得架构贡献与预训练知识难以解耦。WorldDiT 的设计让性能提升的来源更加明晰,避免了因庞大骨干而掩盖算法改进效果,为研究参数效率和控制能力的关系提供了干净的基线。
- WorldDiT 在训练时预测未来 RGB patch 作为辅助任务,但推理时完全丢弃该目标仅生成动作。这种做法将视觉预测定位为一种高效的训练监督信号,以提升动作学习的表征质量,而不增加推理计算开销。相比之下,许多方法在推理时仍需保持世界模型或视觉重建模块,WorldDiT 在不增加部署负担的前提下获得了与更大模型竞争的性能,凸显了辅助视觉预测在动作学习中的独特价值。
方法
输入与编码
- 视觉编码器 和 语言编码器(冻结)分别处理多视角图像与任务指令,提取特征。
- 可训练的 机器人状态编码器 映射本体感受信号(如关节位置、末端位姿)为嵌入向量。
- 上述条件拼接后与噪声时间步一起输入 共享 DiT 骨干,作为扩散过程的条件。
统一扩散建模
- 骨干执行连续时间流匹配(flow matching),同时预测两个目标:
- 7 步动作 chunk,描述未来若干控制周期的连续动作序列。
- 归一化 RGB patch 目标,从未来主相机和腕部相机帧中随机采样的小块像素值,经归一化后作为辅助监督。
- 训练损失联合优化动作重建误差与 RGB patch 预测误差,无需额外的预训练 VLM 作为动作头。
- 视觉预测分支仅在训练时存在,为模型注入对未来视觉状态的建模能力,从而间接增强动作生成的时序一致性。
推理与执行
- 推理时,视觉预测分支完全移除,仅保留动作生成通路,不增加实际部署的计算开销。
- 从随机噪声出发采样完整动作 chunk,执行前 3 个动作,观察新状态后重新规划(滚动时域控制)。
与同类方法的差异:主流方法常将动作预测作为大型预训练 VLM 的附加输出头,模型参数量大且行为与预训练版本强耦合。WorldDiT 将动作生成与未来视觉建模统一在同一个扩散 Transformer 中,利用辅助视觉目标提供丰富监督,使得在亚十亿参数规模下即达到前沿成功率,为后续 scaling 研究提供了清晰的基线。
实验
实验设计
在四个 LIBERO 仿真套件上评估 WorldDiT,遵循统一协议。模型以 冻结的视觉与语言编码器(含机器人状态编码器)作为条件,共享 DiT 主干在训练时同时学习 7 步动作块 的连续流生成与 未来归一化 RGB patch 预测(来自主摄像头与腕部摄像头)。推理时仅生成动作块,执行前 3 步后重规划。比较覆盖 24 种方法,聚焦 模型总参数 与 平均成功率 两个维度。
关键发现
WorldDiT 在不使用大规模预训练 VLM 作为动作主干的前提下,跻身已报告方法的 Pareto 前沿(参数–成功率),证明统一架构能将视觉世界建模与动作生成有效耦合。其参数量低于 10 亿,为未来缩放研究提供了 强基线。辅助视觉预测仅存在于训练阶段,推理无额外开销,模型轻量且高效。
与基线的对比解读
相较于依赖数十亿参数预训练 VLM 的策略(如 RT-2、Octo 等),WorldDiT 展现了架构本身的能力:纯扩散 Transformer 搭配辅助未来预测 就足以达到相近的性能,同时避免庞大 backbone 带来的计算与部署负担。这一对比突显了在机器人控制中,显式引入世界模型(即使是通过 patch 预测这种简单形式)对策略学习效率的重要性,也为未来分离 scale 与 architecture 影响的实验提供了更清晰的起点。
行业影响
落地场景
WorldDiT 将动作生成与视觉世界建模统一到单个扩散 Transformer 中,可直接服务于需要视觉引导的机器人操作场景,如仓储拣选、物流分拣、物品整理和家庭服务机器人。模型无需依赖大型预训练 VLM,降低了对网络带宽和云端推理的依赖,更适合边缘部署和实时控制。同时,其辅助的未来帧 RGB patch 预测可在训练时提供额外监督,提升对动态环境的理解,适用于操作精度要求高的任务。
商业价值
- 降本:参数量控制在 sub-billion 级别,显著降低训练和推理所需的 GPU 资源,使中小型企业也能负担高成功率的机器人策略训练。去除了对亿级参数 VLM 的依赖,硬件成本和云服务费用大幅减少。
- 增收与体验提升:更高的任务成功率(在 LIBERO 四个套件中达到帕累托前沿)直接带来自动化产线产能提升、故障率下降;家庭场景中,更可靠的机器助手可提升用户信任度和使用频率。
- 技术壁垒降低:为动作预测提供了不依赖闭源大模型的高性能基线,有利于构建自有知识产权且可垂直优化的自动化方案。
与现有产品 / 工作流的集成
WorldDiT 可作为动作生成模块嵌入现有机器人软件栈,替换基于 VLM 的策略模块或传统规划器:
- 输入接口:从多相机系统(如主相机和腕部相机)获取 RGB 图像、语言指令和机器人本体状态。
- 推理流程:在接收到图像和指令后,直接输出未来数步的动作序列(如 7 步动作 chunk),控制器仅需执行前几步并 replan。
- 部署兼容性:可与 ROS 2 节点或硬件加速引擎(如 TensorRT)集成,实现低延迟实时控制;其扩散 Transformer 架构天然适合小批量推理优化。
具体落地 use case
- 仓储拣选系统:电商物流中心的 AMR 拣选机器人 通常依赖昂贵的 3D 视觉和专用模型。WorldDiT 可由 RGB 相机和简单的语言指令(如“拿起红色盒子并放入蓝色筐”)驱动,降低硬件成本的同时保持高抓取成功率。辅助的未来帧预测还可用于异常检测,提前规避碰撞。
- 商用厨房自动化:在处理易碎餐具或食材时,机器人需要精细操作。WorldDiT 通过预测未来视觉状态的 patch 级目标,有助于模型理解抓取力度和接触后的物体变化,避免失误。部署时仅需推理动作生成模块,无需运行图像预测,推理开销小,适合一体化厨电边缘芯片。
局限
- **模拟-现实差距未验证**:所有实验均在 LIBERO 四个仿真套件上进行,未在真实机器人平台上评估。尽管 LIBERO 涵盖多种桌面操作任务,但仿真中的视觉纹理、物理参数和随机性仍与真实环境存在系统性差异。论文未提供 sim-to-real 迁移实验或域随机化细节,因此 WorldDiT 在真实场景下的成功率波动、安全性和闭环稳定性仍未知。对于实际工程部署而言,缺乏真实世界基准测试构成首要风险。
- **辅助 RGB 补丁预测的消融与鲁棒性不足**:训练时通过归一化 RGB 补丁目标融入未来视觉预测,但论文未单独消融该辅助任务对动作质量的贡献。从设计看,该损失的权重、补丁采样策略和归一化方式可能对光照或相机视角变化敏感。若辅助目标与主任务存在干扰,可能导致下游任务性能退化。在与其他仅动作预测的扩散策略对比时,难以判断增益是来自统一框架还是额外视觉监督。
- **扩展行为与推理成本待阐明**:WorldDiT 定位为“亚十亿参数基线”,但论文未探讨参数规模、扩散步数与成功率的 scaling law。推理时仍需多次扩散采样生成动作块,对实时控制(如高频闭环重规划)引入延迟。若未来要扩展至十亿参数以上,计算负担和内存占用可能快速上升,与当前追求低延迟、低功耗机器人系统的趋势相悖,且缺少与轻量级非扩散策略(如精简 CNN/RNN 策略)的效率对比。