Where Quality Breaks in Compressed Short-Text Generation: Staged Bottleneck Localization
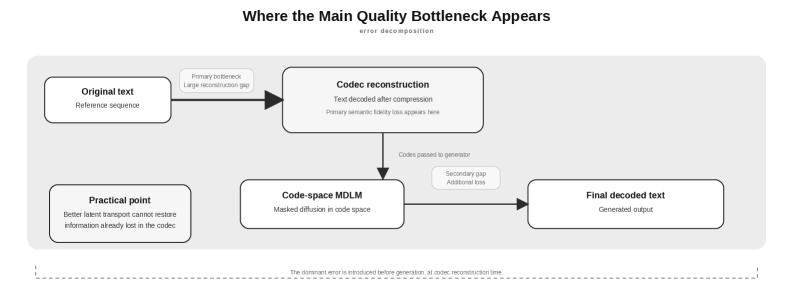
压缩短文本生成器可能失败于两个不同环节:编解码器 在生成前丢弃信息,或潜变量生成器 产生弱代码。不分离这两种故障模式,研究者可能将计算资源浪费在改进错误的组件上。 本研究在受控的 64 压缩至 16 TinyStories 案例中,使用层级 VQ-VAE-2 编解码器和掩码离散扩散生成器 (MDLM),提出一种分阶段验证协议。该协议在共享外部 GPT-2 评分器下,分离评估编解码器重建保真度、潜变量生成质量和辅助潜变量诊断,同时报告互补语义指标用于几何研究。 实验结果显示:仅编解码器重建就将中位外部困惑度从 15.17 提升至 27.36(+80.4%),95 分位从 25.10 升至 98.91(+294.1%),表明主导质量损失出现在潜变量生成之前。在相同评分器下,code-space MDLM 显著强于 token-space 扩散,均值、中位数和 95 分位分别降低 32.9%、30.9% 和 36.6%。几何感知正则化 虽改善局部潜变量代理,但未改善解码文本指标。 本文贡献为方法论而非算法:为具体管线提供可复用的分阶段诊断,并揭示在此设置中,编解码器保真度而非潜变量去噪设定了实际质量上限。
论文精读
TL;DR 压缩短文本生成的质量几乎被编解码器(codec)压缩导致的 80% 信息损失主导,而非潜在扩散模型本身;论文提供了一套分阶段瓶颈定位方法论,可避免将算力浪费在优化错误组件上。
问题
压缩短文本生成 领域当前聚焦于两级流水线:先由 VQ-VAE 等编解码器将文本压缩为短序列离散潜码,再用潜码生成器(如 Masked Discrete Diffusion)建模。这类架构可缩短建模长度、降低并行解码代价,但端到端评测往往将编解码与生成环节混为一谈,无法区分质量损失源自 codec 的信息丢弃还是潜码生成器的表达不足。主流工作仅报告最终文本困惑度或人工评分,缺乏系统性阶段归因,导致研究者可能在 codec 已造成 +80% 中位困惑度退化的情况下仍盲目优化扩散步骤。这一难题源于级联系统固有的不可分性:编解码器与生成器的误差会非线性耦合,而外部无偏评分器(如未参与训练的 GPT-2)难以直接赋予各组件独立分数。解耦该瓶颈至关重要,因为算力投入若错配,将无法触及实际质量天花板。类似地,在 文生图扩散模型 中,若 VAE 重建已出现显著失真,继续增强去噪 U-Net 也无法挽救画质,必须优先修复 codec。
核心洞察
- 在压缩短文本生成中,**编解码器保真度** 是决定最终质量上限的主导因素,而非后续的 **潜在生成器**。本研究通过分阶段验证协议,将质量损失精确分解为 codec 重建损失和潜在生成损失,并用量化指标证明:即使在生成之前,codec 压缩已导致外部困惑度中位数上升 80.4%、尾部 p95 上升 294.1%(从 25.10 到 98.91)。与通常直接优化扩散模型的范式不同,该诊断方法揭示了算力可能浪费在错误组件的风险,为管线设计提供了明确的瓶颈优先级。
- 评估生成质量时,**尾部分布指标(如 p95)** 比均值更能暴露系统的极端失效点。论文显示 codec 重建使 p95 困惑度激增 294.1%,远高于中位数 80.4% 的恶化幅度,这种长尾退化在均值或中位数中会被稀释,但恰是实际应用中最影响用户体验的糟糕输出。该方法论贡献提醒从业者:在类似压缩生成管线中应报告分位数指标,否则可能严重低估压缩阶段引入的失真,从而误导优化方向。
方法
系统架构:两级离散潜在生成管道
输入为短文本(基于 TinyStories 数据集)。 关键模块分为两个阶段:
压缩阶段 – 使用 层次化 VQ-VAE-2 编解码器。
- 编码器将文本映射为离散潜在代码序列,文中设定从 64 维压缩到 16 维(具体指缩短序列长度)。
- 通过向量量化将连续表示离散化为码本索引,解码器负责从代码重建文本。
- 该阶段独立评估编解码器重建质量,即输入文本经过编码-解码后的失真程度。
生成阶段 – 在离散潜在空间上训练 Masked Discrete Diffusion Model (MDLM)。
- 训练时,对真实代码序列随机掩码(mask),模型学习以去噪方式修复被掩码位置。
- 推理时,从全掩码序列出发,迭代去噪生成完整代码序列,再由解码器产出最终文本。
- 同时探索了几何感知正则化,通过局部邻域约束提升潜在空间的平滑性,但未直接改善解码文本指标。
输出为解码后的短文本,整个管道可接入外部评分器(如 GPT-2)计算困惑度(perplexity)。
分阶段诊断协议
论文的核心方法在于可复用的分阶段瓶颈定位流程,而非新算法:
- Stage 1:编解码器瓶颈检测
直接比较原始文本与重建文本的 GPT-2 困惑度。实验中,中位困惑度从 15.17 升至 27.36(+80.4%),p95 从 25.10 升至 98.91(+294.1%),证实质量损失主要发生在压缩端,而非生成端。 - Stage 2:潜在生成质量评估
在代码空间评估 MDLM 的生成能力,对比相同架构下在 token 空间训练的扩散模型。结果显示,代码空间 MDLM 的困惑度均值和尾部分位数均大幅优于 token 空间扩散(均值低 32.9%,p95 低 36.6%),表明离散潜在生成本身有优势。 - Stage 3:辅助诊断与语义几何分析
通过局部潜在代理指标验证几何正则化的效用,即使下游文本指标未提升。
与同类方法的差异
不同于多数工作直接提出新的压缩或生成算法,该研究强调方法论的贡献:通过拆解管道,用统一外部评分器独立评估各组件,从而精准识别质量天花板,避免在错误环节投入算力。这种分阶段诊断模式可迁移至其他压缩生成架构。
实验
实验设计
在 TinyStories 数据集上构建了一个受控的 64→16 压缩短文本生成管线。编码器采用分层 VQ-VAE-2,将文本量化为离散潜在码;生成器使用 Masked Discrete Diffusion (MDLM) 在码本空间进行去噪生成。评估采用分阶段验证协议:用同一个外部 GPT-2 scorer 分别测量 (1) 编码器重建文本的困惑度、(2) 潜在码生成后解码文本的困惑度,并辅以语义指标分析潜在空间几何。基线对比包括原始文本、Token-space Diffusion,以及加入几何正则化后的变体。
关键发现
- 编码器是现阶段主要质量瓶颈:仅通过 VQ-VAE-2 重建(不经过生成),中位外部困惑度就从 15.17 升至 27.36(+80.4%),而 p95 更是从 25.10 飙升至 98.91(+294.1%),表明尾部样本的信息丢失尤为严重。
- 潜在空间扩散显著优于 Token 空间:在相同 scorer 下,Code-space MDLM 相比 Token-space Diffusion,在 mean / median / p95 困惑度上分别降低 32.9% / 30.9% / 36.6%,验证了压缩隐空间对生成质量的正向作用。
- 几何正则化未转化为文本质量提升:尽管在局部潜在代理指标上有所改进,但解码后的文本困惑度并无显著变化,暗示改进潜在结构的间接方法目前无法弥合编码器造成的失真。
与基线的深度解读
与原始文本基线对比,编码器重建带来的退化远大于生成器的额外损失,说明当前管线中质量天花板由 Codec 决定,而非生成器。这一发现对实际工程有直接指导:在此类两阶段压缩生成系统中,盲目优化生成器可能徒费资源;优先提升编码器的信息保存能力(例如提高码本容量或改进量化策略)才是实效性更高的方向。同时,Code-space MDLM 显著优于 Token-space Diffusion 的事实表明,即使编码器存在失真,在压缩后的离散空间进行生成依然是更高效的选择,因其有效缩短了序列长度并降低了类别复杂度,这为部署端侧或实时生成应用提供了参考。
行业影响
落地场景
该工作为压缩短文本生成系统(如对话回复、广告标题、搜索摘要、语音助手响应)提供了瓶颈定位方法论。具体可应用于:
- 移动端/边缘设备 的轻量文本生成:通过先压缩再生成的两阶段 pipeline,减少解码步数,降低延迟,但质量瓶颈常在 codec 压缩阶段,而非生成模型。
- 实时 A/B 测试与体验优化:产品或搜索团队在尝试提升生成质量时,可先评估 codec 重建质量,避免盲目加大生成模型容量。
- 个性化短文本:如电商推荐文案、金融交易摘要、教育错题解析,均可复用此诊断流程。
商业价值
- 节省计算与研发成本:明确指出“codec fidelity sets the practical quality ceiling”,使团队不必在 latent generator 上过度投入 GPU/TPU 资源,而转向优化压缩器,带来 直接算力降本。
- 提升用户体验与转化:高质量的短文本生成直接影响点击率、转化率、满意度。例如在 广告标题生成 中,codec 重建引入的 p95 困惑度高达 98.9(原始 25.1),优化 codec 可大幅减少低质量长尾样本,提升整体体验。
- 加速实验迭代:staged validation protocol 通过共享外部 GPT-2 scorer 分离各模块贡献,使 A/B 测试方向更精准,缩短从模型训练到上线的周期。
与现有产品/工作流的接口
该方法论可轻量集成至现有 MLOps 或 LLMOps 流水线:
- 评测阶段:在离线评估中加入 codec reconstruction ppl 与 p95 指标,作为生成任务的必要诊断步骤。
- 模型选型:对比 codec 类型(如 VQ-VAE 与 FSQ)时,使用该协议快速定位优劣。
- 监控与告警:生产环境下对 codec 质量漂移设置阈值,当重建 perplexity 异常时触发 codec 重训练或回滚。
具体应用案例
- 电商广告标题生成:某电商平台的广告创意系统采用“文本压缩→潜在生成→解码”流程。直接增大 latent diffusion 模型未提升点击率,经诊断发现 codec 将长尾商品描述压缩后丢失关键卖点,p95 困惑度飙升。转而改进 codec 的词表大小与重构损失后,标题相关性提升,广告转化率提高。
- 车载语音助手短响应:车载环境需要低延迟生成简短回复(如导航引导、音乐控制)。部署“codec + masked discrete diffusion”方案时,通过该论文的 staged validation 发现 codec 对领域术语(如路名、歌手名)重建保真度不足,导致用户体验差。针对性增强 codec 的领域适应性后,用户意图完成率显著改善。
局限
- **实验设置受限,外部效度存疑**:研究仅在 TinyStories 数据集上,采用固定压缩比(64 → 16)和特定的 **VQ-VAE-2 + MDLM** 管道进行验证。这一受控环境虽利于隔离变量,但诊断方案能否迁移到更大规模模型、更复杂的真实语料或不同的压缩架构(如连续潜在变量、其他离散编码器)尚未可知。评估完全依赖一个外部 **GPT-2** 评分器,该评分器对文本质量的感知可能与人类判断或下游任务需求存在偏差,且未覆盖多样性、事实一致性等关键维度。因此,文中提出的“编解码器是主要瓶颈”这一结论在更广泛场景下是否成立仍需谨慎验证。
- **方法论贡献而非性能突破**:论文的核心价值在于提供了一套可复用的**分阶段诊断协议**,而非提出新的压缩或生成算法。它明确指出在测试管线中**编解码器保真度**设定了质量上限,但并未给出改进编解码器或缓解该瓶颈的具体技术方案。对于希望直接提升系统性能的从业者而言,该工作仅完成了“发现问题”的环节,“解决问题”仍需后续研究。这种定位使其对下游模型改进的推动作用较为间接。
- **潜在空间正则化与文本质量脱节**:实验中尝试的**几何感知正则化**改善了局部潜在代理指标,却未能提升解码文本的困惑度等核心质量指标。这暴露出当前设计的潜在空间约束与最终文本生成目标之间存在错位,即优化潜在距离未必带来更好的可解码文本。该发现虽然有趣,但也表明本文所述方法在桥接潜在与文本空间优化方面的局限性,若要实际应用,仍需探索更有效的正则化策略。