N0-TWAM: 面向接触丰富操控的可扩展触觉原生世界-动作模型
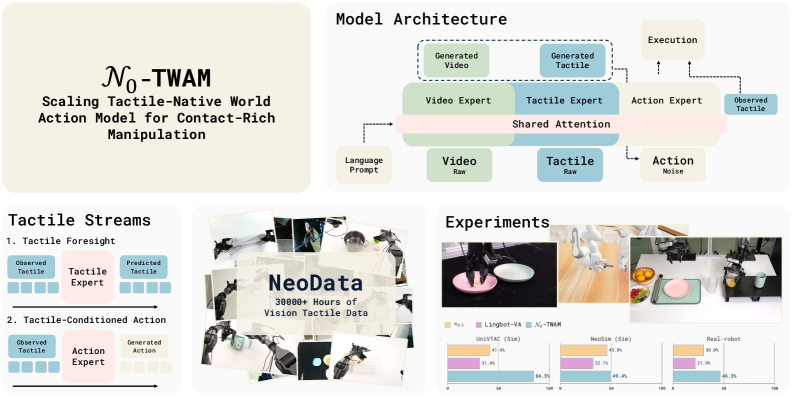
本文提出 N0-TWAM,一个用于接触丰富操控的触觉原生世界-动作模型,能够同时预测未来的视觉与未来的接触信号。据我们所知,这是首个大规模训练的触觉世界-动作模型,在接触丰富任务上展现出强大能力。 我们利用视觉-触觉联合训练,在覆盖 6 种具身、450 个任务的触觉丰富演示数据上对 N0-TWAM 进行大规模预训练。采用NeoForce 统一力觉触觉表示,形成物理上有依据的接触信号,用于约束动作生成。为改进长时程、多阶段操控,我们引入触觉接触事件进行任务阶段划分,并在执行过程中逐步推进这些事件。 为满足实时性要求,我们采用非对称混合 Transformer 架构:一个全宽度专家负责视频预测,搭配瘦身专家负责下游动作与触觉预测。在真实与仿真基准上的评估验证了 N0-TWAM 在多种接触丰富任务上的能力,并展示了数据规模扩展对精准触觉与动作预测的益处。 总之,N0-TWAM 赋予世界-动作模型预见视觉、触觉与动作的预测能力,为开放的接触丰富任务上的细粒度操控奠定坚实基础。代码库与模型检查点将公开,以促进触觉机器人操控的进一步研究与开发。
论文精读
TL;DR N_0-TWAM 是首个大规模训练的触觉原生世界-动作模型,联合预测未来视觉与接触力,并以触觉事件驱动长程任务分段,显著提升了接触密集操作的精度与可扩展性。
问题
接触丰富操控 (contact-rich manipulation) 是机器人从简单抓取迈向灵巧操作的关键一步,业界正寻求将 世界模型 与多模态感知结合,让机器人具备预判接触状态并实时调整动作的能力。
现有方法存在明显局限:主流的 视觉-语言-动作模型 (VLA,如 RT-2、Octo) 依赖视觉和语言,完全缺失触觉模态,导致在插拔、拧紧等任务中动作精度不足;少数工作虽引入触觉,但往往将触觉编码作为独立感知模块,未与动作预测 端到端联合优化,且缺乏 大规模多具身预训练,跨平台泛化能力弱。触觉信号通常使用高维图像(如 GelSight 印记)表示,信息冗余、物理可解释性差,无法作为动作生成的有效条件。此外,长时间、多阶段任务缺乏基于触觉反馈的 阶段分割与推进机制,容易累积误差并导致失败。
该问题的技术挑战在于:触觉传感器形态多样,数据分布差异大,难以形成统一的物理表征;触觉数据采集和标注成本极高,大规模数据集稀缺;实时操控要求毫秒级推理,而同时预测未来视频、触觉与动作对模型架构效率提出严苛要求。然而,触觉是灵巧操作不可或缺的“最后一厘米”信息,直接决定任务成败。业界高度关注如何将这层物理信号融入具身智能,实现从“看得见”到“摸得准”的跨越。
这类似于 多模态大模型 通过视觉-文本对齐解锁通用理解能力一样,为机器人构建一套可预测视觉、触觉与动作的 统一世界模型,有望在精密制造、服务交互等场景中显著提升操作可靠性与自适应能力。
核心洞察
- 大规模触觉原生预训练与统一力表示:N_0-TWAM 首次在数百任务、多具身的大规模录演数据上联合预训练视觉与触觉世界模型,并利用 NeoForce 将原始触觉输入转换为物理一致的力嵌入。这不同于之前多数工作仅将触觉作为辅助模态或在小范围任务中使用,它证明了触觉预测同样可以从数据规模化中显著获益,为精细操控提供了可扩展的感知基础。
- 基于接触事件的触觉标点推进机制:模型在推理时通过检测接触事件(如抓取、释放、贴靠等)自动切分子任务,并按此事件分段控制任务推进。这与常见的固定时间窗或纯视觉分割方案不同,它利用了操控中接触信号的明确语义,使得长时程多阶段任务的执行更稳健,无需人工编写阶段切换规则。
- 非对称混合专家架构兼顾视频质量与实时效率:N_0-TWAM 采用一个全宽 Transformer 负责未来视频预测,而为动作和触觉预测设计多个瘦专家,形成非对称建模。相对于将所有模态塞入同一大型 Transformer 的主流世界模型设计,该架构在维持高质量视觉预测的同时大幅减小推理延迟,使得触觉引导的实时闭环操控成为可能。
方法
输入与感知编码
N₀-TWAM 接收多模态流:视觉观测(单/多视角 RGB)、本体感觉(末端位姿/夹爪状态)以及触觉信号。触觉输入由 NeoForce 编码器处理,将原始触觉图像映射到统一的力-空间表征,生成物理可解释的接触信息(力向量、接触区域、变形场)。所有模态经独立 tokenizer 转为序列 token,与通过扩散强制(diffusion forcing)加噪后的动作 token 拼接,构成联合输入序列。
模型架构:非对称 Mixture-of-Transformers
核心采用 Mixture-of-Transformers (MoT) 骨干,包含三个专家:
- 全维视频专家:处理高维视觉 token,预测未来视频帧,预测残差而非完整图像以提升效率;
- 轻量动作专家:参数更少,解码末端位姿增量(delta pose)及夹爪指令;
- 轻量触觉专家:预测未来接触状态(如力场分布、接触区域)。
专家间通过共享自注意力层进行跨模态融合,但前馈网络独立,实现不对称计算——视觉预测占用大部分参数,动作/触觉专家保持轻量,保障实时推理。训练采用 条件流匹配(conditional flow matching),直接回归动作序列的向量场,避免扩散模型的多步采样。视觉与触觉预测通过扩散强制级联训练,未来帧以自回归方式逐步生成。
触觉标点与长时程执行
为突破单步预测的局限,引入 触觉接触事件分割:在演示数据中自动检测显著接触变化(如接触建立/断开、力突变)作为子任务边界。推理时,模型流式运行,实时判断当前阶段是否完成;当检测到接触事件后,自动推进下一子任务的目标条件,实现无显式状态机的长时程操控。
输出与闭环控制
模型输出未来动作序列、预测视频及预测触觉图景。实际部署采用 闭环动作解码:仅执行序列的第一步,随后重新编码新观测进行下一次预测。
差异化优势:不同于现有视觉-语言-动作模型仅将触觉作为辅助输入,N₀-TWAM 将触觉提升为与世界状态等价的预测目标,并结合力-空间表征与接触事件驱动执行,使动作生成具有物理触觉根基。
实验
实验设计
- 预训练数据集:大规模视觉-触觉联合训练数据,覆盖 6 种机器人形态和 450 个任务,使用 NeoForce 统一力触觉表示。
- 评估基准:模拟环境 UniVTAC 和 NeoSim,以及真实机器人接触丰富任务。
- 基线:包括无触觉输入的 world-action model、不使用触觉接触事件分段的变体、以及不同动作表示等。
- 消融实验:分析 Delta 与绝对末端执行器动作的影响、仿真触觉图像的真实性、预训练力编码器的迁移效果、以及触觉前瞻预测能力。
关键发现
- 大规模预训练显著提升触觉和动作预测精度:数据扩展实验中,随着演示数据量增加,触觉重建和动作预测指标持续改善,验证了 scaling law 在触觉世界模型中的有效性。
- 触觉接触事件分段 (tactile punctuation) 提升长程多阶段任务成功率:通过自动检测接触事件将任务划分为子阶段,并在推理时逐步推进,模型在需要精密接触切换的任务上表现更稳健。
- 非对称 Mixture-of-Transformers 架构实现实时推理:全宽度专家负责视频预测,轻量专家处理动作和触觉输出,在保持预测质量的同时降低推理延迟,满足部署需求。
- NeoForce 触觉表示优于传统图像触觉:基于力的统一表示提供物理一致的接触信号,更利于跨形态泛化。
与基线对比解读
与无触觉输入的 baseline 相比,N_0-TWAM 在接触密集任务中表现出显著优势,因为模型能够“预见”未来接触力并据此调整动作,避免碰撞失败。相比仅使用视觉触觉图像的模型,NeoForce 力表示提供了更紧凑的物理先验,有助于跨不同传感器和机器人形态的迁移。消融实验证实,去除触觉输入或接触事件分段会导致长程任务成功率大幅下降,表明触觉感知和时序接触结构对于精细操控至关重要。
行业影响
落地场景
N_0-TWAM 作为触觉原生世界-动作模型,直接面向 接触密集的精细操作 场景,可赋能的业务包括:
- 精密装配:电子产品、医疗器件等需要力控反馈的组装线,视觉易被遮挡,触觉是关键信息源。
- 仓库分拣与包装:形状不规则、易碎或易变形的物品抓取,通过预测接触力与滑动,提升成功率。
- 手术辅助机器人:在组织操作、缝合等任务中,触觉预测能提升安全性,降低组织损伤风险。
- 具身服务机器人:家庭场景中的开关门、拧瓶盖、插拔插头等日常操作,依赖接触力适应。
商业价值
- 降本增效:通过大规模预训练 + 微调范式,减少对每个新任务重新收集高成本触觉示教数据的依赖,缩短部署周期。
- 品质提升:联合预测未来视觉、触觉与动作,使操作更鲁棒、精细,降低装配缺陷率,提高一次性成功率。
- 新能力解锁:触觉预测使机器人能处理以往纯视觉难以解决的透明、高反光或低光照场景,拓宽自动化边界。
与现有产品/工作流的接口
N_0-TWAM 设计易于集成:
- 动作输出采用 统一末端执行器空间,可直接接入主流机器人运动控制栈(如
ROS、MoveIt)。 - 支持 流式闭环解码,适应实时控制需求,可与现有传感器驱动管线并行部署。
- 触觉分段推进机制可嵌入现有的任务规划器(如行为树、状态机),充当底层技能基元,通过接触事件驱动阶段切换。
- 与视觉-语言-动作模型(如
RT-2)互补,可作为接触交互子模块,由高层语义任务调度。
具体落地 Use Case
- 电子制造中的接插件装配:狭小空间内视觉难定位,
N_0-TWAM可利用力反馈预测插孔接触状态,指导微调动作,实现像“盲插”USB 般的灵巧操作。 - 电商仓库的异形商品打包:需要将商品精准放入包装盒并完成封箱,过程中可预测纸盒边缘受力,避免压坏商品,同时通过触觉事件判断纸盒是否到位,提高自动化包装线的柔性。
局限
- 模型依赖 NeoForce 从视觉触觉图像中提取力场作为统一表示,但现实触觉传感器模态多样(如压阻阵列、磁流变等),输出特性差异大,NeoForce 的预训练数据集可能未覆盖全,导致跨传感器泛化困难。训练数据来自特定硬件(如 GelSight),更换传感器时力估计精度可能下降,进而影响接触事件检测和动作生成,制约了在多样化触觉硬件上的直接部署。
- 不对称 MoE 架构虽分离了视频预测和动作预测计算,但视频预测专家仍较宽,且多专家推理需协调,可能造成延迟。论文未报告在真实机器人上的端到端推理频率(如每秒帧数),与工业级实时控制(>100Hz)相比可能存在差距。在嵌入式计算平台上部署时,模型压缩或量化可能成为必需,而论文未探讨这些工程优化路径。
- 长时序任务分段依赖预定义的接触事件,其定义基于人工标注的力变化阈值或模式,对新任务或新奇接触模式须重新设计,泛化受限。真实世界评估仅在少量任务和固定环境下进行,缺乏在动态扰动、非结构化环境或柔性物体操作中的验证。此外,未评估安全性和故障恢复能力,限制了在安全至上场景中的可信度。