从 RLVR 到 RLSVR:任务变换为开放式 LLM 自我改进引入自验证奖励
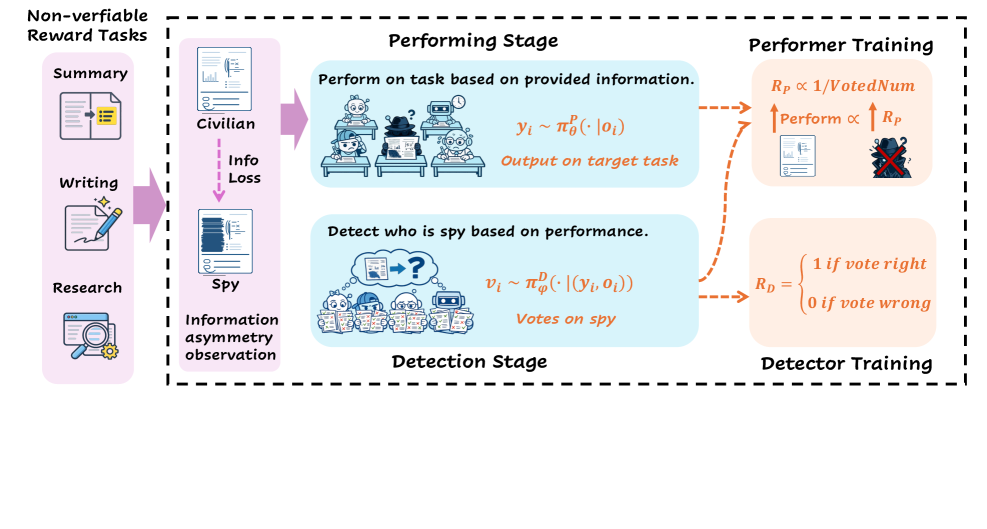
RLVR(基于可验证奖励的强化学习)通过大规模优化推动了推理型大语言模型(LLM)的进展,但其应用仍局限于数学、编程等可确定性验证的领域。开放式任务通常依赖人类偏好、奖励模型或 LLM 裁判,带来了评估偏差、裁判能力瓶颈和额外推理成本。 借鉴自监督学习利用数据自身构建前置任务的思想,我们提出 RLSVR(基于自验证奖励的强化学习),一种基于任务变换的训练范式,将开放式任务转化为可验证的代理环境,由内部规则和交互结果自动生成奖励信号。我们以 SpyRL 实例化 RLSVR:这是一个受“谁是卧底”启发的多智能体自博弈环境,智能体获取不对称信息,完成同一目标任务,并投票找出指定卧底。由于卧底身份预知,投票结果提供完全可验证的奖励,且成功识别与输出质量密切相关。 在文本摘要、创意写作和数学推理上的实验表明,SpyRL 在非可验证任务上优于现有自我改进方法,并在可验证推理任务上取得一致提升。这些结果证明,任务变换可将可扩展的基于 RLVR 的自我改进推广到非固有可验证领域。模型和代码已开源。
论文精读
TL;DR 将开放任务转化为“谁是卧底”式自对弈环境(SpyRL),以可验证的投票结果作为奖励信号,实现LLM无需人类偏好的可扩展自我改进。
问题
问题背景
当前,大语言模型 (LLM) 的 自我改进 (self-improvement) 能力成为提升模型性能与降低人工标注成本的核心方向。可验证奖励的强化学习 (RLVR) 为数学、编码等可自动验证正确性的任务带来了显著的规模扩展优势,推动推理型 LLM 快速发展。
现有方法局限
然而,在文本摘要、创意写作、对话等 开放任务 (open-ended tasks) 中,缺乏可编程判定正确性的标准答案。现有方法主要依赖 人类偏好、奖励模型 或 LLM 评判 提供训练信号,存在以下技术瓶颈:
- 评估偏差:LLM 评判存在位置偏差、风格偏向,且能力上限受裁判模型制约。
- 成本与可扩展性:大规模调用高级裁判模型带来高昂的推理成本和时间延迟,限制了训练规模。
- 奖励不可复现与不可验证:相同输出可能因裁判的不确定性得到不同奖励,破坏 RL 优化的稳定性。
因此,RLVR 的优势难以直接迁移至更广泛的应用场景,成为当前 LLM 自提升研究的关键缺口。
技术挑战与重要性
将可验证奖励机制拓展至开放任务面临根本性难题:如何在无客观答案的条件下,自动生成 可信、一致且与任务质量高度相关 的奖励信号?这涉及 奖励设计 的重新构思,需要算法既能保持 RLVR 的确定性验证特性,又能泛化到多样化的文本生成任务。业界对此高度关注,因为突破这一瓶颈后,RL 驱动的自提升范式 将能在更大量级的数据和任务上实现无人干预的持续进化,显著降低 LLM 部署与迭代的门槛。
行业类比
这一挑战类似于 自监督学习 如何从无标签数据中构造预文本任务 (pretext task) 来获取监督信号,旨在将开放域 RL 的训练奖励从依赖外部评判转变为从任务内在结构中自动衍生;例如,在自动化内容评测系统中,通过多智能体交互规则直接产生可验证的胜负结果。
核心洞察
- **任务转换实现开放域自验证奖励**:RLSVR 的核心思想是将开放任务转换为具有内置规则的代理环境,使其能够自动生成可验证的奖励信号,从而摆脱了对人类偏好或外部裁判的依赖。与先前仅适用于数学、代码等封闭域的 RLVR 不同,该方法通过构建信息不对称、投票等机制,将生成质量间接映射为博弈结果,真正将规模化 RL 自改进扩展到开放任务,同时避免了人工评估的偏差与高昂成本。
- **信息不对称自博弈将质量信号隐藏于可验证博弈中**:SpyRL 的多智能体设计引入卧底与投票对抗,使奖励信号完全由预定规则决定(投票准确度),而无需直接评估文本质量。这种精巧的构造将开放式任务的质量诉求转化为“识别身份”这一可验证目标,确保奖励的客观性同时与输出质量高度相关,与单智能体自评或简单答案匹配有本质区别,为开放域自监督训练提供了新范式。
方法
方法概述
RLSVR 将开放式任务转化为自验证代理环境,通过多智能体自玩与信息不对称设计,自动生成完全可验证的稠密奖励,无需外部评判模型。
输入与任务转换
给定一个开放式任务(如文本摘要、创意写作),RLSVR 在原始任务外层构建一个 SpyRL 游戏:
- 随机分配若干智能体(LLM 实例),其中一名被指定为卧底,其余为平民。
- 所有智能体收到相同的任务提示,但卧底会额外获得一条扰动信息(如摘要任务中要求省略关键实体),其余智能体获得正常信息。
关键模块:两阶段自玩流程
信息不对称执行阶段 (Performing Stage)
- 每个智能体独立生成响应,卧底的输出因信息差异而偏离真实任务目标。
- 所有响应被收集,作为下一阶段的上下文。
可验证检测阶段 (Detection Stage)
- 智能体阅读所有响应并投票识别卧底。
- 由于卧底身份在游戏开始前已预设,投票结果直接产生完全可验证的奖励:若多数票正确指认卧底,则平民团队获得正奖励,卧底获得负奖励;反之则卧底成功。
奖励设计与优化
- 奖励信号由游戏规则内生决定,无需任何人类偏好或外部裁判,消除了评判偏见。
- 使用 Group-based Advantage 估计每个智能体的优势函数,隐式鼓励高质量输出(因为输出质量越高,卧底越难隐藏,或平民越易识别)。
- 训练采用两阶段耦合优化:执行阶段和检测阶段交替更新,使模型同时提升任务执行能力和甄别能力。
输出
训练后的模型在原始开放式任务上直接推理(不加游戏封装),其生成质量经由自玩过程得到提升,在摘要、写作等基准上优于基于 LLM-judge 的自我改进方法。
与同类工作的关键差异
RLSVR 借鉴自监督学习中构造前置任务的思想,将开放式域转换为规则约束的自验证环境,彻底摆脱对外部奖励模型或人类反馈的依赖,实现了可扩展的 RLVR 式训练。
实验
实验设计
SpyRL 基于 RLSVR 框架,将开放性任务(文本摘要、创意写作)转化为可验证的代理环境。通过信息不对称的多智能体自博弈(类似“谁是卧底”游戏),模型分两阶段:表演阶段 生成任务内容,检测阶段 投票识别间谍。由于间谍身份预先设定,投票结果自动产生完全可验证的奖励,且识别准确度与生成质量高度相关。实验覆盖三种任务领域:文本摘要、创意写作 和 数学推理(原属可验证任务,用于测试泛化性)。基线方法包括基于人类偏好、奖励模型或 LLM 评判的自改进路线(如 RLHF 变体),训练均采用 RLVR 优化策略。
关键发现
- 非可验证任务突破:SpyRL 在摘要与创意写作上显著优于现有自改进方法,其自博弈奖励内生且完全可验证,消除了评判模型带来的偏差与能力瓶颈。
- 可验证任务增益:在数学推理等原本已有确定性验证器的任务上,SpyRL 同样带来一致提升,表明 任务变换 范式的通用性与稳健性。
- 无额外推理成本:训练阶段仅依赖自博弈产生的投票标签,不引入外部 LLM 评判,推理时无需额外开销。
基线对比深度解读
传统 RLVR 依赖确定性验证器,仅适用于数学、编程等封闭域。RLSVR 通过构造代理任务(如间谍检测)将开放域转化为内部规则可验证的环境,从根本上拓展了可扩展自改进的边界。与使用 LLM-as-Judge 的方法相比,后者受限于评判模型的能力与偏见,且需额外推理计算,而 SpyRL 的奖励信号来自环境规则本身,无上限地随主模型能力提升而增强。自博弈设计还天然促进模型在信息不完整条件下推理与生成能力,使奖励密度与任务目标高度一致。
行业影响
落地场景
RLSVR 及其实例化框架 SpyRL 将开放任务(如文本摘要、创意写作)转化为基于多智能体自我对弈的可验证代理环境,自动产生奖励信号。这直接适用于以下产品与业务:
- 内容生成与审核:电商文案生成、新闻摘要、社交平台创意内容,原本依赖人工或 LLM 裁判,成本高且易有偏置,SpyRL 可嵌入内容生产链路,实现无人干预的自动优化。
- 对话与交互式 AI:客服、教育辅导、游戏 NPC 对话等场景,通过信息不对称的角色扮演生成对比样本并投票,驱动回复质量不断提升。
商业价值
- 降低运营成本:消除对昂贵人工反馈或高级评判模型的依赖,训练循环完全自驱动,减少标注和评审开销。
- 增强模型可扩展性:模型能通过自我对弈持续产生新训练信号,无需周期性重新收集偏好数据,缩短迭代周期,使 LLM 服务随使用自然提升。
- 改善主观任务质量:在创意、解释类任务上输出更一致、高质的内容,提升内容平台用户留存、电商转化率及教育产品互动深度。
与现有产品/工作流的接口
- 插入现有 RLHF 管线:SpyRL 可作为微调后的额外自我对弈阶段,与 PPO/DPO 等算法无缝衔接,增强策略鲁棒性。
- 集成多智能体框架:如 AutoGen、CrewAI 等工具中,用 SpyRL 的检测-表演两阶段循环替代固定规则评判,实现自动样本对比与奖励生成。
- 奖励微调与蒸馏:将自我对弈产出的奖励模型用于微调基线 LLM,或蒸馏到轻量级模型,便于部署。
具体落地案例
- 电商商品描述优化:平台生成多条商品描述,让多个 LLM 扮演不同信息角色(一个掌握完整卖点,其余仅见部分),通过投票识别“优势描述”,投票结果作为奖励训练生成器,无需人工打分。
- 在线教育内容质量提升:生成习题解析时,设置“间谍”模型故意引入错误,其他模型尝试识别并修正,获胜方获得奖励,促使所有模型产出更准确、更具启发性的教学解释。
局限
- **任务转换的泛化难度**:RLSVR 的有效性高度依赖于能否为开放式任务设计出具有内部规则和自动奖励的代理环境。例如,SpyRL 利用了‘谁是卧底’这类信息不对称的投票机制,但这种游戏化设定可能难以直接迁移到对话生成、情感分析等缺乏明确博弈结构的开放式任务上。对于更广泛的任务类型,构造对应的可验证代理环境可能需要大量领域知识,且设计不当的环境可能引入与原始任务无关的偏差,限制方法的普适性。
- **多智能体交互的计算开销与训练稳定性**:SpyRL 涉及多个 LLM 实例在表演阶段和检测阶段的接力式生成与投票,单次 rollout 需要至少两轮推理和额外的选举逻辑,这导致训练时的推理成本显著高于单智能体 RL 方法(如 DPO 或 PPO)。此外,自我对弈训练中智能体策略的同步更新可能带来策略漂移和收敛难度,论文虽然采用了交替优化策略,但在更复杂环境中仍需额外的稳定性技巧,实际部署时资源需求较高。
- **奖励信号的粒度与输出质量的关联性**:SpyRL 的奖励仅取决于卧底是否被正确识别(群体投票结果),这是一个二元、延迟的奖励信号,与生成文本的流畅性、事实性等细粒度指标没有直接对应。尽管实验显示这种粗糙奖励能够有效引导 LLM 提升任务表现,但奖励的稀疏性可能限制微调过程中的探索效率,且论文未深入分析是否存在‘奖励黑客’行为(例如智能体学会通过非内容因素影响投票而非提高输出质量)。