dRAE: 使用超球面代码的表示自编码器
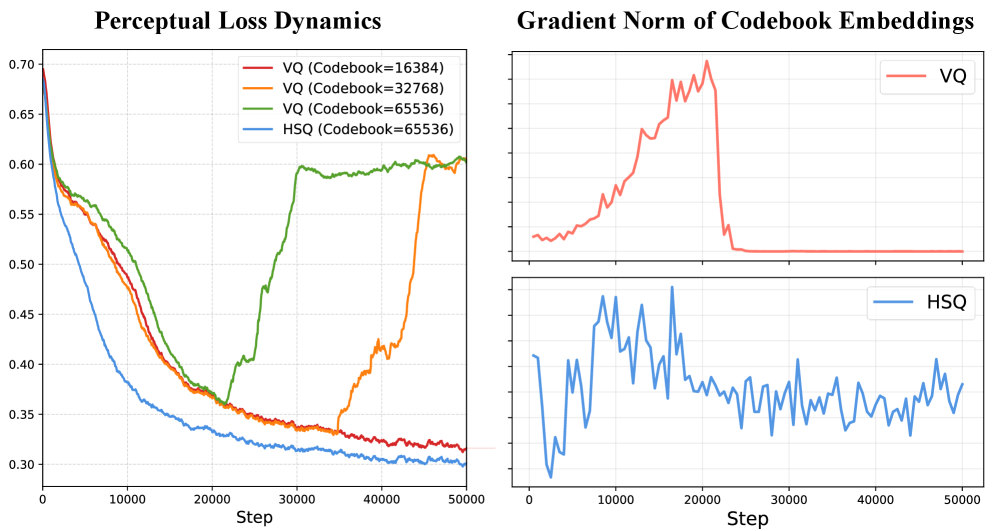
本研究旨在将高维视觉表示离散化,以弥合与语言模型之间的差距——这是一项艰巨的挑战,因为现有量化方法面临代码书崩溃问题,无法在保持语义一致性的同时进行扩展。我们将其根源归因于度量不匹配:标准的欧几里得代码书目标与表示空间的各向异性几何结构本质不一致,导致代码书嵌入具有高方差的幅度尺度和不均匀的角度分布,阻碍了可扩展性。为解决此问题,我们提出超球面量化(HSQ),通过角度路由将语义内容与特征幅度解耦,防止代码分配被尺度而非意义主导。由此产生的离散表示自编码器(dRAE)实现了高保真重建,同时保持语义完整性并支持可扩展的代码书预算。大量实验表明,随着词汇量扩展到131,072,性能持续提升,代码书利用率达100%,训练流程简化,并在理解和生成任务上表现强劲。
论文精读
TL;DR 提出超球面量化 (HSQ),通过角度路由解耦语义与幅度,根治码书坍塌,实现 100% 利用率且可扩展至 13 万词表的离散视觉表示,兼具重建保真与语义连贯。
问题
问题背景
多模态大模型需要将连续视觉表征转化为离散 token 以统一处理,这要求视觉分词器(tokenizer)既能高保真重建,又能保持语义一致并支持大规模词汇表。
现有方法局限
主流 VQ-VAE 系列 基于 欧氏距离 进行码本最近邻查找,但与视觉表征空间的 各向异性(anisotropy) 几何相冲突:特征向量模长方差大、角分布不均匀,导致码字分配被 幅度 主导而非语义相似度。后果是码本嵌入尺度波动剧烈,训练时 码本崩塌(codebook collapse) 严重——仅少数码字被激活,大量码字闲置,且扩展码本规模时语义一致性急剧下降。传统补救措施(如 EMA 更新、额外熵损失)增加了训练复杂度,却无法根除几何失配问题。
为什么这个问题难/重要
高维空间的各向异性是内在特性,简单 L2 归一化会丢失幅度信息,损害重建细节;保留幅度则使量化始终受干扰。业界关注多模态模型的规模定律,但现有 VQ 方案无法在低成本下同时实现高重建质量、100% 码本利用率和语义连贯性,成为限制模型容量与生成质量的关键瓶颈。
行业类比
就像在大语言模型中,为了稳定训练数十万词汇的 tokenizer 必须依赖 余弦相似度 而非点积,视觉分词器同样需要在 球面流形 上定义量化,消除幅度偏差,才能实现可扩展的语义token化。
核心洞察
- **欧几里德度量与各向异性表示空间的失配是导致码本崩塌的核心机制**。传统矢量量化(VQ-VAE 等)在欧氏空间中搜索最近邻,但高维视觉表示具有极端的各向异性——特征点的幅度分布方差大、角度分布不均匀。这使得码本嵌入的幅度差异显著,代码分配容易被样本的幅度劫持而非语义相似性,训练时大多码本项得不到更新,表现为利用率低、扩展困难。dRAE 率先将此问题明确为 metric mismatch,并通过统计分析与实验验证其普遍性,为可缩放离散表示学习指出了新的方向。
- **超球面量化(HSQ)通过角度路由将语义与幅度解耦,以极简训练范式实现可扩展的语义离散化**。HSQ 将所有特征投影到单位超球面,代码分配仅依赖余弦相似度,避开幅度干扰;额外引入一个幅度回归分支,独立优化重构所需的尺度信息。这样码本只需学习归一化方向向量,天然消除幅度崩塌。实验显示,码本规模可轻松扩展至 131,072,全程保持 100% 利用率,无需 VQGAN 多样的辅助损失、Lookup-VQ 的重启技巧或 FSQ 的受限投影,大幅简化训练流程并统一支撑理解与生成任务。
方法
dRAE 的核心思路是将高维视觉表示离散化,其流水线为:输入图像 → 编码器 → 超球面量化(HSQ) → 解码器 → 重建图像。
编码器与特征解耦
给定图像,编码器(如 ViT)输出一组高维特征向量。这些向量通常呈现各向异性:不同特征维度的幅度差异大,导致欧氏距离主导的量化偏向大尺度向量。HSQ 首先将每个特征向量解耦为 L2 范数(幅度) 和 单位方向向量。幅度信息被单独保留,而方向向量用于后续的角度路由。
超球面量化(HSQ)
码本由一组单位范数的嵌入向量组成,分布在高维超球面上。量化时,对每个特征方向向量计算与所有码本向量的余弦相似度(内积),选择得分最高的码本索引作为离散编码。由于码本向量被约束为单位长度,分配过程完全由角度相似性驱动,语义相近的图像区域自然对应相近的方向,而非被尺度差异劫持。幅度信息可通过附加的标量量化器或单独编码与重建,保持重建的保真度。
解码与重建
解码器接收离散码本索引和对应的幅度信息:从码本中查找单位方向向量,与幅度相乘还原特征,再输入解码器生成图像。训练时,损失函数包含:
- 重建损失:约束像素级保真度;
- 量化损失:促使编码器输出向码本向量对齐(基于余弦距离);
- 幅度重建损失:保证解耦的幅度信息一致。
与同类方法的差异
传统矢量量化(VQ-VAE 等)直接在欧氏空间计算距离,因度量不匹配导致码本嵌入幅度漂移、利用率低下(码本塌缩)。HSQ 将量化转移到超球面,通过归一化消除幅度干扰,实现 100% 码本利用率,并支持将词汇表扩展至 131k 以上而无性能衰减。这种角度路由范式为离散表示学习提供了更稳定的可扩展基础。
实验
实验设计
dRAE 的实验围绕离散表示自编码器的构建与评估展开,涵盖图像重建、多模态理解与生成任务。训练流程以高维视觉特征为输入,通过超球面量化 (HSQ) 将其映射为离散码,再利用解码器重建原始特征或图像。为验证可扩展性,码本大小逐步扩展至 131,072,并与基于欧氏距离的传统量化方案 (如 VQ-VAE) 进行系统对比。消融研究分析 HSQ 各组件的影响,包括角度路由、幅度解耦等机制。
关键发现
- 根因定位:传统量化方法受度量不匹配困扰,欧氏距离在高维各向异性表示空间中失效,导致码本嵌入幅度方差大、角度分布不均,进而引发码本利用率低下甚至码本崩溃。
- HSQ 优势:通过角度路由将语义内容与特征幅度解耦,码本分配不再被尺度主导,从而在 131,072 词表规模下实现 100% 码本利用率,且重建保真度与语义完整性随码本扩大持续提升。
- 训练简化:HSQ 消除了依赖额外损失项(如承诺损失)的需求,训练管道更简洁,收敛更稳定。
与基线对比的深层解读
传统向量量化 (Vector Quantization) 使用欧氏距离衡量编码器输出与码本向量之间的相似性,这在各向同性的假设下成立。然而,现实中的高维视觉表示呈现明显的各向异性,特征幅度成为主导分配的因素,而非语义内容,导致码本中少数向量被反复使用,其余则为“死向量”。dRAE 通过将特征投影到单位超球面上进行角度度量,强制分配仅依赖方向信息,从源头切断了幅度干扰。该设计不仅大幅提升小词表下的重建质量,更使词表容量可线性扩展至 131k 级别,为大规模视觉语言模型的衔接提供了可扩展的离散化方案。从工程角度看,超球面量化 的引入无需改变现有 VAE 架构主体,仅替换量化层即可,部署成本低,适合作为下一代视觉 tokenizer 的基础组件。
行业影响
落地场景
dRAE 提供了一种高保真、可扩展的离散视觉标记器,核心创新超球面量化 (HSQ) 解耦幅度与语义,使 codebook 利用率达到 100%,支持 13 万级词汇量。这直接服务于需要将视觉信号转换为语义 token 再接入语言模型或生成模型的产品线:多模态对话系统、视频理解与生成、图像搜索与推荐、自动驾驶感知压缩等。对于高分辨率、细粒度视觉理解需求,dRAE 避免了传统 VQ-VAE 的码本崩溃问题,确保大规模 codebook 下语义一致性不退化。
商业价值
- 降本:训练 pipeline 大幅简化,无需 codebook reset、EMA 等额外技巧,减少工程维护与调参成本;全码本利用意味着计算资源零浪费,同等预算下可获得更高效的特征表达。
- 增收/体验提升:更稳定的重建质量直接改善生成类产品的图像清晰度与语义保真度;在多模态大模型 (MLLM) 中,高质量的视觉 token 能提升问答、推理等下游任务性能,增强产品竞争力。
与现有产品/工作流的接口
dRAE tokenizer 可直接替换现有 VAE 或 VQ-VAE tokenizer,无缝接入主流框架(如 LLaVA、Flamingo、Stable Diffusion 等)。其基于角度路由的设计与标准 Transformer 架构天然兼容,无需定制化适配层。项目已开源 GitHub 并提供预训练模型,可快速通过 pip 或 HuggingFace 集成,大幅缩短从研究到部署的周期。
具体落地用例
- 电商多模态搜索:将商品图片经 dRAE 编码为离散 token 序列,与商品描述文本 token 拼接输入大语言模型,实现像素级与语义级联合匹配,显著提升搜索相关性。
- 自动驾驶环境理解:车载摄像头图像被压缩为紧凑的语义 token 流,作为端到端驾驶模型(如 UniAD)的输入,在低延迟条件下保持对复杂交通场景的细粒度语义捕捉,助力更安全的决策。
局限
- **对特征各向异性的依赖**: 论文明确指出标准欧氏距离与高维表示空间的各向异性几何不匹配是现有量化方法失效的根因,并基于此假设提出 HSQ。然而,该方法能否泛化到相对各向同性或低维特征空间尚未被验证。实验仅使用特定 ViT 编码器,未讨论当特征分布与强各向异性假设偏离时,角度路由是否仍能有效解耦语义与幅度,这可能限制了 dRAE 在不同预训练模型或跨模态特征上的即插即用能力。
- **下游任务评估的局限性**: 论文主要关注图像重建质量和离散视觉 token 的生成性能,在与语言模型桥接方面仅展示了基于离散扩散模型的图像生成和有限的多模态理解实验。缺少与连续表示在端到端多模态大模型(如 LLaVA 风格)上的直接公平对比,且未报告将 dRAE 离散 token 输入语言模型后在下游 VQA、captioning 等任务上的微调性能与现有连续方案的差异,难以判断语义保真度在真实理解任务中的实际收益。
- **计算与信息容量权衡**: HSQ 引入 L2 归一化和超球面上的角度路由,虽然简化了辅助损失的需求,但归一化操作可能丢弃幅度信息,而幅度在某些任务中可能编码了有用置信度或强度信号。论文未定量分析归一化导致的信息损失,也未报告与保留幅度信息的混合量化方案的对比。此外,对于超高维向量(如 4096 维 ViT 特征),余弦相似度计算与球面 k-means 的迭代开销可能在极大规模 codebook 下成为瓶颈,论文未讨论实际训练吞吐与内存占用,这会让工程落地时的资源评估带来不确定性。