通过模拟合成:借助可扩展的 Agent-System 交互生成连贯的企业数据
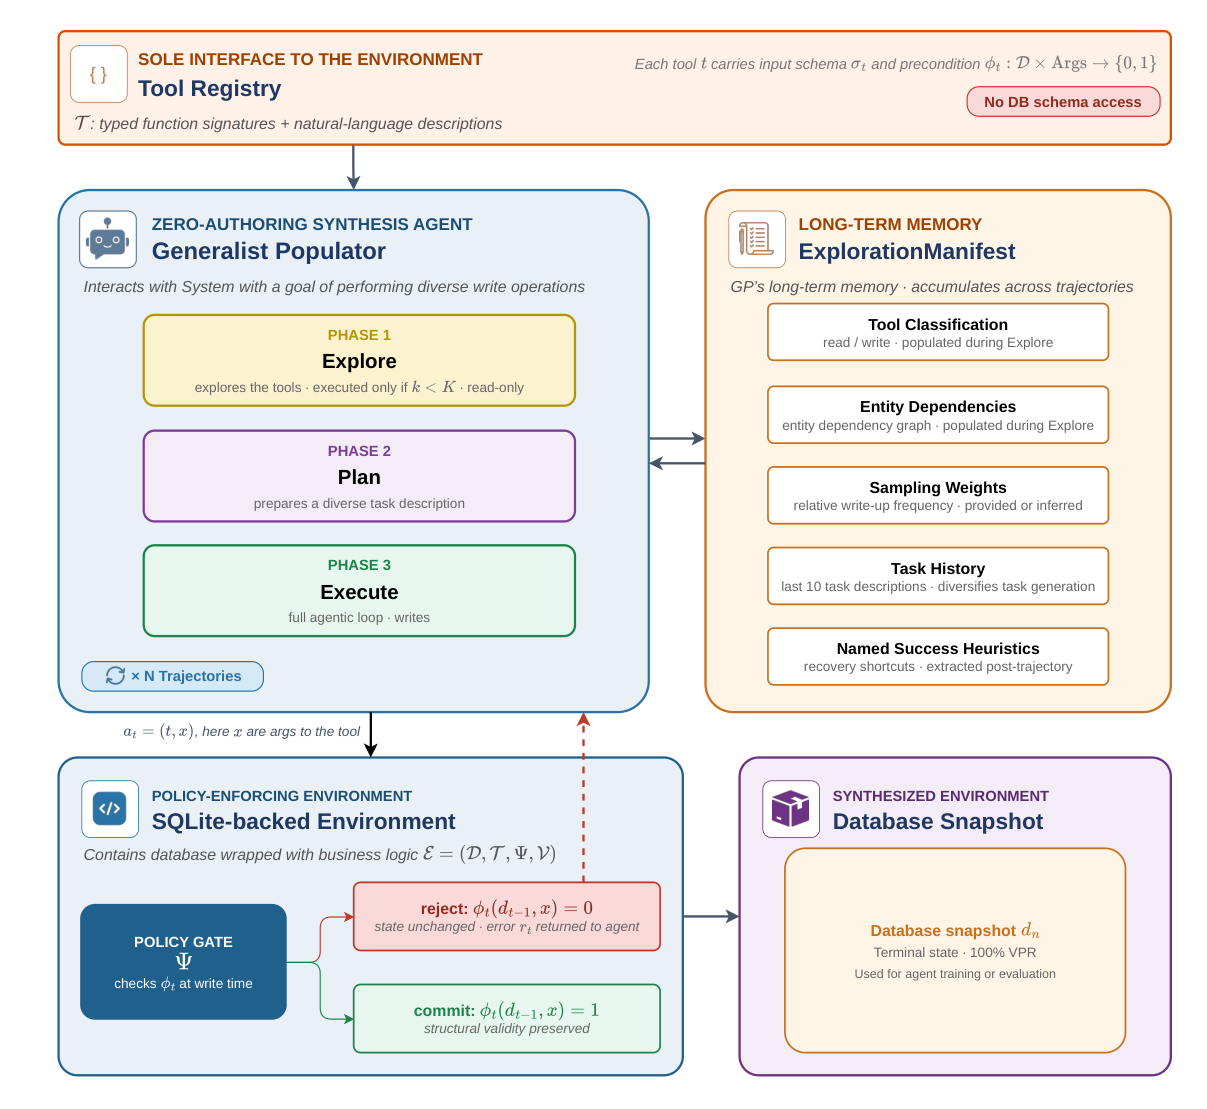
Tool-calling agent 已成为企业 AI 的核心,但受企业系统、数据与数据库 schema 的商业与法律限制,其大规模训练与评估严重受阻。表格数据合成是自然的替代方案,却受制于结构有效性与 schema 可得性;基于流程的方法则呈相反的弱点,若不逐域编写,通常缺乏分布保真度。 我们提出 Synthesis Through Simulation(STS),一种 schema-free 的数据合成范式:LLM agent 在模拟企业环境中针对执行策略的 API 反复操作来生成数据。由于数据由定义「何为有效」的同一环境产生,STS 在构造上即保证结构有效性,并将有效性约束与分布建模解耦,使二者可各自独立优化。 STS 的领域无关 agent Generalist Populator(GP)进一步解决分布保真度与合成可扩展性问题: - 在无法访问 DB schema 的前提下,GP 于全部十个环境中取得 0.88 的平均边际保真度与 100% 的约束满足率; - 统计式合成器因必需的种子数据要求,在七个环境中不适用; - 具备 schema 权限的 agent 在 airline 环境的紧耦合工作流中,因任务组合脆弱,82% 的轨迹失败。 我们已开源完整框架、全部十个环境与生成数据集:https://github.com/SAP/synthesis-through-simulation 。
论文精读
TL;DR STS 让 LLM 智能体在模拟企业环境中通过策略执行 API 生成数据,无需 schema 即保证结构有效;通用填充器 GP 在 10 个环境达 0.88 边际保真、100% 约束满足。
问题
问题背景
工具调用智能体在企业 AI 中应用广泛,但训练与评估所需的真实交互数据严重受限,数据合成成为关键替代路径。
现有方法局限
- 表格数据合成依赖数据库 schema 和种子数据,在复杂企业环境中面临结构有效性问题,且当 schema 不可获取时无法应用。
- 基于过程的方法需要逐领域手工编写规则,缺乏分布保真度,合成数据与真实分布偏差大,难以支撑稳定的智能体训练。
为什么难/重要
企业数据受商业与法律约束,schema 通常不可见;多表之间存在跨表约束与紧密耦合的工作流,单一策略难以同时保证结构合法与分布真实。业界亟需一种不依赖 schema、可扩展且约束满足的合成范式。
行业类比
类似自动驾驶以仿真环境生成训练数据,STS 通过模拟企业环境中的策略强制 API 生成合法交互数据,绕过真实系统访问限制。
核心洞察
- 合成数据的结构有效性与分布保真可以解耦,STS 让环境负责前者,agent 专注后者。传统统计合成器依赖 schema 和种子数据,过程化方法需要人工编写领域规则,两者往往顾此失彼。STS 通过策略执行 API 将约束嵌入模拟环境,生成过程天然满足约束,同时 GP 用 LLM 学习分布,达到 100% 约束满足和 0.88 平均边际保真,且无需 schema 或种子数据。这种设计降低了对领域先验的依赖,提高了跨领域可扩展性。
- GP 作为通用填充 agent,通过与环境交互而非直接生成表格数据,实现了 schema-free 的企业数据合成。与 schema-privileged agent 相比,后者依赖 schema 组合任务,在紧耦合工作流中失败率高达 82%,因为任务组合脆弱。GP 不假设 schema,而是通过探索环境约束和先验知识生成,避免了对任务分解的依赖,在不同环境中表现更稳健。这为没有 schema 访问权限或 schema 不完整的企业环境提供了可行路径。
- STS 生成的数据不仅可用于统计评估,其生成过程本身构成 agent 轨迹,可直接用于下游工具调用 agent 的训练。企业训练工具调用 agent 通常受限于真实系统交互成本和法律风险,STS 生成的合成轨迹减少了对真实系统的依赖。论文显示下游 agent 在合成数据上训练后性能提升,验证了生成数据的有效性。这打通了从合成数据到 agent 训练的闭环,降低数据获取门槛。
方法
输入
STS 的输入仅为企业环境的交互定义:策略执行 API 集合、可用操作空间以及环境状态约束。无需数据库 schema,也不要求任何真实种子数据。
关键模块
1. Policy-Enforcing Environments
模拟企业系统,将结构有效性规则内嵌于 API 执行逻辑中。每当 agent 尝试写入数据时,环境自动检查约束(如外键关系、字段格式、业务规则),只有合法操作才会成功。因此,结构有效性由构造保证,与分布建模彻底解耦。
2. Generalist Populator (GP)
领域无关的 LLM agent,通过与环境闭环交互生成数据。其流程包括:
- 探索阶段:agent 通过试探性调用 API 学习环境约束和可行的操作路径。
- 规划阶段:基于已学知识生成写入计划,可能采用启发式提取与任务分解(如
bulk批量执行 vs.single-task单步执行)。 - 执行阶段:调用 API 写入数据,失败时根据反馈调整策略。
整个过程不依赖任何领域模板或手工 schema 映射,agent 完全从交互中归纳有效的数据生成模式。
输出
生成的企业数据集,具备结构有效性(100% 约束满足)和分布保真度(平均边际保真度 0.88),可直接用于下游工具调用 agent 的训练与评估。
与同类方法的差异
相比统计合成器(依赖 seed data 和 schema)与 schema-privileged agent(任务组合脆弱、在紧密耦合工作流上失败率高),STS 通过模拟环境内执行操作,将有效性验证下沉到环境层,从而同时获得结构保证与分布建模的灵活性,且无需任何 schema 或种子数据。
实验
实验设计
论文在 10 个模拟企业环境 中评估 Generalist Populator (GP)。这些环境通过 policy-enforcing APIs 定义操作合法性,GP 作为领域无关 agent,仅基于 API 交互生成数据,不访问任何 DB schema。
- 指标包括 marginal fidelity、pairwise/cross-table distribution fidelity、constraint satisfaction 以及 successful write operations。
- 对比基线:statistical tabular synthesizers(需要 seed data 和 schema)与 schema-privileged agents(显式获得 schema,通过工具组合完成任务)。
关键发现
- GP 平均 marginal fidelity 达到 0.88,且在所有环境上实现 100% constraint satisfaction。
- Statistical synthesizers 在 7/10 环境中不可用,因为缺少必要的 seed data;而 GP 完全摆脱此限制。
- 在 airline 环境的 tightly coupled workflows 上,schema-privileged agents 有 82% 轨迹失败,暴露其任务组合的脆弱性;GP 通过环境内逐步执行规避了该问题。
跟基线对比的深度解读
STS 的核心优势在于将结构有效性保障与分布建模解耦:由于数据通过定义合法性的同一环境生成,结构有效性由构造保证,无需事后校验。
- 对比 tabular synthesizers:传统方法强依赖 schema 和已有数据分布,而 GP 只依赖交互反馈,天然适用于 schema 未知或敏感的企业场景。
- 对比 schema-privileged agents:后者拥有完整 schema 却因需要多步工具调用组合而失败率高,说明“知道 schema”并不等于“能生成连贯数据”;GP 的 simulation-native 路径避免了脆弱的任务规划。
该结果对实际工程的启示:在构建企业级合成数据流水线时,优先设计 policy-enforcing 模拟环境,而非依赖静态 schema 或黑盒采样器,能同时获得结构有效性和分布保真度。
行业影响
落地场景
STS 可直接服务于需要 tool-calling agents 的企业 AI 产品,例如:
- 电商订单处理助手:模拟订单、支付、库存 API 环境,生成大量合法轨迹,训练能处理退货、改价、优惠叠加等复杂工作流的代理。
- 企业 ERP/CRM 智能助手:针对 SAP、Salesforce 等系统,schema-free 生成多表关联数据,用于微调和评测代理在审批流、数据录入、跨模块查询中的表现。
商业价值
- 降本:避免真实企业数据使用中的合规审批、脱敏和人工构造环境成本。GP 无需 DB schema,省去 schema 设计/维护,合成环境可复用。
- 加速迭代:训练和评估数据可按需批量生成,支持快速 A/B 测试和回归,缩短 agent 开发周期。
- 可靠性:100% 约束满足和 0.88 平均边际保真度,降低合成数据引入的偏差风险,提升下游模型上线信心。
与现有工作流接口
STS 以开源框架形式提供,可作为 数据合成层 插入 MLOps 流水线:
- 用 JSON/YAML 定义策略约束和 API 规范,无需数据库 schema。
- 部署模拟环境,运行 Generalist Populator 生成数据集。
- 输出格式兼容常见训练/评测框架(如 OpenAI Evals、LangSmith),可直接进入 fine-tuning 或 offline evaluation。
具体用例:在电商场景中,团队可基于 STS 模拟订单全生命周期(创建→支付→发货→退换),生成 10k+ 条多步代理轨迹,用于训练客服代理处理退款纠纷;同时利用生成的数据库快照做回归测试,无需触碰生产数据。
局限
- - **计算成本与 LLM 依赖**:GP 生成数据依赖 LLM 进行多次推理与工具调用,相比传统统计合成器(如 CTGAN、TVAE)在 CPU 上直接采样,推理成本可能高出数个数量级。论文未提供与统计方法在同等数据量下的成本对比,也未讨论批量推理优化或缓存策略,这限制了其在资源受限场景或大规模数据生成任务中的部署可行性。
- - **模拟环境构建的工程门槛**:STS 要求为每个企业领域构建策略执行 API,这涉及对业务规则、约束和状态转换的显式建模。虽然声称 schema-free,但实际仍需领域专家定义 API 行为、字段先验和约束,其工程量可能不亚于传统程序式合成的作者成本。论文未给出环境构建的标准化流程或自动化工具,跨域复制存在障碍。
- - **分布保真度上限与评估局限**:GP 平均边际保真度为 0.88,个别环境可能更低,且仅与可用统计合成器在少数环境比较,缺乏与真实数据分布的直接对齐验证。论文未分析生成数据中潜在的长尾缺失、时间序列依赖或多表关联精细度,这些在企业决策、风控等场景中可能显著影响下游模型性能。