基于检索的开放式评估在哪里失败?从长文本医学答案事实性验证出发的自动分类体系归纳
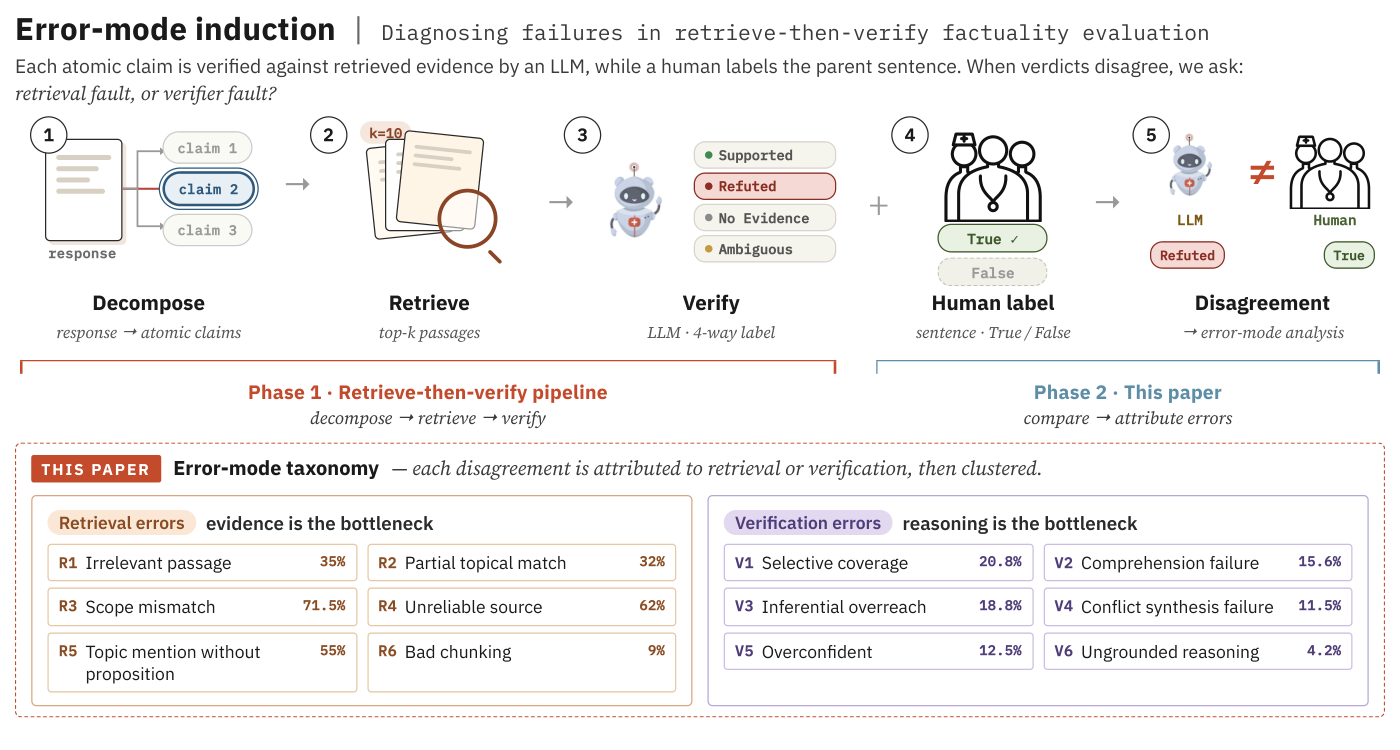
基于检索的事实性评估——用权威医学语料中的证据验证 LLM 生成的论断——已成为高风险临床场景中可扩展幻觉检测的主流范式。但现有系统多以 F1 等聚合指标衡量性能,掩盖了失败发生在哪里、为何发生;而既有的 RAG 诊断方法依赖金标准答案或人工标注证据,在这一场景中二者都不存在。 我们以 MedExpert 开放式数据集及 3 个封闭式数据集的案例研究为基础,提出两套分类体系:把失败拆解为检索阶段错误 的五个质量维度,以及验证器推理错误 的六个连续步骤。我们还改造了一套自动模式归纳流水线,借助 LLM-as-Judge 大规模标注证据质量、分类验证器推理错误。 随后我们在 4 种检索方法 与 6 个前沿验证器模型 上对结论做压力测试。分析显示:增大模型规模、增加推理投入、扩展到权威网页来源、进行医学微调,都无法消除这些失败模式。 这说明它们是 retrieve-then-verify 范式在开放式医学场景中的根本局限,而非过时系统造成的假象。代码与数据已发布于 https://anonymous.4open.science/r/MedicalRAGeval-4AB5 ,以保证结果完全可复现。
论文精读
TL;DR 本文用 LLM-as-Judge 自动归纳两阶段失败分类法,系统剖析检索式开放式医疗事实核查的失效模式,证明其瓶颈源于范式根本局限,而非模型或检索器陈旧。
问题
背景
在高风险医疗问答中,基于检索的事实性评估(retrieve-then-verify)已成为主流:LLM 生成声明后,系统从权威医学语料库检索证据并验证一致性。
现有方法局限
现有工作用 F1 等聚合指标评估,但聚合分数掩盖了失败模式。若系统在某类声明上系统性失败,F1 无法揭示原因。传统 RAG 诊断需要 gold answers 或标注过的 gold evidence,而开放域生成任务中两者都不存在,导致无法对检索阶段和验证阶段分别归因。此外,现有检索评估多针对封闭式任务,对长文本、多声明、跨文档推理的开放场景缺乏细粒度诊断框架。
为什么难且重要
医疗事实核查要求透明和可审计,错误验证可能引发错误治疗建议。挑战在于:1) 证据空间巨大且非结构化;2) 验证器推理链长,涉及证据选择、声明分解、一致性判断等;3) 开放生成的自然语言表述多样。论文在 4 种检索器、6 种前沿验证器模型上的实验表明,增大模型规模、增加推理 effort、使用医学微调模型或扩展至权威网络源均无法消除错误,说明这些失败不是工程问题,而是 retrieve-then-verify 框架的根本局限。业界需要新的评估方法与架构。
行业类比
类似金融报告自动审计:仅看最终通过率无法发现系统是漏检关键数据还是误读条款,而两者需要截然不同的修复策略。
核心洞察
- 将失败错误细分为检索质量五维度与验证推理六步骤,揭示聚合指标掩盖的系统性缺陷。现有诊断方法依赖 gold 答案或标注证据,在开放域医疗事实核查中不可行;本研究通过自动诱导的分类法,首次在无 gold 数据条件下定位失败具体环节,为改进提供可操作的靶点。
- 提出基于 LLM-as-Judge 的自动模式诱导管道,大规模标注证据质量与推理错误。该方法不依赖人工标注的 ground truth,解决了开放式长文本医疗问答中证据相关性、充分性等维度难以量化的问题,使细粒度诊断可以在任意新的数据集上快速复制。
- 实证表明更好的检索器、更强的验证模型、测试时扩展与医学微调均无法消除这些失败模式。该发现挑战了通过 scaling 或领域适配即可解决事实性核查问题的普遍假设,证明 retrieve-then-verify 范式在开放式医疗环境中存在根本局限,需要探索新的评估框架。
方法
输入与数据
论文以 MedExpert 开放域医学问答数据集为主案例,辅以 SciFact、SciFact-Open、HealthVer、CovidFact 三个封闭域数据集。系统输入为 LLM 生成的声明-答案对、权威医学语料库、多种检索器与验证器。
关键模块
- 检索阶段:采用 4 种检索方法(包括稠密检索、稀疏检索、混合检索及医学微调检索器)从语料库中召回证据。
- 验证阶段:使用 6 种前沿验证器模型(如 GPT-4、Claude、医学微调 LLM 等)对声明进行事实核查。
- 自动模式归纳:核心创新在于 LLM-as-Judge 驱动的模式提取。先设计 种子代码本(seed codebook),涵盖检索质量与推理错误的初步类别;然后用 LLM 对证据质量打分、对验证器推理链进行逐步分类,从大规模样本中归纳出结构化错误分类。
输出
最终产出两个分类法:
- 检索质量五维分类:证据相关性、完整性、权威性等维度。
- 验证推理六步分类:从证据解析到最终判定各步骤的典型错误。
与同类方法差异
现有 RAG 诊断依赖金标准答案或标注证据,本方法在无金标准环境下仅靠自动模式归纳即可定位检索与验证的失败模式。
实验
实验设计
论文基于 MedExpert 开放域数据集与 SciFact、HealthVer、CovidFact 等封闭域数据集开展案例研究。通过自动模式归纳 pipeline,利用 LLM-as-Judge 对证据质量进行五维标注,并将验证器推理错误分解为六个连续步骤。压力测试覆盖 4 种检索方法与 6 个前沿验证器模型,包括医学微调检索器、权威网络来源扩展和 test-time scaling 配置。
关键发现
失败模式不能被模型规模、推理努力或医学微调所消除:
- Better retrievers can’t solve:现有微调医学检索器能力有限,检索质量五个维度均有系统性缺陷。
- Better search can’t solve:扩展至权威网络来源并未缓解证据缺失与不相关。
- Better verifiers can’t solve:验证器能力不随 benchmark 排名迁移,test-time scaling 未改善医学事实核查,医学微调仅带来有限提升。
这表明失败源于 retrieve-then-verify 范式在开放域医学场景的根本限制,而非过时系统的 artifact。
基线对比解读
与封闭域事实核查相比,开放域中证据基础的全面性、证据可识别性、以及证据与声明的对齐程度均显著下降。作者通过跨检索与验证器的消融实验,证明单独提升任一模块均无法突破瓶颈;这提示实际工程需要重新审视 pipeline 设计,例如引入交互式证据收集或更结构化的验证流程。
行业影响
落地场景
论文提出的失败模式分类法可直接嵌入医疗 AI 产品的事实核查 与 证据检索 模块。例如:
- 临床决策支持系统(CDSS):当 LLM 生成治疗建议时,先检索权威医学语料,再验证声明;利用本论文的 retrieval-stage 5 维质量标签,可实时标记证据是否相关、完整、可识别,避免错误证据引导。
- 医疗问答 / 患者教育平台:自动生成的回答需经过检索式验证,verifier 的 6 步推理错误分类可用于诊断“为什么验证失败”,而非只看最终 F1。
商业价值
对医疗 SaaS 或医院内部 AI 平台而言,幻觉导致的合规风险与人工复核成本极高。本文指出单纯换更大的检索器或验证器并不能解决问题,说明需要专门的医学领域检索质量监控 和 错误模式分析,而非盲目 scaling。将错误分类自动化后,团队可针对高频失败模式(如证据不可识别、验证推理跳步)定向优化 prompt 或索引,减少人工标注 gold evidence 的依赖,从而降低运维成本,加快产品迭代。
与现有工作流集成
该自动模式归纳 pipeline 可作为 RAG 评估层 接入现有 stack:
- 在检索后、生成前,挂载
LLM-as-Judge对召回证据打质量标签,形成检索质量 dashboard。 - 在验证阶段,对 verifier 输出进行 6 步错误分类,持续监控模型行为。
- 两者可作为 CI/CD 中的回归测试:每次更换检索器或 verifier 时,自动运行并对比错误分布,而不仅是 F1。
典型 use case:一家远程医疗平台部署的医学问答机器人,在调用检索验证 API 后,利用本论文的分类器输出错误类型并触发人工复审或证据补充流程;一家医疗 AI 公司开发病历质控工具,在生成质控意见时,用该框架区分“检索未命中关键指南”与“验证器推理错误”,从而分别优化检索索引与提示词。
局限
- - 论文依赖 **LLM-as-Judge** 自动标注证据质量和推理错误,但未提供充分的人工验证证据来校准标注噪声。医学事实核查对标注精度要求极高,LLM 标注可能引入系统性偏差,尤其在区分“忽略证据”和“错误推理”等细粒度类别时。自动模式归纳得到的 codebook 也可能受限于所用种子标注的规模和多样性,泛化到其他 LLM 或检索器时可能失效,尽管作者进行了跨模型压力测试,但标注本身的可靠性仍是一个未充分解决的隐患。
- - 案例研究主要基于 **MedExpert** 开放域和三个封闭域医学数据集,结论的领域泛化性存疑。医学领域具有高度专业性和证据权威性要求,开放式长答案的失败模式可能与其他领域(如通用 QA、法律、金融)不同。虽然作者声称揭示 retrieve-then-verify 范式的基本限制,但仅医学领域证据不足以支撑这一强论断。另外,数据集中问题类型和规模可能有限,无法覆盖所有临床场景。对比同类工作:已有 RAG 诊断多聚焦通用领域或封闭域,本文未与其他领域失败分析进行系统对比,削弱了“基本限制”的普遍性。
- - 该工作定位为诊断性研究,并未提出任何改进方案或可操作的缓解策略。作者展示了扩大模型规模、增加推理 effort、医学微调等均不能解决失败模式,但未探索例如检索增强生成架构调整、多证据融合、或者将分类法嵌入训练目标等方法。对于工程实践而言,知道“哪里错了”固然重要,但缺少“怎么修”的路径会降低即时应用价值。相比之下,一些近期工作开始在失败分析基础上设计针对性训练或推理策略,本文停留在 taxonomy 和 stress-test 层面,后续改进仍需大量工作。