用 160,000 次训练的经验为你的策略学习提速
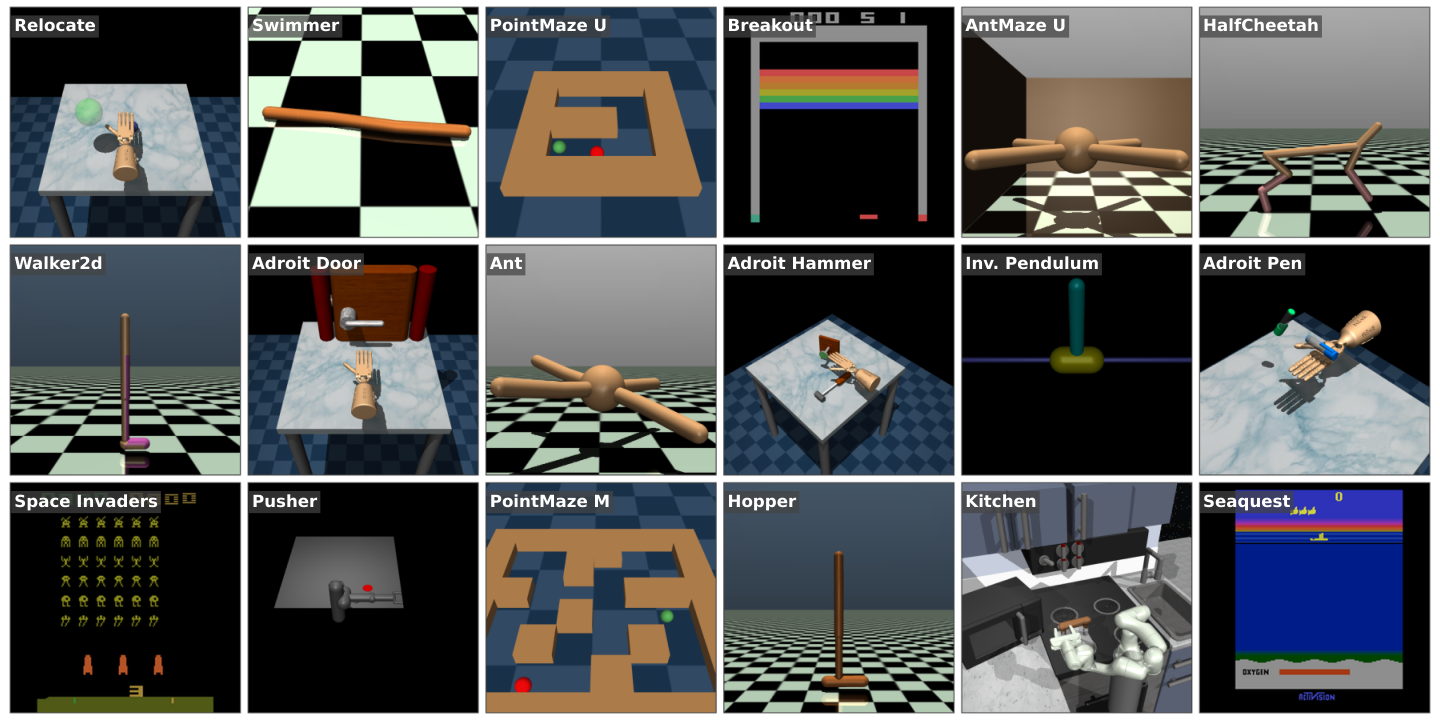
离线策略学习的可靠进展依赖于规范报告、调优良好的基线 以及多样化条件下的评估。已有工作表明结果对报告选择、超参数调优和数据集属性都很敏感,但尚无研究在足够规模上系统考察这些变异来源如何共同塑造结论。 为填补这一空白,我们开展了一项大规模实证研究,覆盖离线强化学习 与模仿学习,在 114 个数据集 上训练了超过 160,000 个策略。在此规模下没有算法能全面胜出:最强方法之间的总体性能往往接近,但领先者在不同环境中差异显著。我们发现,恰当的超参数调优 常常会重塑算法排名认知,而基准组成 也可能导致相互矛盾的结论。 我们还研究了超参数敏感性 及其跨环境迁移,并提出一种推导强默认配置的简单策略。基于这些发现,我们开发了一个以数据集为条件的推荐器,为实践者提供任务相关的算法建议。 最后,我们发布 JumpStart:一套资源合集,包含全部训练策略、逐模型分数与超参数、覆盖所有环境的强基线、训练与评估代码,以及一个可扩展网站,用于检索、分析并贡献结果。这些资源旨在让离线策略学习研究更可靠,并支持超出本研究范围的后续工作。
论文精读
TL;DR **160,000 个策略**、114 数据集的大规模实证揭示:离线 RL 无单一霸主,**调参与基准构成**会颠覆排名;开源 JumpStart 资源与推荐系统,提升研究可靠性。
问题
问题背景
离线策略学习(offline RL / imitation learning)允许从固定数据集训练策略,避免在线交互的成本与风险,成为机器人、推荐等场景的关键技术路径。但社区对评估可靠性的关注日益上升:算法排名是否可信?结论能否跨环境泛化?
现有方法局限
以往研究通常在小规模基准上比较算法,主要问题包括:
- 超参调优不一致:基线未经充分搜索,导致排名偏差;
- 种子方差被忽视:单次运行结果具有偶然性;
- 基准组成偏差:数据集数量、环境分布、专家来源不同,可能产生冲突结论;
- 缺乏系统联合分析:鲜有工作同时量化这些变异来源对最终结论的影响,导致“哪个算法更好”难以定论。
为什么难/重要
这项挑战的关键在于规模与协议:要可靠地揭示上述效应,需要统一训练协议下进行数十万次策略训练(本文 160,000+ 策略 / 114 数据集),计算成本极高。同时,算法性能在不同环境间差异显著,没有全局最优算法;超参敏感性与跨环境迁移性进一步放大不确定性。对业界而言,选型时依赖排行榜可能被误导,因此需要可靠基准、可复现资源和任务特定推荐。
行业类比
类似大模型评测中,提示模板或评测集构成变化会导致排行榜名次剧烈波动,自动化机器学习(AutoML)社区也强调超参搜索协议对公平比较的重要性。
核心洞察
- 离线策略学习中的算法优势高度依赖数据集和超参数配置,单一基准无法给出可靠结论。本研究通过 160,000 次训练覆盖 114 个数据集,证明没有任何算法在所有条件下占据主导,且“最优”方法随环境变化显著不同。这不同于以往基于少数数据集和固定超参的对比研究,凸显了评估基准多样化与条件化分析的必要性,否则算法进步可能是特定条件下的伪提升。
- 超参数调优不仅提升性能,还会改变算法相对排名,默认超参下公平比较的假设可能不成立。论文发现适当调优经常重排感知的算法排名,这意味着许多已发表结果可能因调优预算不平衡而失真。这种在离线强化学习领域首次大规模系统化的证据,对研究者设计实验、解读基线和报告敏感性有直接警示作用,应要求同等调优预算并公开超参配置。
- 本研究将大规模实验结果产品化为 JumpStart 资源套件,包含全部训练策略、逐模型评分与超参、强基线、代码和可扩展网站,并提供 dataset-conditioned 推荐系统。与仅发布代码或少量精选模型的工作不同,该资源可直接支持从业者根据数据集特征选择算法,降低试错成本,也为后续基准构建、分析和贡献结果提供了基础设施。
方法
输入
研究以 114 个离线数据集 为输入,覆盖 离线强化学习(ORL) 和 模仿学习(IL) 任务。每个数据集包含固定行为策略产生的轨迹,并配套训练/评估代码。同时输入一组代表性算法(如 CQL / IQL / TD3+BC / BC 等)及其超参数搜索空间。
关键模块
- 大规模训练与调优:对每个数据集运行多个算法,执行系统性超参数调优和多种子重复,共产生 160,000+ 训练策略。训练过程统一日志记录分数与配置。
- 评估敏感性分析:研究调优预算、种子方差、基准组成(数据集数量与来源选择)对算法排名的影响,量化结论可复现性。
- 超参数敏感性与默认配置推导:分析各算法对超参数的敏感度,识别跨环境稳健的默认超参数组合,并评估 跨专家源迁移 的泛化表现。
- 数据集条件推荐器:基于训练元数据构建推荐系统,输入新数据集特征,输出适合的算法推荐。
输出
最终产出 JumpStart 资源套件:包含所有已训练策略、逐模型分数与超参数、所有环境的强基线、训练评估代码,以及可扩展的检索分析网站。同时提供数据集条件推荐器,供从业者直接使用。
与同类方法差异点:此前研究多单独分析某一变异来源(如超参数或基准构成),本研究首次在 16 万训练规模上联合检验多个变异来源对离线策略学习结论的复合影响。
实验
实验设计
这项工作对离线强化学习与模仿学习进行了大规模实证研究,训练 160,000+ 策略,覆盖 114 个数据集。实验系统解耦了三个核心变量:调节预算与种子方差、数据集与环境构成(包括基准规模、组成、专家来源迁移)、评估协议与排行榜交互。
关键发现
- 无主导算法:最强方法之间的聚合性能接近,但领先者随环境大幅变化。
- 调节重塑排名:充分的超参数调节经常改变感知上的算法排名。
- 基准构成冲突:不同基准组合可产生相互矛盾的结论。
- 默认配置策略:通过超参数敏感性与跨环境迁移分析,识别出推导强默认配置的简单策略。
- 数据集条件推荐:基于大规模实验结果,构建了为实践者提供任务特定算法推荐的数据集条件推荐系统。
基线对比解读
与以往仅关注单一算法或小规模基线的研究不同,这项工作首次将报告选择、超参数调节和数据集属性三个变异性来源放在同一尺度下系统考察。结果表明,既有排行榜的结论对调节预算和基准组成高度敏感,提示研究者必须报告调节成本与种子方差,并以多环境聚合结果作为稳健结论的基础。发布的 JumpStart 资源套件(包含全部训练策略、逐模型分数与超参数、代码与网站)提供了可复现的评估基础设施,使后续工作能超越本研究范围进行更可靠对比。
行业影响
落地场景
离线强化学习(Offline RL)与模仿学习可直接用于:
- 电商推荐/广告排序:从历史交互日志离线学习策略,避免在线探索风险;利用 JumpStart 的 114 个数据集 与预训练策略快速验证选型。
- 医疗辅助决策:基于电子病历数据学习个性化治疗方案,算法稳定性与调参指导至关重要。
商业价值
- 降本:工程团队无需从零开展大规模算法对比,160,000 次训练运行与开箱即用的调参建议可显著减少 GPU 算力与人力投入。
- 提质:研究发现
hyperparameter tuning会改变算法排名,JumpStart 的 dataset-conditioned recommender 可针对特定数据分布推荐最优算法,减少线下评估与线上效果的偏差。
跟现有产品/工作流的接口
- JumpStart 提供完整的 training/evaluation code、model weights 与 hyperparameters,可集成到现有 ML pipeline(如 MLflow、Kubeflow)作为离线策略学习候选组件。
- 推荐系统可直接将 JumpStart 的算法推荐接口嵌入离线评估阶段,自动输出算法及超参配置,无需额外开发。
局限
- 论文作者在讨论中承认,实验主要基于 **D4RL** 等标准离线强化学习基准,共 114 个数据集,算法覆盖范围也可能未能包括所有最新方法。真实应用中的部分可观测性、高维连续控制、奖励稀疏或噪声等问题未被充分评估。因此,结论在不同数据分布和任务特性下的外推性需要谨慎对待。
- 从实验设计推断,**超参数调优** 本身可能引入偏差:作者使用了特定的调优预算和搜索空间,不同搜索策略可能导致不同排名。默认配置的迁移性仅在当前基准内验证,未见其在完全新环境中的泛化测试。**推荐系统** 基于离线指标训练,实际部署时若数据集分布偏移或指标选择变化,推荐效果可能下降。此外,资源套件需持续维护,否则会随时间过时。
- 与已有的大规模基准如 **RL Unplugged**、**D4RL** 及后续的离线 RL 评估工作相比,本文并未提出新的离线学习算法或理论框架,核心贡献在于系统性地整合和扩展经验分析。其推荐系统相对简单,主要依赖数据集特征和算法性能的统计关联,未使用复杂的元学习方法,泛化能力可能受限。