EngramEdit: 通过条件记忆实现 LLM 中的解耦知识更新
条件记忆 架构(如 DeepSeek Engram)利用输入 n-gram 检索已学嵌入,以有限的额外计算扩展大语言模型的容量。除模型缩放外,该架构还展现出将事实知识存储与通用计算解耦的潜力,为在保持 Transformer 主干固定的前提下更新事实知识提供了可行路径。 然而实现这一潜力并不容易:同一事实的不同表述可能激活不同的 n-gram 嵌入,而更新共享嵌入又会无意间改变模型对其他事实的预测。为此,作者提出 EngramEdit:先计算目标记忆表示,使模型在多种表述下都预测更新后的事实;再联合更新共享 n-gram 嵌入,让它们在多种表述与多次编辑中匹配这些目标,并对频繁复用的嵌入施加更强惩罚,以保护无关知识。 实验表明,EngramEdit 能通过条件记忆实现独立的事实知识更新,编辑成功率近乎完美。更新后的知识可迁移到未见表述并支持多跳推理,在 CoT 提示下准确率约为最强基线的三倍;即使事实更新持续累积,无关知识与通用能力也基本得以保留。这些结果表明,EngramEdit 将条件记忆转化为可编辑的知识接口,使其作用超越模型缩放,支持解耦式知识更新。
论文精读
TL;DR EngramEdit 将条件记忆架构变为可编辑知识接口:通过多表达式目标联合更新 n-gram 嵌入并惩罚高频重用嵌入,在不损伤无关知识下实现近乎完美的事实更新,多跳推理准确率提升至最强基线的近三倍。
问题
问题背景
LLM 知识编辑领域专注于在不重新训练整体模型的前提下,精准更新特定事实知识,同时保持模型通用能力与无关知识不受影响。
现有方法局限
- Locate-then-edit 类方法(如 ROME、MEMIT)直接修改 Transformer 参数,虽然编辑成功率较高,但存在灾难性遗忘风险,且对同一事实的不同表达泛化不足——编辑“法国首都是巴黎”后,模型可能仍无法正确回答“法国的首都叫什么?”。
- 基于 conditional memory 的架构(如 DeepSeek Engram)通过 n-gram 查表存储事实,初步实现了存储与计算的解耦。然而,同一事实的多种表达可能激活不同的 n-gram 嵌入,直接更新共享嵌入会意外改变模型对其他事实的预测。例如更新“现任美国总统”可能同时破坏对“前任美国总统”的记忆。
为什么这个问题难/重要
将事实知识从计算流程中解耦,是实现可编辑、可维护 LLM 的关键路径。难点在于同时满足四个条件:编辑成功率高、跨表达泛化、无关知识保留、多跳推理一致性。例如更新“某位公众人物的现任职务”需要保证所有问法都给出新答案,且不会破坏与该人物相关的其他事实(如出生地、配偶等)。业界对模型持续更新、纠错、个性化有明显需求,任何编辑方法都必须在低副作用与高泛化之间取得平衡。
行业类比
类似于数据库系统中对单条记录执行 UPDATE 操作,不应触发全表锁或导致其他记录损坏;EngramEdit 试图为 conditional memory 提供具备事务性的更新能力。
核心洞察
- EngramEdit 将条件记忆中的知识编辑重新定义为多表达式下的联合约束优化问题。与单点嵌入修改或微调特定 token 的方法不同,它先计算能令模型在多种表达下预测正确事实的目标记忆表示,再反向求解共享 n-gram 嵌入的更新量,从而保证同一事实的不同表达在编辑后一致激活更新后的知识。这一思路把编辑从'改哪几个参数'升级为'如何分配记忆更新以满足全局一致性',对工程实践的启示是需要构建记忆映射层与更新求解器,而非依赖启发式的局部替换。
- 重用感知正则化是 EngramEdit 实现连续编辑不遗忘的关键机制。它根据嵌入被多少表达复用分配惩罚权重,高频共享嵌入更新幅度更小,迫使求解器将编辑信息优先写入低频或专用嵌入中。这与 FT-L、AdaLoRA 等直接修改 Transformer 参数的方法形成鲜明差异:参数编辑会扰动通用计算,而 EngramEdit 的参数完全冻结,仅调整条件记忆,天然隔离了知识存储与推理能力。实际部署时,这种方法无需保存旧参数快照或回滚机制,更适应长期、大批量知识更新场景。
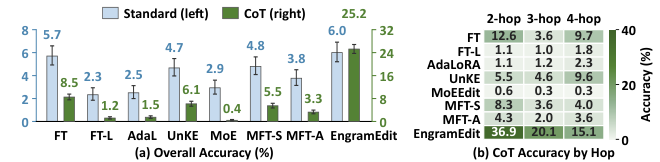
- 实验证明条件记忆可以成为可编辑的知识接口,而不仅是扩展容量的手段。EngramEdit 在未见表达上接近完美编辑成功,多跳推理中 CoT 准确率达到最强基线的近三倍,说明编辑后的知识能参与复杂推理而非死记硬背。对技术决策者而言,这为 LLM 知识维护提供了一种架构级方案:选择或设计 Engram 类条件记忆底座,配合专用的编辑求解器,可在不牺牲通用能力的前提下实现高频、解耦的事实更新,比事后修补参数或依赖外部知识库更高效。
方法
输入与目标
- 输入:待更新事实(主语-关系-对象三元组)、原始 LLM(含条件记忆模块,如 DeepSeek Engram 的 n-gram 嵌入)、冻结的 Transformer 主干。
- 目标:更新条件记忆中的嵌入,使模型能对新事实的多种表达给出正确回答,同时保持无关知识不变。
关键模块
- 条件记忆目标计算:针对同一事实生成多种表达(如改写问题),对每个表达,通过优化目标记忆表示,使模型预测出更新后的正确对象。联合考虑多个表达,得到稳定的目标记忆向量。
- 多表达式记忆映射:将目标记忆表示映射到实际可更新的 n-gram 嵌入空间,构建映射矩阵,关联表达中的 n-gram 与需要调整的嵌入。
- 联合记忆更新分配:求解一个联合更新问题,使所有表达和多个编辑事实共享的 n-gram 嵌入同时匹配各自目标。引入基于重用的正则化:对频繁使用的嵌入施加更大惩罚,避免破坏常用知识的表示。通过闭式解或优化得到嵌入更新量,并应用到条件记忆。
输出
- 更新后的条件记忆嵌入(n-gram embeddings),Transformer 参数保持不变。
- 模型可在未见过的表达和多跳推理中利用更新后的记忆。
作者指出:该架构具备将事实知识与通用计算解耦的潜力,EngramEdit 则将条件记忆转化为可编辑的知识接口。
与同类方法的差异:不同于 locate-then-edit 类方法直接修改 MLP 或注意力参数,EngramEdit 仅在外部条件记忆中更新 n-gram 嵌入,不改动主干,并通过多表达式联合与重用正则化缓解知识冲突。
实验
实验设计
实验在 CounterFact、ZsRE 和 MQuAKE 三个知识编辑基准上评估 EngramEdit,同时覆盖通用能力任务以检测副作用。编辑流程包括:生成多样表达式、联合计算目标记忆表征、多表达式记忆映射,以及带 reuse-based 正则化的联合更新。对比基线包括 FT、FT-L、AdaLoRA、UnKE、MoEEdit、Memory-FT (Subject) 和 Memory-FT (All Tokens),评估指标涵盖编辑成功率、泛化性、特异性、多跳推理及通用能力保持。
关键发现
- 编辑成功:EngramEdit 在多个基准上实现近乎完美的编辑成功率,连续编辑 5000 个事实后性能稳定。
- 泛化与推理:修订知识可迁移到未见表达,在 multi-hop 推理中,CoT 提示下的准确率约为最强基线的 3 倍。
- 知识保持:无关事实和通用能力在大量编辑后基本无损,表明条件记忆更新未干扰 Transformer 主干的通用计算。
与基线对比
直接微调(FT/FT-L)或参数高效微调(AdaLoRA)会全局改变模型参数,容易造成灾难性遗忘;Memory-FT 虽然直接更新记忆,但缺少跨表达式一致性约束,易产生冲突更新。EngramEdit 通过多表达式联合目标和 reuse-based 正则化,在共享 n-gram 嵌入上分配最小代价更新,既保证了编辑事实的多种表达均被覆盖,又避免了对高频复用嵌入的过度修改,从而在编辑精度与知识保持之间取得显著优势。
行业影响
落地场景
- 企业知识库与客服系统:产品、政策、价格等事实频繁变更,EngramEdit 可即时注入新知识,无需重训模型。
- 医疗与金融合规助手:药品剂量、法规条款等关键信息更新后,模型可快速修正,降低错误输出风险。
- 内容平台事实核查:新闻、百科类应用可针对具体错误事实进行定点编辑,避免全量微调带来的算力浪费。
商业价值
- 降本:编辑单条事实仅需前向计算与小规模优化,GPU 时成本远低于全量微调,且无需维护多版本模型。
- 增效:事实更新延迟从周级降至分钟级,提升用户信任与留存;同时保留通用能力,减少回归测试投入。
- 风险控制:解耦更新降低无关知识被意外修改的概率,减少模型漂移带来的合规与声誉风险。
集成接口
- 作为推理服务插件:在 LLM 推理引擎旁挂载条件记忆存储,提供
update_factAPI 更新 n-gram 嵌入,Transformer 权重保持不变。 - 与 RAG 协同:EngramEdit 负责长期事实修正,RAG 提供实时上下文,两者互补可覆盖更多知识时效性场景。
- 纳入 MLOps 流程:编辑操作可版本化、审计,与模型 registry、CI/CD 管道对接,满足企业治理要求。
局限
- **泛化性受限于条件记忆架构**。EngramEdit 在 DeepSeek Engram 这类使用 n-gram 嵌入的模型上验证,但主流 LLM 仍以标准 Transformer 为主,直接应用需要模型预先采用条件记忆设计,否则无法使用。作者也承认该架构并非普遍存在,因此编辑能力难以迁移到其他模型。此外,实验仅在 CounterFact、ZsRE、MQuAKE 等有限数据集上评估,缺乏对更复杂开放域事实或长尾知识的测试,实际部署时可能面临未覆盖的表达形式。
- **更新共享 n-gram 嵌入仍可能引入知识冲突**。虽然通过对高频重用嵌入施加更强惩罚来保护无关知识,但当不同事实共享相同的 n-gram 模式时,精确匹配多个编辑目标会不可避免地扰动其他事实的表示。论文的 reuse-based regularization 只能缓解而非消除冲突,在大量累积编辑(如 5000 事实)下,虽然报告了能力保留,但可能隐藏了细微的语义漂移。此外,该方法需要生成多种表达式并计算联合目标,计算开销显著高于单表达式编辑,可能影响在线编辑的实时性。
- **与参数编辑方法(如 MEMIT、ROME)相比,EngramEdit 的编辑范围局限于条件记忆模块**,无法修正模型主干中已固化的知识。如果事实知识部分存储在 Transformer 的 MLP 或注意力层中,仅更新外部记忆可能无法完全覆盖,导致编辑成功但推理时仍可能调用旧知识。此外,n-gram 查找机制依赖于输入的表面形式,对于同义改写或跨语言表达,如果未在训练时见过对应 n-gram,编辑可能失效,这限制了其在多语言和复杂 paraphrase 场景下的鲁棒性。