RunningTab: 以环境侧标签页实现直接工作区交互
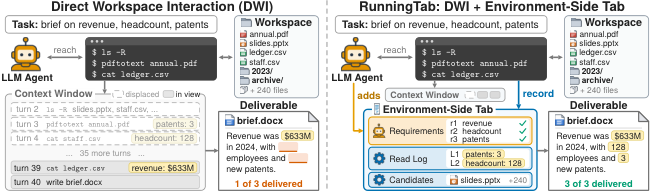
许多知识工作都要从工作区已有的文件中产出新的交付物,而 LLM agents 正开始接手这类工作。借助直接语料交互,agent 可以在终端中无需索引地搜索并读取这些文件;以这种方式从大量文件产出交付物,即我们所说的 direct workspace interaction(DWI)。 然而,触及文件只是任务的一半:没有任何机制追踪任务要求什么、已读了什么、以及被列出却从未打开的文件。这些信息在 context window 中溜走且不留痕迹,于是 agent 可能已经提取了某个数字,最终却在报告里遗漏它。 为此,我们提出 RunningTab —— 一个为直接工作区交互配备 环境侧标签页 的框架:它是由环境与 agent 并行维护的、记录任务尚欠事项的 per-task 记录。具体而言: - agent 写入自己的要求; - 环境 把每个被读取的文件记为带来源(provenance)的摘录,把每个列出但未打开的文件记为候选; - agent 可在每条要求旁看到最匹配的摘录与排名靠前的未打开候选,据此用匹配内容解决该要求,或给出理由将其搁置; - 若在仍有未完成要求时试图收尾,会在 finish check 中收到这些要求。 我们在三个 benchmark 上以三个 LLM 验证 RunningTab:它一致优于 plain DWI 以及把记录保存在模型内部的 baselines,而其标签页通常只要被看到,就能保住交付物所需的值。
论文精读
TL;DR RunningTab 为 LLM 代理的直接工作区交互引入环境侧标签,记录任务要求、已读文件摘要与未打开候选,防止交付遗漏,在多个基准上持续优于普通方法和基线。
问题
问题背景
LLM agent 正逐步接手基于工作区已有文件生成新交付物的知识工作。直接工作区交互(DWI) 允许 agent 通过终端无索引地搜索和读取任意文件,无需预先构建语料库。
现有方法局限
- 缺乏任务级持久记录:任务要求、已读文件内容、列出但未打开的文件都只存在于 agent 的上下文窗口中,没有结构化追踪,容易随上下文滚动而丢失。
- 模型内记忆不可靠:基线方法尝试让模型自己维护记录,但受限于上下文长度和注意力机制,agent 常遗忘已读内容或未打开的候选文件,导致提取了图表却未纳入最终报告等遗漏。
- 无 provenance 核对机制:无法将每个任务要求与具体文件内容或候选文件关联,完成时也无法自动检查是否有未解决的要求。
为什么这个问题难/重要
- 技术挑战:需要在环境侧维护一个可查询、可更新的任务状态结构,并与 agent 的读取、列举、完成动作实时联动;同时要平衡记录开销与上下文占用。
- 业界关注:多文件知识工作自动化是 LLM agent 落地的核心场景,交付物遗漏会直接导致任务失败,可靠的任务跟踪机制是提升 agent 工作质量的关键。
行业类比
类似软件工程中 issue tracker 的验收标准跟踪:每个需求必须有关联证据或明确的放弃理由,否则任务不能关闭,LLM agent 处理多文件任务也需要同样的外部 checklist 保障交付完整性。
核心洞察
- RunningTab 的核心创新是将代理的任务追踪状态从模型上下文转移到环境侧,形成随任务更新的 tab 记录。与依赖模型内部记忆或上下文窗口的 baseline 相比,该设计不受上下文长度限制,记录持久且可审计,避免了‘读了但没写进交付物’的典型失误。
- 通过显式记录每个已读文件的摘要和未打开候选,并与任务要求进行证据匹配,RunningTab 实现了‘读到即追踪’的闭环。这与普通 DWI 依赖代理自发记忆的做法不同,它能在代理试图交付时触发 finish check,强制处理仍开放的要求,从而显著提升交付内容的完整性。
方法
输入与任务建模
在 Direct Workspace Interaction(DWI) 场景下, agent 面对一个包含多文件的 workspace, 通过终端命令(如 grep / cat)直接搜索和读取文件, 无需索引。任务要求生成一份 deliverable(如报告、表格), 但传统 DWI 缺少对任务需求、已读内容和未打开文件的显式追踪, 导致 agent 可能遗漏关键信息。
关键模块: Environment-Side Tab
RunningTab 的核心是在环境侧维护一个 per-task tab, 与 agent 上下文分离。该 tab 包含三类信息:
- Requirements: agent 将任务拆解为具体需求项, 主动添加到 tab 中。
- Excerpts with provenance: 环境自动记录 agent 每次读取的文件内容摘要(或关键片段), 并附带来源路径。
- Unopened candidates: agent 列出但未打开的文件, 作为候选保留。
操作流程
- Stating requirements: 任务开始时, agent 向 tab 添加需求列表。
- Capturing reads and listings: 环境自动捕获文件读取和目录列表行为, 更新 tab。
- Reporting state: agent 可随时查询 tab, 看到每个需求旁的最佳匹配 excerpts 和排名靠前的 unopened candidates。
- Reviewing requirements: 交付前, agent 逐一审查需求: 若找到匹配内容则标记为 resolved; 若无法满足, 则 set aside 并说明理由。
- Finish check: 如果 agent 尝试结束任务但仍有未解决需求, 环境触发检查, 将这些需求重新呈现给 agent, 强制处理。
输出与效果
最终交付物基于已解决的 requirements 生成, 且每个关键结论都有对应的文件摘录支持。与在模型上下文内维护任务状态的方法(如 ReAct、Reflexion)相比, RunningTab 将任务记录外置到环境侧, 避免上下文窗口中的信息丢失, 同时通过环境自动记录文件访问证据, 减轻 agent 的记忆负担, 提高长任务中信息覆盖的完整性。
实验
实验设计
论文在 三个基准 上评测 RunningTab,覆盖三个 LLM,对比对象包括 plain DWI(直接工作区交互无记录)以及将记录保留在模型上下文中的基线。评测核心是代理能否在交付前正确追踪任务要求、已读文件摘录与未打开候选,避免遗漏已提取内容。
关键发现
RunningTab 在三个基准上一致优于 plain DWI 和模型内记忆基线。其环境侧 tab 能有效保存“已显示但最终缺失”的内容:当代理读到某个数值或图表却未写入报告时,finish check 会拦截未解决的需求。定性分析显示 tab 中通常保留交付物所需的值,即“一旦看到就不会丢”。
与基线对比的深度解读
与模型内保持记录相比,环境侧 tab 不占用上下文窗口,且可跨步骤持久化;模型内记忆容易随长上下文漂移或遗忘。这一设计对工程实践的启示是:将任务状态外置到环境,可减轻 LLM 的记忆负担,提升长任务可靠性。
行业影响
落地场景
RunningTab 适合文件密集型知识工作自动化:LLM agent 需要从既有 workspace 中搜索、阅读多个文件并产出 deliverable 的场景,如企业合同审查、金融尽调报告、法律研究、医疗记录汇总、代码库审计。产品形态上,可嵌入现有 AI 助手或 agent 工作流,作为“任务清单 + 证据追踪”层。
商业价值
- 降本:减少 agent 因遗漏关键文件而返回重做,降低 token 与人工复核成本。
- 提效:finish check 在交付前拦截未解决需求,缩短迭代轮次。
- 信任与合规:环境侧 tab 保留每个 deliverable 的来源摘录与候选未读文件,提供可审计痕迹,适合受监管行业。
与现有产品/工作流集成
RunningTab 是轻量框架,不替代 agent 的检索或推理,而是在环境侧增加状态记录。可集成到 LangChain / AutoGen / 私有 RAG 流水线中,作为文件访问层的 wrapper,或作为可观测性组件记录 agent 的文件读取行为。对已有 DWI 或检索工具,只需在文件读取、列表操作时触发 tab 更新。
具体 use case:
- 金融尽调:agent 扫描数百份合同、财务报表、邮件,生成投资备忘录。RunningTab 确保每个结论都有来源摘录,未打开的关联文件在 finish check 中被标记,避免风险点缺失。
- 企业合同审查:agent 从多份合同中提取条款并对比。tab 记录每个条款对应的原文,支持快速人工复核,降低法律风险。
局限
- **可扩展性与上下文开销**:RunningTab 将每个文件的摘录和候选列表保存在环境端 tab 中,当任务涉及大量文件时,tab 的内容会线性增长,可能挤占有限的上下文窗口,并导致 agent 在匹配需求与摘录时注意力分散。论文在实验中未讨论大规模工作区(例如数百个文件)下的性能退化,且 tab 的存储与检索机制本身也会引入额外的推理延迟。
- **依赖 agent 主动声明需求**:框架要求 agent 在任务开始时明确添加 requirements,若 agent 未能准确、完整地表达需求(例如需求隐含在指令中或需动态调整),环境端记录就会缺失关键条目,导致后续的 finish check 无法捕获遗漏。该假设在开放式任务中可能不成立,且论文未分析需求声明错误对最终交付质量的影响。
- **匹配与解析能力相对简单**:RunningTab 使用“最佳匹配”将摘录与需求关联,但未采用更强的语义检索或重排序模型,对于多模态内容(如图表、表格)或需要推理才能建立关联的场景,简单的相似度匹配可能失败。此外,与更通用的 agent memory 框架(如 Reflexion、MemGPT)相比,RunningTab 专注于工作区文件,缺少跨任务记忆的泛化能力。