RoboQuest: 能够搜索、检查与测试的通用物理智能体
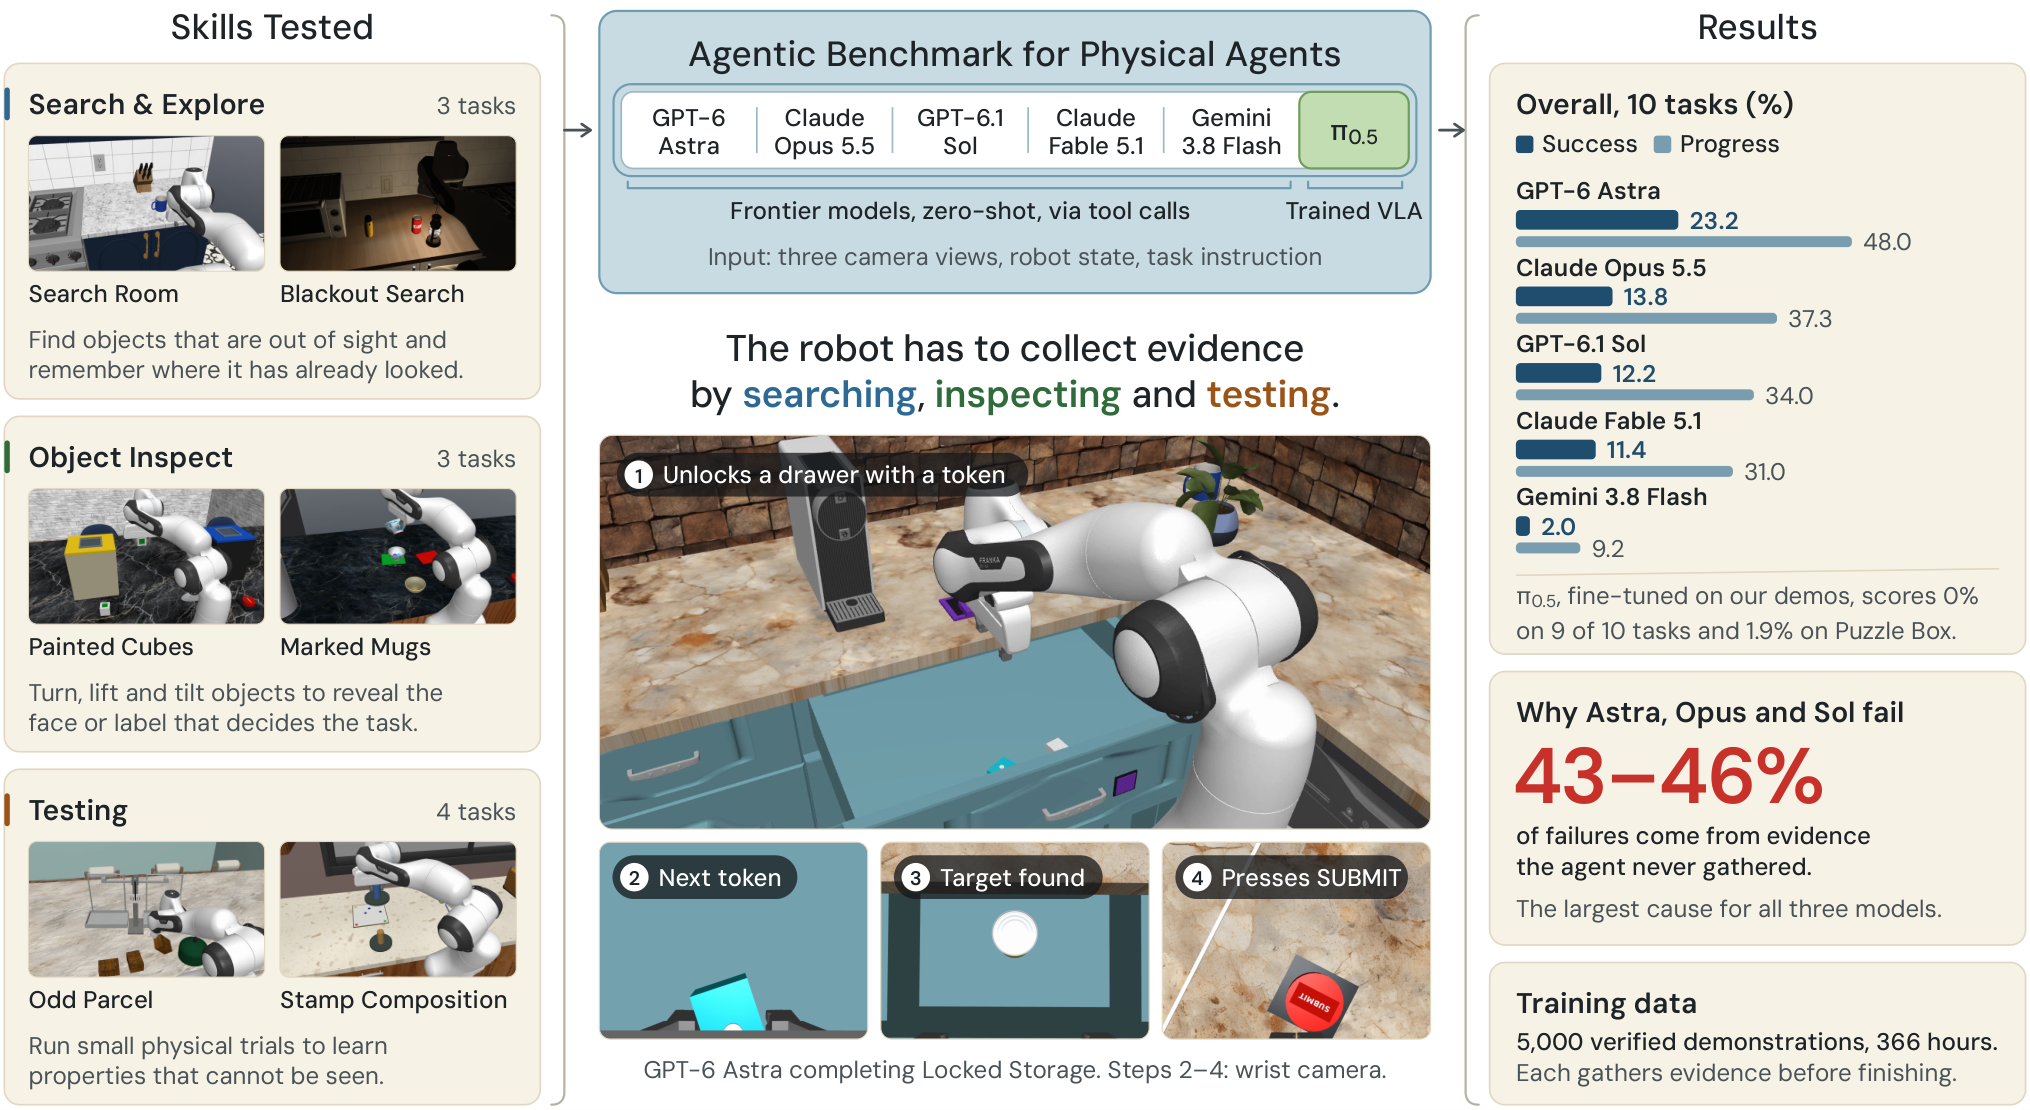
RoboQuest 是面向目标导向具身探索的基准。多模态基础模型虽已成为通用具身智能体,但身处陌生环境时,任务相关信息未必出现在观测中:智能体可能需要确定相关物体的位置、检查未观测到的属性,或探明陌生工具的效果。 该基准包含十项移动操作任务,聚焦三类不确定性:搜索、基于操作的检查与交互式测试。智能体必须通过物理交互主动获取任务信息,用所得证据调整后续动作,并自主决定何时提交任务完成。 我们通过统一的视觉运动接口评估了五个前沿多模态智能体,以及在我们发布的完整回合演示上微调的 π{0.5} 策略。最佳智能体仅在 23% 的回合中成功,微调策略几乎从未成功;在补充隐藏信息后对执行技能做独立测试,表明智能体其实能够完成大部分所需动作,失败分析中仅少数归因于执行。 分析还发现:智能体常在观察到完成任务所需证据之前就做出决策,过早停止探索;它们很少预防或修复探索造成的干扰;且对多数模型而言,试错学习仍然困难。
论文精读
TL;DR RoboQuest 基准要求智能体通过物理交互主动搜索、检查、测试来获取任务关键信息,结果显示最佳前沿模型成功率仅 23%,失败主因是探索过早终止而非执行能力,暴露了当前具身智能体在未知环境中的核心短板。
问题
问题背景 当前具身智能领域关注多模态基础模型作为通用物理智能体,在操作任务中展现广泛能力,RoboQuest 等新基准试图推动其从单纯执行向主动信息获取延伸。
现有方法局限 现有机器人操作基准大多假设任务相关信息已包含在观测中,或默认目标物体、属性、工具效果已知。当环境陌生、信息缺失时——例如物体被遮挡、属性需近距离接触才发现、工具效果需实际试用——传统指令跟随范式和模仿学习策略缺乏主动探索闭环。它们不会自主选择搜索、检查或测试动作来获取证据,而是直接基于不完整观测做决策。实验显示,五个前沿多模态智能体通过统一视觉运动接口在 RoboQuest 上最高成功率仅 23%,微调 π0.5 策略几乎不成功,且失败模式多为过早终止探索,而非动作执行错误。
为什么这个问题难/重要 主动探索要求智能体同时处理不确定性推理、探索与利用权衡、自主停止判断以及物理交互后果管理。这些能力直接决定智能体能否在非结构化、部分可观测的真实环境中长期自主工作,关系到仓储巡检、家庭服务、设备维护等场景的实用化。RoboQuest 围绕搜索、检查、测试三类不确定性设计任务,为系统评估和推动这些能力提供基准。
行业类比 类似对话式 AI 助手被要求调用外部工具或检索后再回答,而不是仅凭初始问题臆测——物理智能体同样需要“动手找证据”后再决策。
核心洞察
- 执行技能与探索策略存在显著解耦:RoboQuest 显示,当隐藏信息被直接提供时,前沿多模态 agent 能完成大部分底层动作,但完整任务中最佳成功率仅 23%。这与传统操作基准(预先给定目标位置或属性)形成关键差异——RoboQuest 要求 agent 通过物理交互主动获取任务相关信息,暴露了现有 VLA 在不确定性下的信息寻求与决策时机缺陷,而非单纯操作精度不足。
- 过早停止探索是首要失败模式:多数 agent 在未观察到完成所需的充分证据前就提交完成,且很少预防或修复自身探索动作造成的场景扰动。这指向当前多模态模型缺乏对“证据充分性”的显式建模,将任务完成视为单步分类而非连续证据累积过程。仅对全量演示做行为克隆(π0.5)几乎全部失败,说明模仿学习无法捕获探索策略,需要引入探索奖励或规划器来约束终止条件。
方法
RoboQuest 是一个面向物理智能体的 goal-directed embodied exploration 基准,其方法核心是构建要求主动信息获取的任务集合并提供统一评估协议。
输入
环境为仿真移动操作场景,每个任务提供一个自然语言目标(如“找到某个物品”),但初始观察可能缺少完成任务所需的关键信息(物品位置、物体属性、工具效果等)。智能体接收 RGB 视觉观察和任务指令。
关键模块
- 任务设计:围绕三种不确定性类型设计十个任务:
- 搜索:确定目标物体位置(如
Search Room) - 操纵检查:通过操作检查未观察属性(如
Marked Mugs) - 交互测试:通过使用工具发现其效果(如
Puzzle Box)
- 搜索:确定目标物体位置(如
- 评估接口:采用统一 visuomotor interface,将不同多模态模型(如 GPT-4V、Gemini 等)的输出映射为底层动作,保证公平比较。
- 演示数据集:收集完整 episode 的示范轨迹(10 个任务),用于微调
π0.5策略。 - 终止与度量:智能体自行决定何时提交任务完成;评估指标包括成功率、探索成本、任务进度等。
输出
智能体输出动作序列并最终提交完成决定;基准输出成功率、失败归因(如过早停止探索、执行错误、未修复场景干扰等)。
基准发现:最佳前沿模型仅 23% 成功率,微调
π0.5几乎全失败,表明主动探索与不确定性推理仍是主要瓶颈。
差异点:与现有机器人操作基准(如 CALVIN、RLBench)主要评估给定目标下的动作执行不同,RoboQuest 强调在信息不完整环境中通过物理交互主动获取证据,并要求智能体自主决定终止时机,更接近真实任务中的探索-利用权衡。
实验
实验设计
构建 RoboQuest 基准,包含 10 个移动操作任务,覆盖三类不确定性:搜索、基于操作的检查、交互式测试。评估 5 个前沿多模态 agent(经统一 visuomotor 接口)及一个在完整 episode 演示上微调的 π0.5 策略。另设执行技能隔离测试(提供隐藏信息),以分离探索与执行能力。
关键发现
- 最佳前沿 agent 成功率仅 23%,微调 π0.5 几乎从不成功。
- 隔离测试显示 agent 能执行大部分所需动作,执行失败仅占少数。
- 失败分析:主因是过早停止探索,未观测到任务完成所需证据就决策;很少防止或修复探索造成的干扰;试错学习仍困难。
与基线对比解读
前沿模型与微调策略的巨大差距表明,端到端微调难以捕获探索策略,可能因演示数据缺乏探索多样性或奖励稀疏。执行技能足够但探索不足,说明瓶颈在于主动信息获取 与不确定性下的决策,而非动作执行。该基准揭示现有 VLA 在目标导向探索上的短板,为后续研究提供明确改进方向。
行业影响
落地场景
RoboQuest 针对的目标导向式具身探索能力,可直接映射到仓储物流、家庭服务、工业巡检等真实机器人业务。例如:
- 电商仓库机器人:在货架遮挡、库存位置未知时,主动搜索目标商品;检查易碎品是否完好;测试包装工具(如胶带切割器)是否可用。
- 家庭服务机器人:进入陌生房间后,先探索寻找充电座或清洁工具,再通过交互判断地毯材质、液体污渍类型,最后决定清洁策略。
商业价值
当前多数具身智能产品依赖预设地图或人工标注信息,遇到未知环境会失败或低效。RoboQuest 揭示的过早停止探索、不修复自身干扰等失败模式,为改进算法提供了明确方向:
- 降本:减少机器人部署前的人工环境建模成本,让机器人自主适应新场景。
- 体验提升:家庭或服务机器人能主动获取完成任务所需信息,减少用户干预。
- 增收:仓储场景中,机器人自主搜索与检查可替代部分人工盘点,提高库存周转效率。
与现有工作流集成
RoboQuest 可作为评估基准直接嵌入机器人研发 CI 流程:
- 在仿真环境(如 Isaac Sim、Habitat)中运行同一套评测,对比不同 VLA 模型或策略的探索能力。
- 将任务拆解为搜索、检查、测试三个子能力模块,分别评测并定位瓶颈。
- 利用论文发布的演示数据集微调 π0.5 等 VLA 模型,作为探索策略的 base model。
与现有 VLA 基准(如 SIMPLER、LIBERO)相比,RoboQuest 强调 不确定性下的主动信息获取,填补了从“执行已知技能”到“自主决定何时获取证据”之间的空白。
建议在自研机器人系统的验证阶段引入 RoboQuest 评测,重点关注智能体是否在观察到必要证据后做出终止决定,以及是否具备修复自身干扰的能力。
局限
- 论文指出微调 π_{0.5} 策略几乎从不成功,试错学习困难,这反映当前 VLA 方法在需要长期主动探索的任务上缺乏有效的探索策略学习机制。基准的奖励信号可能过于稀疏,且成功标准严格(需自主决定何时完成任务),导致学习信号难以有效传递。此外,演示数据规模有限(论文未给出具体数量,但提到“full-episode demonstrations”),可能不足以覆盖探索策略的多样性,使得微调效果近似随机。
- 评估接口统一为视觉运动控制,可能掩盖了不同多模态模型在语言理解、规划或空间推理上的差异;前沿模型被迫通过低层动作交互,无法发挥其高层推理能力,导致性能低估。同时,执行技能隔离测试显示大多数动作可完成,但完整任务失败率高,表明瓶颈在探索决策而非动作执行,但基准未提供显式的元认知或置信度输出机制,难以分析模型是否正确感知不确定性或何时应当继续探索。
- 与现有具身操作基准(如 BEHAVIOR、ALFWorld 等)相比,RoboQuest 虽然引入了探索维度,但任务总数仅 10 个,场景规模和物体交互复杂度有限,主要针对桌面与小型房间环境,难以涵盖真实部署中的长周期、开放世界探索挑战。此外,任务设计中的不确定性类型(搜索、检查、测试)相对模式化,可能无法完全反映现实世界中信息获取的多样性和动态性,限制了基准的泛化评估能力。