QuadTok: 面向自回归图像生成的四叉树视觉 Tokenizer
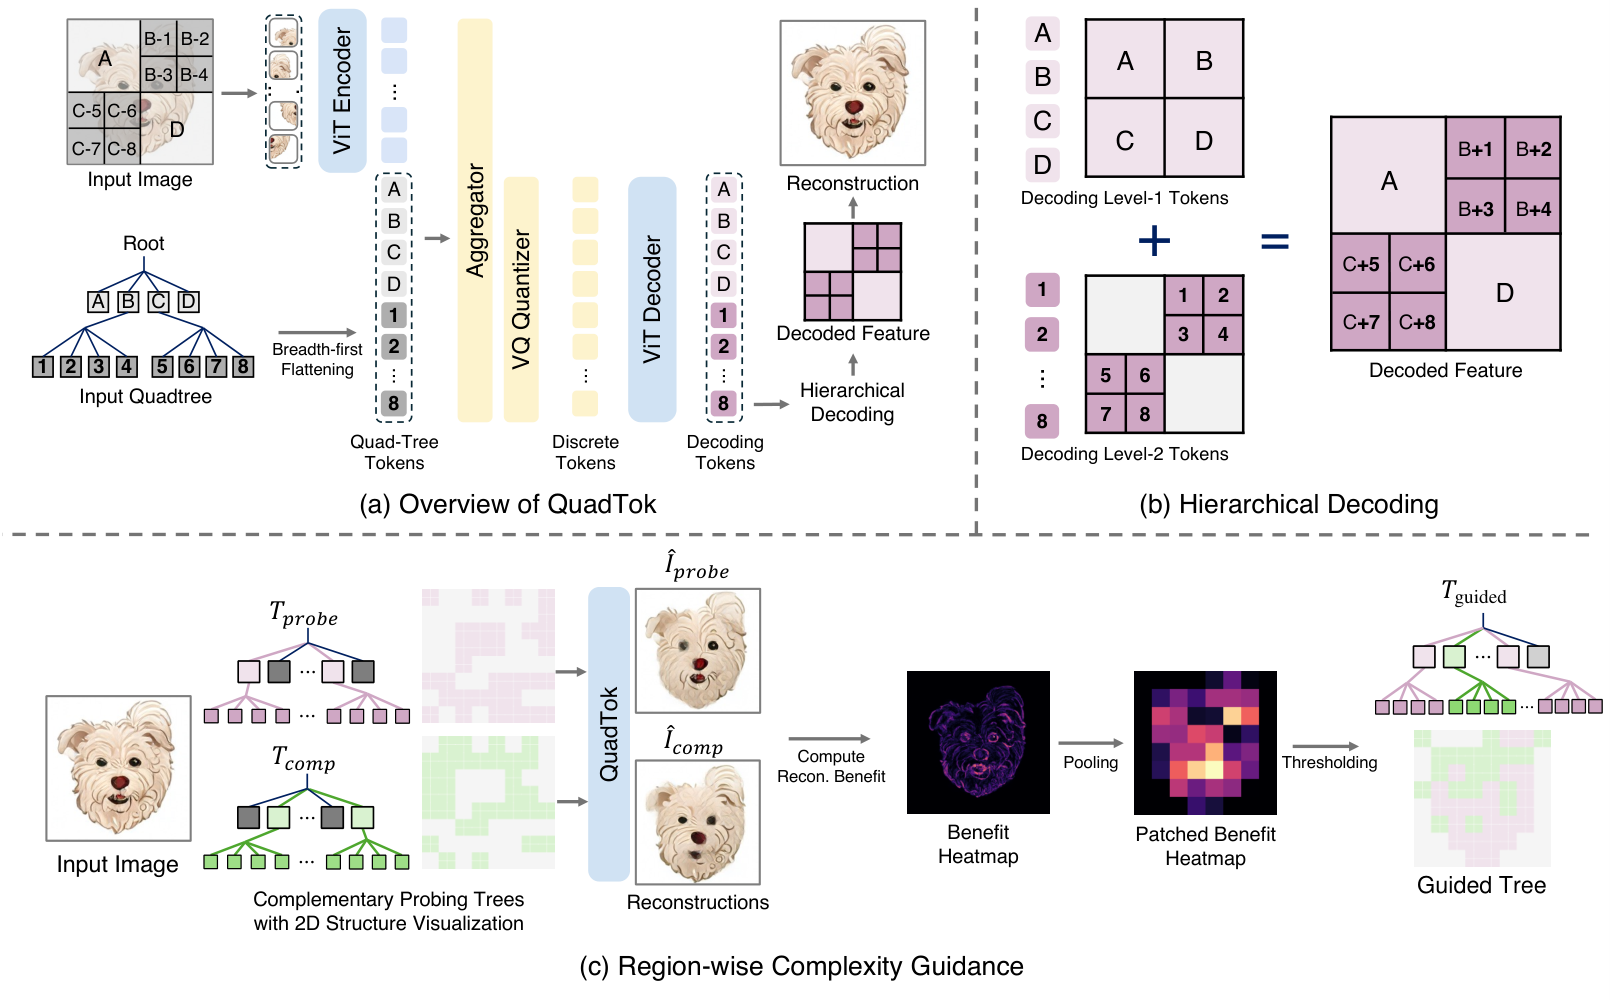
QuadTok 是一种全新的视觉 tokenization 与自回归图像生成框架。与使用 2D 网格或 1D token 序列的传统方法相比,它提出分层四叉树结构,弥合 2D 空间绑定与 1D 序列级灵活性之间的鸿沟。 QuadTok tokenizer 动态地将表示容量分配给视觉复杂的区域,让同质区域保持粗分辨率。与固定的 256-token 网格相比,该 tokenizer 在 ImageNet 上节省约 10% token,零样本迁移到 COCO 时节省 9%,同时保持相近的重建保真度。 树结构天然引入的因果性无缝支持自回归图像生成。以生成前给定的四叉树拓扑为条件,947M 的 GPT 风格生成模型在 ImageNet 256×256 基准上取得 2.08 gFID;借助四叉树保留的强空间相关性,QuadTok 生成器还具备零样本空间可控图像生成能力。代码:https://github.com/myc634/QuadTok
论文精读
TL;DR QuadTok 用四叉树实现视觉分词,按图像区域复杂度非均匀分配 token,相比固定网格节省约 10% token 并保持重建质量,同时支持自回归生成(ImageNet gFID 2.08)与零样本空间布局控制。
问题
问题背景
视觉 tokenization 是自回归图像生成的基础,目标是将连续图像映射为离散 token 序列供 Transformer 建模。当前领域关注 表示效率 与 生成质量 的平衡,以及 空间可控性。
现有方法局限
- 2D 网格型 tokenizer(如 VQGAN)将图像均匀切分为固定 patch,对平滑区域和纹理密集区域分配相同 token 数,造成表示冗余或细节丢失。
- 1D 序列型 tokenizer(如 ViT-VQGAN)虽便于自回归建模,但序列顺序与 2D 空间结构脱节,导致长程依赖建模困难,且难以直接施加空间布局控制。
- 固定 token 长度导致计算成本随分辨率平方增长,在 256×256 以上分辨率时推理效率低下。
为什么这个问题难且重要
核心挑战在于 内容自适应 token 分配 与 自回归因果性 间的矛盾:图像是 2D 信号,自回归生成强制 1D 顺序;引入非网格稀疏结构必须同时满足解码重建质量、编码计算效率和生成因果关系。该问题直接影响大规模图像生成模型的训练与部署成本,并关系到能否实现 零样本空间布局控制,是生成式 AI 走向实用化的关键瓶颈。
行业类比
类似点云压缩中的八叉树表示,根据局部几何复杂度动态调整分辨率,既节省存储又保留关键结构;QuadTok 将这一思想迁移到图像 tokenization,为算力受限场景提供了更优的表示选择。
核心洞察
- 内容自适应分词:QuadTok 采用四叉树结构根据区域复杂度动态分配 token,细节丰富区域使用更细粒度,均匀区域保持粗粒度。相比固定 256-token 网格,在 ImageNet 和 COCO 上分别节省约 10% 和 9% tokens 且重建质量相当。这不同于传统的均匀网格或基于显著性的裁剪方法,树结构天然支持多尺度表示,无需额外后处理即可实现内容自适应的压缩,为高效视觉 tokenization 提供了新思路。
- 树形因果序列化:四叉树的深度优先遍历自然产生因果顺序,使得自回归生成模型无需额外序列化方案即可利用 2D 空间结构。作者提出的 Kinship 因果注意力显式建模节点间的父子与兄弟关系,弥补了树结构中远距离依赖的不足,同时保留局部空间相关性。相比 1D 光栅扫描会破坏 2D 邻接,该方法在 ImageNet 256×256 上取得 2.08 gFID,并赋予了生成模型零样本空间布局控制能力。
- 零样本空间布局控制:QuadTok 生成器允许用户在生成前指定四叉树拓扑,从而控制图像不同区域的内容复杂度与布局,无需额外训练或条件注入。这是通过树节点与图像区域的直接对应实现的。相比需要专用控制模块或微调的条件生成方法,这种能力从树结构中自然涌现,降低了可控图像生成的工程门槛,也为自回归模型的空间可解释性提供了新视角。
方法
QuadTok 的核心流程为:输入图像 → Quadtree 表示与图像编码 → 矢量量化与分层解码 → 区域复杂度引导的 token 分配 → 自回归生成。
输入与 Quadtree 表示
输入为一张图像,先通过编码器(如 CNN 或 ViT)得到特征图。随后在特征图上构建 四叉树结构,将图像递归划分为不同粒度的区域:对于视觉细节丰富的区域(如物体边缘、纹理)细分至更深的层级,而对于平坦或同质区域保持较粗的粒度。该结构动态分配表示容量,同时保留 2D 空间约束。
矢量量化与分层解码
对每个四叉树节点对应的特征块进行 矢量量化,得到离散 token 序列。解码时采用 分层解码器,根据四叉树拓扑逐步重建图像,从粗粒度到细粒度融合特征,保证重建质量。
区域复杂度引导的 Token 分配
利用 区域复杂度度量(例如梯度或信息熵)在训练和推理时决定是否继续分裂节点。相比固定 256-token 网格,在 ImageNet 上可节省约 10% 的 token 数,在 COCO 零样本迁移上节省约 9%,而重建保真度相当。
自回归生成与 Kinship Causal Attention
生成阶段,先给定一个 quadtree 拓扑(可由用户指定或由复杂度先验生成),然后使用 GPT 风格的自回归模型逐 token 生成。为利用四叉树中的空间相关性,设计了 Kinship Causal Attention:在自回归过程中,每个 token 只能关注其祖先节点和先序兄弟节点,从而保持因果性并编码空间层级关系。最终将生成的 token 序列映射回四叉树并解码为图像。
输出与空间控制
输出为完整图像;由于四叉树天然保留空间位置,可在不额外训练的情况下实现 零样本空间布局控制(如生成指定区域内容的图像)。
与同类方法的差异点:QuadTok 用层次化四叉树替代规则 2D grid 或平坦 1D 序列,在 token 效率和空间可控性之间取得平衡,并引入了针对树结构的因果注意力机制。
实验
实验设计
QuadTok 在 ImageNet 上训练 tokenizer,并零样本迁移到 COCO 评估 token 节省与重建质量;生成模型为 947M GPT-style 架构,在 ImageNet 256×256 上评测 gFID。此外还测试了基于 quadtree 结构的零样本空间布局控制能力。
关键发现
- 动态 token 分配:相比固定 256-token grid,ImageNet 上节省约 10% tokens,COCO 零样本节省 9%,同时保持可比重构精度。
- 生成质量:947M 模型取得 2.08 gFID,展示了 quadtree 拓扑条件生成的有效性。
- 空间可控性:利用 quadtree 保留的强空间相关性,实现零样本空间布局控制,无需额外训练。
与基线对比解读
传统 2D grid tokenizer 缺乏内容自适应,均匀分配 tokens;1D sequence 则丢失空间绑定。QuadTok 通过层级 quadtree 桥接两者,在低复杂度区域合并 tokens 提升效率,同时保持高复杂度区域的细节。与固定 grid 相比,token 节省直接降低后续 AR 生成的计算开销,而 gFID 2.08 表明其生成竞争力,且通过拓扑条件引入的因果关系使自回归生成更自然。
行业影响
落地场景
QuadTok 的核心优势在于 自适应 token 分配 与 零样本空间控制,可直接用于:
- 电商产品图生成与局部编辑:对商品主体高分辨率保留细节,背景粗粒度表示,节省推理算力,同时支持用户指定布局(如“商品在中央,背景简约”)。
- 内容创作平台:为设计师提供基于四叉树结构的布局可控生成工具,快速产出海报、广告素材。
- 游戏/影视资产生成:利用空间因果性实现从左到右、从上到下的渐进式生成,适合交互式内容创建。
商业价值
- 降本:token 节省 9%~10% 意味着更少的自回归步数,直接降低推理成本,尤其在高分辨率生成任务中。
- 增收/体验:空间布局控制能力可产品化为“拖拽式生成”功能,提升用户付费意愿;同时减少生成时间,改善用户体验。
- 模型部署友好:947M 参数 GPT 风格模型在 ImageNet 上达到 2.08 gFID,与更大模型相当,适合边缘或云端轻量化部署。
与现有产品/工作流接口
- 可替换现有 VQ-VAE/VQGAN tokenizer,作为自回归图像生成模型的编码器,无需改变生成器架构(GPT-style)。
- 结合扩散模型同样可行:将 QuadTok 输出的层次 token 作为条件输入,实现空间可控的扩散采样。
- 在已有 MLOps 管道中,只需增加 quadtree 拓扑预测模块(轻量 CNN 或规则),即可利用现有训练框架。
具体 use case:某电商平台需要批量生成商品主图与场景图,可使用 QuadTok 先对原始商品图进行 token 化,仅用少量 token 表示背景,再通过自回归模型依据用户提供的布局条件(如“产品位于左下,背景为渐变”)生成符合要求的图片,节省约 10% 推理成本。另一场景是社交媒体平台的内容审核与生成服务,利用空间因果性支持流式生成,边生成边展示,提高用户互动率。
局限
- **训练与推理复杂度**:四叉树结构引入了额外的拓扑生成与条件输入,训练时需要区域复杂度引导,推理时需预先提供树结构。论文仅在 ImageNet 256×256 与 COCO 上验证重建,高分辨率扩展仅出现在附录中且未系统评估。动态 token 分配虽然节省 token,但树结构采样与层次解码的工程实现复杂,可能导致训练不稳定或需要精细调参,实际部署时额外的前处理(区域复杂度计算)也可能成为瓶颈。
- **零样本空间控制的粒度有限**:虽然四叉树结构提供了零样本空间布局控制能力,但该控制仅限于区域级别的 token 分配,并非像素级精确操控。用户必须手动或借助额外算法生成符合预期的四叉树拓扑,这提升了使用门槛。对于需要精细语义分割或实例级控制的场景,该方法可能无法满足要求,且论文中的定量评估仅覆盖粗略定位指标,缺乏与专门可控生成方法的直接对比。
- **与高效自回归模型的对比不足**:QuadTok 的 947M 生成模型在 gFID 上达到 2.08,但未与当前更高效的自回归方法(如 VAR、MaskGIT 等)进行全面对比,也未报告推理延迟与显存占用。四叉树带来的约 10% token 节省是否能在更大分辨率或更复杂数据集上保持,尚不明确。此外,该方法仍采用 GPT 风格的逐 token 生成,可能受限于自回归解码的串行特性,难以扩展到高分辨率实时应用。