基于标量伴随匹配的 Q-Learning
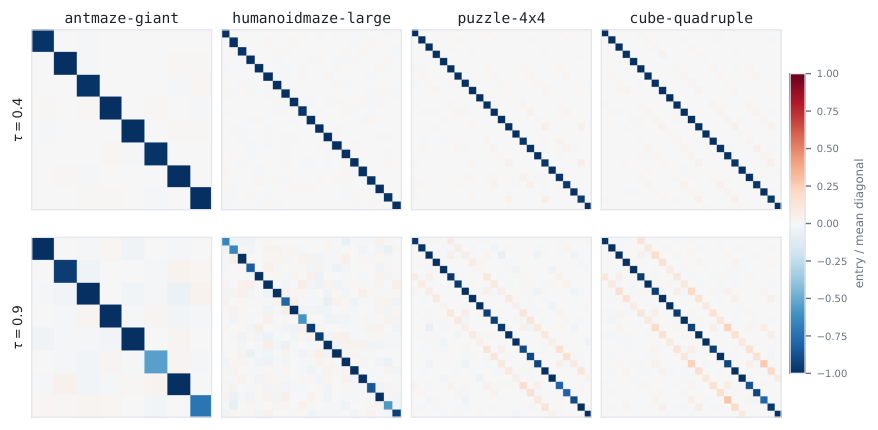
Flow policies 能刻画丰富多样的动作分布,用 off-policy RL 对其微调以超越示教数据近来备受关注。但针对学到的价值函数微调 flow policy 并不简单:策略需要在多个 flow step 上逐步生成动作。 Adjoint matching 提供了一种有原则的做法,把最终动作的价值信息反向传播到每个 flow step 来更新 flow 模型本身,但它要求在每一步都计算一次策略的 vector-Jacobian product,开销随 flow step 数量与策略规模增长。 作者观察到,预训练 flow policy 的 batch 平均速度 Jacobian 集中在对角线上。受此启发,他们推导出一个闭式标量伴随(scalar adjoint),用 flow time 缩放最终动作处的价值梯度,从而消除逐步的 vector-Jacobian product。作者进一步发现,在标量伴随下,控制 critic 在策略生成动作处的价值尤为重要,于是提出 SQAM(Q-learning with Scalar Adjoint Matching),把标量伴随与这些动作上的价值惩罚(value penalty)结合。 SQAM 的增益集中在四个最难的 OGBench 域,其成功率比各域最强基线高出 18 至 35 个百分点。为检验它能否扩展到大规模预训练策略,作者还在真实双臂机器人上微调了一个 vision-language-action 策略,SQAM 在三个任务上均优于监督微调。
论文精读
TL;DR SQAM 利用预训练流策略速度雅可比的对角线集中特性,用闭式标量伴随替代昂贵的逐步骤向量-雅可比乘积,大幅降低流策略微调成本,并在 OGBench 最难域上比最强基线高 18-35 个百分点。
问题
问题背景
流匹配策略(flow policy)以其对复杂多模态动作分布的表达能力,在机器人操作等任务中成为行为克隆的强基线。如何通过离策略强化学习(off-policy RL)在示范数据之外继续提升策略,是当前离线到在线微调的核心关注点。
现有方法局限
直接对 flow policy 做 off-policy RL 面临信用分配难题:动作由多个流步骤(flow steps)逐步生成,价值梯度需从最终动作反传到每个中间步骤。Adjoint matching 类方法(如 QAM)通过伴随方程传播价值信息,但每一流步骤都需计算 vector–Jacobian product (VJP),计算量与流步数、策略参数量线性增长,导致大型策略或较长流链上训练开销过大。此外,现有 critic 在学习策略自身生成动作处的价值时可能存在偏差,加剧微调不稳定。
为什么这个问题难且重要
流策略的前向生成本质上是一个常微分方程/随机微分方程积分过程,反向价值传播通常需要存储中间状态或昂贵的高阶梯度。本文发现预训练 flow policy 的批量平均速度雅可比矩阵高度集中在对角线上,由此推导出闭合形式标量伴随——仅用最终动作的价值梯度按流时间缩放,完全消除逐步 VJP。配合对策略生成动作的价值惩罚,可有效抑制过估计。该思路在 OGBench 最难的四个任务上将成功率提升 18–35 个百分点,并成功扩展到真实双臂机器人。这为生成式策略的强化学习微调提供了更可扩展的路径。
行业类比
类似于扩散模型微调时用近似梯度(如低秩适配或蒸馏)绕过全链反向传播,SQAM 为流策略的 RL 微调找到了轻量且有效的梯度近似方案。
核心洞察
- - **将 vector-Jacobian 乘积近似为标量缩放**,大幅降低流策略微调的计算成本。该洞察基于对预训练流策略 batch-averaged velocity Jacobian 对角占优的实证观察,将传统 adjoint matching 中每个流步骤的 vector-Jacobian 乘积简化为一个仅依赖 flow time 的标量因子乘上最终动作的值梯度。这使计算复杂度从随流步数和策略大小线性增长降为常数,突破了离线 RL 微调大规模流策略(如视觉-语言-动作模型)的效率瓶颈。
- - **critic 在策略自身动作上的值正则化是稳定训练的关键**。标量 adjoint 忽略了 Jacobian 非对角项,可能放大 critic 对策略动作值估计的偏差。SQAM 引入对 policy-generated actions 的 value penalty,约束 critic 输出,防止自举过估计,从而保证策略更新方向可靠。实验显示,该正则化在 OGBench 最难域上带来 18-35 个百分点成功率超越最强 baseline,并泛化到真实双臂机器人任务。
方法
SQAM 的输入包括预训练的 flow policy(参数化动作从噪声到最终动作的多步演化)、离线交互数据以及学习到的 critic(价值函数)。核心目标是微调 policy 以超越示范表现,同时避免昂贵的逐步 vector–Jacobian product。
关键模块一:Scalar Adjoint
作者观察到预训练 flow policy 的批量平均速度 Jacobian 近似对角占优,据此将每个 flow step 的 VJP 简化为一个闭式标量缩放:仅取最终动作处的 value gradient,乘以 flow time(步数或时间系数)。该标量直接替代原先需要逐步反传的向量-雅可比积,将每步计算量从与策略规模线性相关降为常数级。
关键模块二:Value Penalty
由于标量近似会降低 critic 梯度信息的精确性,单纯使用 scalar adjoint 可能导致 critic 对 policy 生成动作的价值高估。SQAM 在 policy 自身采样的动作上对 critic 输出施加惩罚(如正则项),强制 critic 对这些动作给出保守估计,稳定训练。
输出与更新
结合上述两项,policy 参数更新方向由 scalar adjoint 提供的值梯度与 value penalty 共同决定,并通过信任域(KL 约束)限制更新幅度。最终输出是微调后的 flow policy,可直接用于动作生成。
与同类方法差异:相比 QAM(需在每个 flow step 计算完整 VJP),SQAM 用标量缩放 + value penalty 在几乎不损失性能的前提下将计算开销从 O(T·P) 降至 O(1),并显著提升 OGBench 困难任务的成功率。
实验
实验设计叙述
实验在 OGBench 的四个最难领域和真实双臂机器人 RB-Y1 with Wuji Hand 2 上评估 SQAM。对比基线包括 FQL、CGQL-L、DSRL、IFQL、QAM、QAM-E、TRQAM、EXPO 和 EXPO-FT。消融研究覆盖 adjoint 方法对比、价值学习方案、价值惩罚系数 (c) 和 KL 预算 (\epsilon_{\text{KL}})。此外,将 SQAM 扩展到大型预训练 VLA 策略,在三个真实机器人任务上测试。
关键发现
SQAM 在四个最难的 OGBench 领域成功率超过各自最强基线 18 到 35 个百分点。这种提升源于:
- 标量伴随:利用批量平均速度雅可比的对角集中特性,将逐步向量-雅可比乘积替换为标量缩放,大幅降低计算成本。
- 值惩罚:在策略生成的动作处对 critic 施加正则,稳定标量伴随下的价值学习。
在真实机器人上,SQAM 微调后的策略在全部三个任务上优于监督微调。
与基线对比的深度解读
与需要向量-雅可比乘积的 QAM 相比,SQAM 在保持性能的同时显著减少每步计算开销,使流策略微调更适用于大规模模型。与 TRQAM 等近期方法相比,SQAM 通过显式的值惩罚解决了标量伴随带来的 critic 不稳定性,而无需复杂的信任域约束。在 OGBench 最难领域的大幅提升表明,该方法特别适合探索困难、需要超越演示数据的场景。
行业影响
落地场景
SQAM 面向用 flow policy 做决策的强化学习任务,适合从演示数据预训练后需要进一步优化的场景。典型用例包括:
- 机器人操作:如仓库分拣、双臂协作,演示数据容易获取但难以覆盖所有情况,SQAM 微调可提升在困难布局下的成功率。
- 自动驾驶:从人类驾驶数据预训练的行为规划策略,通过 SQAM 与仿真环境交互微调,改进罕见场景的决策质量。
- 内容生成:生成式策略如文本到动作、图像编辑,用 SQAM 在奖励信号下微调生成器。
商业价值
主要收益来自计算成本降低和性能提升。传统 adjoint matching 需要每个 flow step 的 vector–Jacobian product,计算量与步数和策略规模线性增长;SQAM 的 scalar adjoint 大幅减少反向传播开销,使微调大模型成为可能。在 OGBench 最难四个域上,成功率超过最强基线 18–35 个百分点,意味着在真实部署中可显著减少人工干预和物料损耗。此外,价值惩罚稳定训练,减少超参数调优时间。
与现有工作流接口
SQAM 可以嵌入现有 offline-to-online RL 流程:先用离线数据预训练 flow policy 和 critic,再用 SQAM 进行在线微调;它与 Q-learning 框架兼容,不需要额外网络结构,只需替换梯度传播方式。对于大模型(如 VLA),可在监督微调之后接入 SQAM 作为强化学习阶段,复用已有的价值网络和回放缓冲区。代码已开源 SQAM,项目页提供细节 项目主页。
局限
- 论文明确指出的核心局限在于面向 flow policies 的价值学习本身仍不成熟。SQAM 依赖学习到的价值函数来指导策略更新,但该价值函数在离线数据有限或动作分布偏移时估计偏差较大,进而影响 scalar adjoint 的梯度信号。作者在 Limitations and future work 中也强调 Value learning for flow policies 是一个未解决的问题,这表明 SQAM 的性能上限受制于 critic 质量,在复杂任务上可能不稳定。
- scalar adjoint 的推导基于 batch-averaged velocity Jacobian 集中在对角线上这一经验观察,但论文并未给出严格的理论解释,也没有分析非对角分量不可忽略时的失效条件。该近似只用 flow time 作为全局缩放因子,丢弃了 Jacobian 的局部结构信息,在动作空间耦合较强或策略网络结构复杂时可能导致策略更新方向偏差,影响收敛性和最终性能。
- 实验验证的范围相对有限:离线 RL 部分集中在 OGBench 的四个最难领域,真实机器人只测试了单个双臂平台上的三个任务,缺少多任务、长程操作以及更多样化的机器人形态。此外,SQAM 引入了 value penalty 系数 c 和 KL 预算等超参数,虽然论文给出了消融,但这些参数在不同任务上需要重新调节,实际部署时的调参成本较高,可能限制其即插即用性。