MIRA:用于对齐文本到音乐生成与用户意图的音乐意图精炼智能体
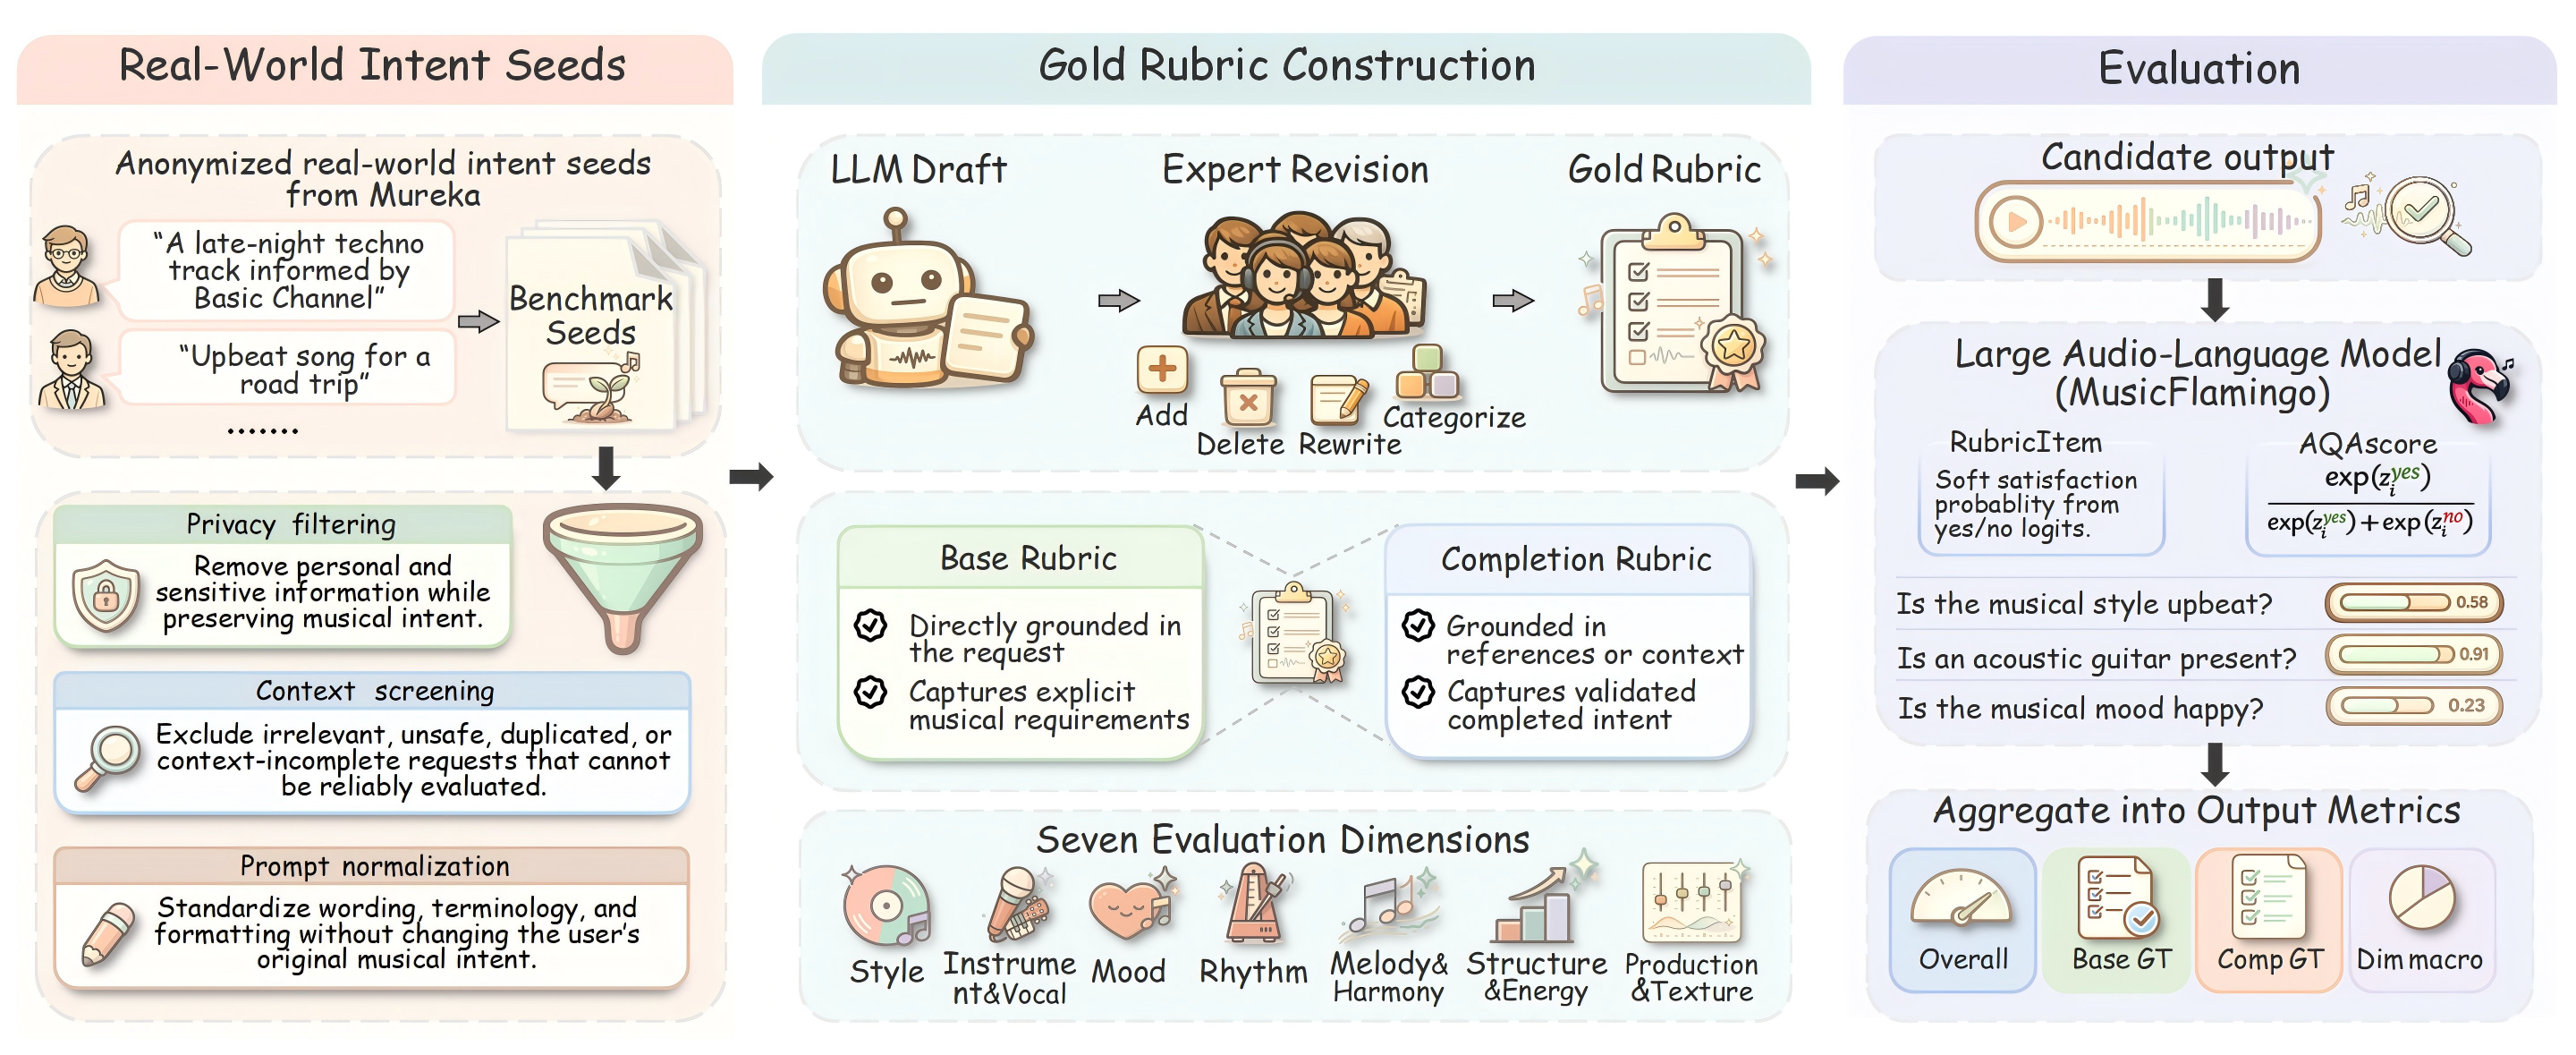
文本到音乐系统生成的音频越来越逼真,但现有评估很少能说明结果是否符合用户意图。全局的文本-音频相关性分数会忽略欠明确提示中的隐含意图,也会掩盖在配器、结构、节奏或情绪走向等具体需求上的失败。为弥合这一差距,本文把文本到音乐意图对齐形式化为满足一份逐请求评分量表(rubric):量表由若干可独立验证的条目组成,覆盖请求的显式要求与隐含的音乐意图。逐条打分使评估能按意图来源与音乐维度进行诊断,而非给出单一的不透明分数。 作者据此构建了 MuRA-Bench,一个由音乐专家策划、源自真实平台请求的基准。同时提出 MIRA(Musical Intent Refinement Agent,音乐意图精炼智能体):这是一个测试时智能体,先把请求意图落地为评分量表,再在有限预算下针对黑盒生成器搜索提示改写,迭代地生成音乐、按量表验证,并用这些反馈引导轨迹感知的树搜索。 在开源与商业后端上的实验表明,MIRA 提升了意图对齐效果,使开源生成器达到与代表性商业系统(如 Suno 和 Mureka)相当的性能。项目主页:https://mirareview.github.io/ 。
论文精读
TL;DR MIRA 将文本到音乐的意图对齐分解为可验证的 rubric 细项,通过测试时树搜索迭代精炼提示,让开源生成器对齐效果媲美 Suno 等商业系统。
问题
问题背景
文本到音乐生成(Text-to-Music, TTM)系统已能输出高保真音频,但评估仍依赖全局文本-音频相关性分数,难以反映输出是否真正满足用户的具体创作意图。
现有方法局限
- 全局分数掩盖细粒度失败:如
CLAPScore只给出整体相似度,无法定位乐器编排、段落结构、节奏型或情绪推进等具体维度的偏差。 - 隐式意图被忽略:用户 prompt 常为“一首孤独的钢琴曲”等 underspecified 描述,现有评估不区分“听起来像钢琴”和“表达孤独感”,导致符合显性要求但丢失隐含情绪的生成被误判为成功。
- 缺少可解释的评测基准:现有 benchmark 多依赖自动指标或简单人工评分,没有按需求项逐条验证的 rubric,模型迭代缺乏可诊断信号。
- 黑盒生成器难定向优化:不改动底层模型时,仅靠重写 prompt 做随机搜索效率低,缺少利用细粒度反馈指导搜索的机制。
为什么这个问题难/重要
意图对齐是生成式音乐的核心挑战:显式要求容易界定,隐含音乐意图高度主观且依赖上下文;跨模态文本到音频的映射存在固有模糊性,不同用户对同一 prompt 的期待可能分歧。业界关注度高,因为商业系统(如 Suno、Mureka)仍在满足“具体编排、情绪演进”等专业需求上表现不稳定,自动评测需要能从意图来源和音乐维度两个轴上进行诊断。在有限测试预算下,如何构建可信的逐项验证、并用其反馈驱动树搜索,是兼具研究与应用价值的问题。
行业类比
类似 LLM 评估从单一 BLEU 转向基于 checklist 的指令遵循评测(如 IFEval),音乐生成也需要从“整体像不像”升级为“逐项是否达标”的可验证意图对齐。
核心洞察
- 将文本到音乐的意图对齐从单一全局相似度分数转变为逐项可验证的 rubric 评分。与常见的 CLAPScore 或整体文本-音频相关性基线不同,MuRA-Bench 将每个请求分解为显式需求和隐含意图的独立条目,覆盖配器、结构、节奏、情绪进展等维度。这样能指出具体失败原因,而非一个不透明的总分数,且更贴近真实平台请求中常见的欠具体化提示。
- 在测试时引入基于工具grounded在线rubric引导的树搜索智能体 MIRA,对黑盒生成器进行提示优化,无需训练或内部访问。区别于单纯的文本改写或候选重排序,MIRA 在固定预算内迭代生成音乐、根据 rubric 逐项验证,并利用轨迹感知的树搜索和结构化反馈记忆指导后续尝试。实验显示,在多个开源与商业后端上,MIRA 将开源生成器的意图对齐提升至与 Suno、Mureka 等商业系统相当的水平。
方法
输入与输出
输入为用户文本请求与黑盒文本到音乐生成器;MIRA 输出对齐用户意图的优化提示词或最终音乐候选。
关键模块
- Tool-Grounded Online Rubric 首先将请求意图解构为逐项可验证的评估准则,覆盖显式要求(乐器、结构、节奏、情绪演进)与隐含音乐意图。
- Rubric-Guided Search 在有限预算下对提示词改写进行搜索:每次生成音乐后,对照准则逐项验证,并将反馈用于引导轨迹感知的树搜索。
- Tree-Structured Feedback Memory 存储搜索轨迹与验证反馈,支持回溯与剪枝。
- Candidate Selection 依据准则满足程度选择最佳候选。
与同类方法的差异
与依赖全局音频-文本相关性分数的既有代理式细化方法不同,MIRA 用按意图来源与音乐维度诊断的准则级验证驱动搜索,能捕获欠明确提示中的隐含意图。
实验
实验设计
论文构建了 MuRA-Bench,一个由音乐专家从真实平台请求中精选的基准,以逐项可验证的 rubric 来评估文本到音乐生成的意图对齐。每个请求被拆解为覆盖显式要求与隐含音乐意图的多个独立检查项,分别按意图来源和音乐维度打分,而非单一全局相关度。
实验在开源和商业后端(如 Suno 和 Mureka)上测试 MIRA。MIRA 在测试时先根据请求生成在线 rubric,然后在限定预算内对黑盒生成器进行提示修订搜索:迭代生成音乐、按 rubric 验证、用反馈引导轨迹感知的树搜索。
关键发现
摘要指出,跨多个后端实验中 MIRA 提升了意图对齐,并使一个开源生成器达到与代表性商业系统可比的表现。这验证了将评测从单一分数转向细粒度 rubric 的必要性,也说明通过测试时搜索优化提示可以在不重训练模型的情况下弥补生成模型的意图偏差。
与基线对比的深度解读
传统评测常用 CLAPScore 等全局相关度指标,容易掩盖对配器、结构、节奏、情绪递进等具体要求的失败。MIRA 与 MuRA-Bench 的组合把评测对象从“整体相似度”变为“逐项需求满足率”,不仅提供诊断信息,也为后续迭代提供可操作的反馈信号。相比仅依赖单次生成的系统,MIRA 的 轨迹感知树搜索 能针对未通过的 rubric 项定向修订提示,提高预算利用效率。
该方法不依赖特定生成器,可作为通用测试时增强策略,对实际工程中快速适配不同后端、降低对高成本人工评测的依赖具有参考价值。
行业影响
落地场景
MIRA 可嵌入任何文本到音乐生成下游产品:
- 音乐流媒体/创作平台:给用户提供更符合意图的配乐生成,尤其在短视频背景乐、播客过渡音效等场景。
- 广告与品牌营销:根据 campaign 文案自动生成符合品牌调性的音乐,减少人工试错。
- 游戏与交互媒体:动态生成与剧情、情绪匹配的背景音乐,提升沉浸感。
商业价值
核心价值在于提升意图对齐率,直接作用于:
- 用户体验:减少“生成结果不符合描述”的挫败感,提高用户留存和付费转化。
- 运营成本:自动化的rubric 校验与迭代搜索替代大量人工审核与二次生成请求,降低算力浪费。
- 竞争力:开源生成器配合 MIRA 可达到商用系统水平(如 Suno、Mureka),为中小团队提供低成本差异化方案。
与现有产品/工作流的接口
MIRA 是黑盒生成器的外层代理,无需修改生成器内部:
- 在 API 调用链中插入 MIRA:接收自然语言请求 → 生成 rubric → 调用底层 text-to-music API 生成候选 → 用 rubric 打分并触发搜索 → 返回最优音频。
- 支持有限预算下的树搜索,可配置为对生成器只做少量调用,适合实时或准实时场景。
- 输出包含可解释的 rubric 评分,便于产品侧展示“为什么这段音乐符合要求”,增强信任。
具体落地 Use Case
- 短视频/直播平台:创作者输入“一段欢快的电子音乐,前奏 5 秒,副歌节奏加快”,系统用 MIRA 自动筛选出最符合结构要求的候选,减少手动调整。
- 电商广告:根据商品文案(如“智能手表科技感宣传片”)生成配乐,MIRA 通过 rubric 校验是否包含科技感音色、节奏与画面切换点是否匹配,避免返工。
局限
- 测试时优化带来显著计算开销。MIRA 在推理阶段需要多次执行生成-验证循环和树搜索,每次迭代均调用生成器与评分模型,总推理成本远高于单次生成,可能不适合实时交互或低延迟场景。论文虽提及“bounded budget”,但未给出具体延迟与成本量化分析,实际预算可能仍偏高。此外,依赖黑盒生成器 API 会引入额外费用、速率限制及外部服务稳定性风险。
- 基准与评分标准的主观性及覆盖度限制。MuRA-Bench 的评分标准由音乐专家制定,虽然经过多轮修订,但专家判断本身存在主观性,不同流派或文化背景的专家可能产生分歧。论文未明确基准规模及请求多样性,可能无法覆盖所有音乐风格与用户意图。评分标准中“隐含意图”的客观验证难度较大,可能导致评估噪声或偏差,影响 MIRA 搜索方向的可靠性。
- 与直接优化生成模型的方法相比,MIRA 仅通过提示词修订间接影响生成结果,无法修改模型内部表征或生成策略。对于深层音乐意图(如和弦进行、音色细节、混音平衡),仅靠文本提示可能无法充分表达,改进幅度受限于基础生成器的能力天花板。与端到端微调或 reinforcement learning 类方法相比,MIRA 的优化空间更窄,且改进效果依赖于生成器对提示词的敏感度。