SPW-Nav: 面向语言引导导航的流式全景世界模型
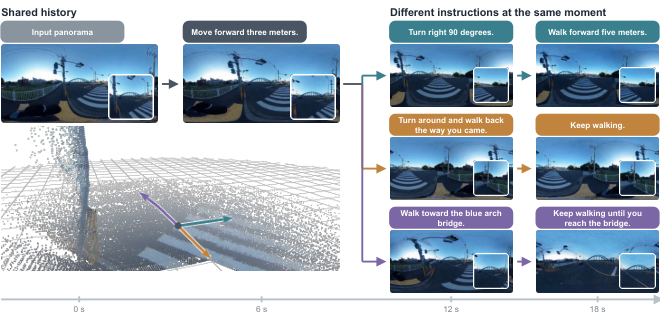
语言引导的全景视频生成可支撑交互式 3D 场景探索、虚拟现实体验与具身智能体训练等下游应用。现有全景生成器沿预设轨迹生成,而交互式世界模型仅在透视视角下通过低层动作进行交互。 我们提出 SPW-Nav,一个流式全景世界模型,能够理解运动指令,并从单张全景图出发实时流式生成一分钟的 2K 360 度视频。SPW-Nav 把上一步生成的全景图中每条指令解析为相机运动:球面旋转解耦 将旋转精确施加在球面上,位姿对齐条件 让平移输入在长序列流式生成中保持有界,多项记忆 结合少步生成器,在指令变化时继续延续场景。 我们同时构建了 SPW-NavSet,包含带有相机轨迹与经校验指令的全景视频。在语言驱动下,SPW-Nav 在相机跟随精度与视频质量上均优于先前的全景生成器,并支持指令的即时切换。
论文精读
TL;DR SPW-Nav 从单张全景图实时流式生成 1 分钟 2K 360° 视频,以自然语言指令控制相机运动并支持随时切换,通过球面旋转解耦与位姿对齐保持几何一致性。
问题
问题背景
生成式世界模型需要支持用户和智能体在虚拟环境中自由探索,全景视频覆盖 360° 视野,自然语言指示移动方向而不依赖相机位姿,因此语言引导的连续全景视频生成成为关键需求。
现有方法局限
- 文本到视频模型 仅能基于单一提示生成完整视频,无法逐步响应指令序列或中途改变路径。
- 相机控制的全景生成器 只能沿预定义轨迹生成,缺乏交互性和实时性,无法根据语言指令动态调整。
- 导航与交互世界模型 及视觉语言智能体通常执行低级动作(如键盘输入),且主要工作在前向透视视图,未利用全景视角,难以生成一致的 360° 流式视频。
- 长序列生成中,球面旋转误差累积、位移无法保持有界,且缺乏有效的记忆机制维持场景一致性。
为什么这个问题难且重要
- 技术挑战:需在球面上精确解耦旋转(避免极区畸变),设计位姿对齐条件使位移输入有界,并用多期限记忆配合少步生成器实现实时流式输出。同时支持指令在线切换,对模型架构和训练数据要求高。
- 业界关注:生成式世界模型是具身智能、虚拟现实、交互式 3D 场景探索的基础组件。语言作为自然控制接口,能大幅降低使用门槛,生成无限多样的导航视频作为训练数据,推动机器人学习与仿真发展。
行业类比
类似自动驾驶仿真系统中,用自然语言指令控制 360° 环视摄像头在虚拟城市中任意漫游,生成多样化驾驶场景用于感知与规划模型训练。
核心洞察
- SPW-Nav 将语言引导导航与全景视频生成统一为一个流式世界模型,直接以自然语言指令作为控制信号,而非预定义轨迹或透视视角下的低级动作。这区别于现有全景生成器只能跟随固定轨迹,以及交互世界模型依赖键盘输入或离散动作的局限。模型在已生成的全景图中解释每条指令为相机运动,支持实时指令切换,为具身智能和虚拟探索提供更自然的交互范式。
- 球形旋转解耦与姿态对齐条件化是解决长时流式生成中误差累积的关键。传统相机控制生成通常在欧氏空间近似旋转,长时间序列会产生漂移;SPW-Nav 在球面上精确施加旋转,并将平移输入通过姿态对齐保持有界,配合多期记忆与少步生成器,实现一分钟 2K 全景视频的实时生成且场景保持一致。该设计对需要长程一致性的世界模型具有工程借鉴意义。
- SPW-NavSet 数据集填补了语言引导全景导航的数据空白。现有数据集要么只有全景视频而缺乏语言指令,要么语言导航数据基于透视视角和低级动作标注。SPW-NavSet 提供带相机轨迹和验证指令的全景视频,使得模型能够直接学习自然语言到球面相机运动的映射,并支撑相机跟随精度和视频质量的客观评估,为后续研究提供了可复用的基准。
方法
输入与总体流程
- 输入:单张 2K 360° 全景图 + 一序列自然语言运动指令(如“向前走”“左转进入走廊”)。
- 输出:实时流式 2K 全景视频,最长一分钟,随时可响应新指令切换路径。
关键模块
- 指令解析与相机运动估计:将每条指令映射为球面相机运动参数,包括旋转与平移。旋转分量直接在球面上执行,避免平面等距柱状投影的几何畸变——即 球形旋转解耦(spherical rotation decoupling),保证旋转后全景图仍符合球面一致性。
- 姿态对齐条件生成:将上一步计算出的相对相机姿态(旋转+平移)作为条件输入视频生成器,使平移量在长序列生成中保持有界,防止误差累积导致漂移,即 姿态对齐条件(pose-aligned conditioning)。
- 多期限记忆与少步生成:维护多个时间尺度的视觉记忆(短期局部上下文与长期场景结构),用 少步生成器(few-step generator)在仅需少量去噪步骤下生成下一帧,实现实时流式输出;记忆机制在指令切换时保留场景元素,维持时间一致性。
- 训练数据:构建 SPW-NavSet,包含带相机轨迹与人工验证指令的全景视频,支撑语言-运动对齐学习。
跟同类方法的差异点
现有全景生成器跟随预定义轨迹,交互世界模型依赖低层动作且在透视视图操作;SPW-Nav 首次将自然语言指令作为高层控制信号,直接在球面全景域生成连续流式视频,并保持长时几何一致性。
实验
实验设计
论文构建 SPW-NavSet,包含全景视频、相机轨迹以及经过验证的移动指令。实验围绕语言引导导航、相机控制生成、应用演示和消融分析展开,对比此前的全景视频生成器与交互式世界模型。评测指标覆盖相机跟随精度和视频质量,重点检验长时间流式生成下的场景一致性与指令切换能力。
关键发现
SPW-Nav 在相机跟随精度和视频质量上超越先前全景生成器,并支持在生成过程中实时切换指令。其核心机制包括:spherical rotation decoupling 在球面上精确施加旋转,避免透视畸变;pose-aligned conditioning 将平移输入限制在稳定范围,适应长序列;multi-term memory 与少步生成器结合,在指令变化时延续场景。实验还验证了单张全景图可生成一分钟 2K 360° 视频,且能零样本泛化到未见场景。
与基线对比解读
现有方法往往只覆盖交互的局部:文本到视频模型用单一 prompt 控制整段视频,相机控制生成器依赖预定义轨迹,导航模型则依赖低层动作并在透视视角操作。SPW-Nav 将语言指令直接映射为全景相机运动,避免了轨迹预设和视角限制。相比逐帧低层控制,它在长时生成中能保持轨迹一致性和视觉质量,更接近面向实际探索任务的流式世界模型。
行业影响
落地场景
SPW-Nav 可直接用于 VR 看房、虚拟展厅、自动驾驶仿真、文旅数字孪生 等领域。用户或代理通过自然语言指令(如“向左转并前进”)实时生成 360° 全景视频流,无需预设相机轨迹。典型场景:电商平台 为商品构建可探索的 3D 环境,消费者用“走到沙发旁看看材质”等指令自由浏览;企业培训 中模拟高危环境(如化工厂、矿区)的巡检导航,替代部分实地拍摄。
商业价值
- 降本:单张全景图即可推理出长达一分钟的可导航视频,省去多机位拍摄与后期拼接,内容生产成本大幅下降。
- 增收:交互式全景体验可提升用户停留时长与转化率(如沉浸式广告、虚拟旅游付费项目)。
- 体验提升:支持 on-the-fly 指令切换,用户控制感强于传统被动观看,适合直播电商、在线教育等实时场景。
与现有产品接口
SPW-Nav 可作为 生成式后端 集成到现有 WebXR 或 Unity/Unreal 应用中:输入单张全景图与文本指令,输出实时视频流纹理,替代预先录制的 360 视频。与 VLM 导航 agent 结合时,可充当其环境模拟器,为具身智能训练提供可交互的全景世界。接口建议采用服务化部署(如 gRPC),支持流式传输帧与相机姿态元数据。
局限
- 论文未在摘要中明确列出局限性,但根据方法描述可推断:流式生成时长上限为一分钟,且每个序列从单个全景图开始,无法直接支持多场景连续探索或长时间任务。这限制了其在需要长期记忆或跨场景导航的应用中的使用。此外,模型对未见场景的零样本泛化能力仅在附加结果中提及,其鲁棒性需要更多基准测试验证。对比现有交互式世界模型,SPW-Nav 仍以全景视频生成为核心,缺少对场景中可交互物体的操作能力,因此更偏向视觉探索而非完整具身交互。
- SPW-Nav 将语言指令解释为相机运动(旋转与平移),这意味着指令类型可能被限定为移动类表达,难以处理需要语义理解或物体交互的复杂指令,如“打开红色的门”或“跟随那个人”。同时,尽管多术语记忆模块维持长时一致性,随着流式生成推进,生成误差可能逐渐累积,导致场景漂移或细节丢失。模型对指令切换的响应虽已支持,但频繁切换是否影响生成稳定性尚未充分评估。此外,训练数据 SPW-NavSet 的规模与多样性未详细说明,可能限制泛化能力。
- 与同类工作相比,SPW-Nav 在语言引导全景生成方面取得进展,但实时生成 2K 360 度视频的计算成本较高,推理延迟可能依赖高性能 GPU,难以在低算力设备上部署。与透视视角的交互式世界模型(如基于低层动作的导航模型)相比,SPW-Nav 的全景生成虽然视野更广,但像素密度和分辨率的权衡可能影响细节呈现。另外,现有全景生成器常基于预定义轨迹进行离线的相机控制,SPW-Nav 的在线指令控制是一个进步,但其相机运动控制精度和生成内容的可控性仍需与专门相机可控模型进一步对比。