U-Space:揭示语言模型中不确定性何时以及为何产生
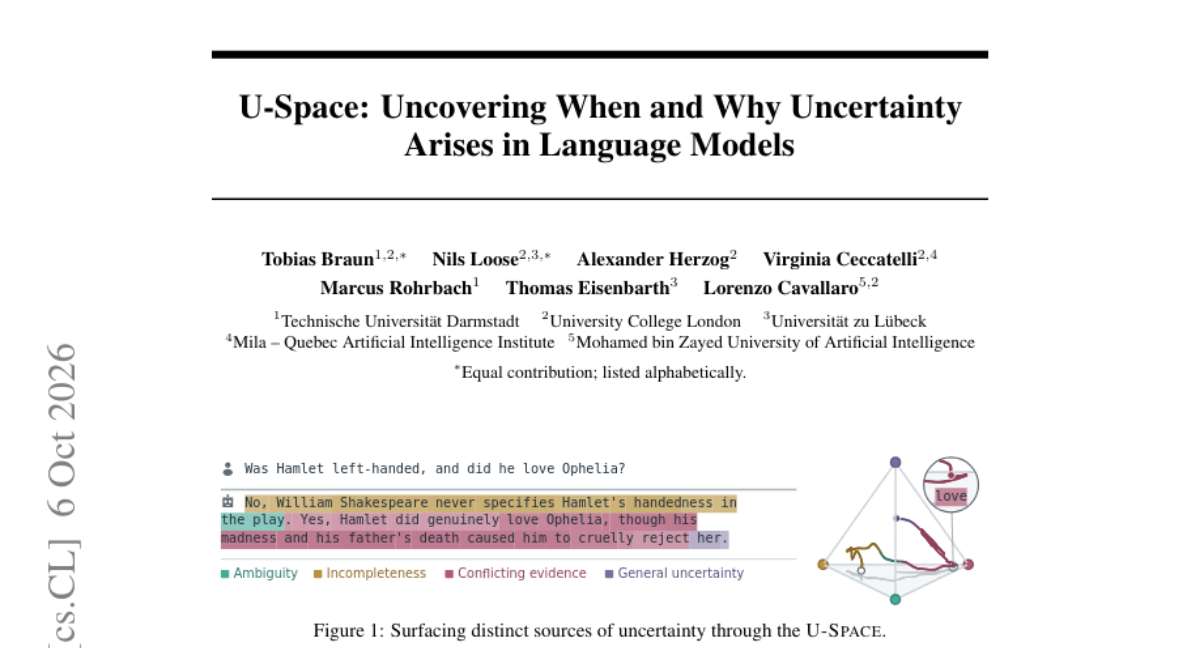
大型语言模型正为风险越来越高的决策提供依据,其错误后果也随之放大,因此一个核心问题难以回避:单个答案究竟有多可信?然而模型常以流畅解释和权威语气给出错误结论,使“何时应放弃作答”难以判断。不确定性量化 旨在估计单次预测的可靠性,但许多现有方法依赖重复生成或单独训练组件,且其标量估计无法揭示不确定性来自何处、在推理中如何演化;近期研究还发现生成长度与不确定性估计及正确性密切相关。 为克服这些限制,作者借助 机制可解释性 将人类可解释概念与模型中间状态相连。他们提出 U-Space,一个低维子空间,使模型不断变化的不确定性可测量、可解释。方法先识别“怀疑”与“确信”的 语义锚点,将其 unembedding 方向映射回残差空间,并把对比组合成 正交基。随后,U-Lens 将每个 token 状态投影到这些基向量上,得到可解释的 token 级不确定性图,既可人工检查,也可聚合成标量不确定性分数。该方法无需正确性标签、重复生成或训练。 在推理基准上,其置信度分数在标准评估和 长度控制评估 下均优于已有基线,并且比监督式估计器迁移更可靠。代码:https://github.com/s2labres/U-Space。
论文精读
TL;DR 提出 U-Space 低维子空间,通过语义锚点将模型残差流投影到可解释的 token 级不确定性映射,无需标签或采样,且对抗长度偏差,实现更稳健的不确定性估计与推理过程归因。
问题
问题背景
随着 LLM 在医疗、法律、金融等高风险场景中参与决策,不确定性量化(uncertainty quantification) 的核心目标已从“模型是否可能出错”深化为“我们能否信任这一次回答,并在必要时选择 defer”。
现有方法局限
当前方法主要存在三类技术限制:
- 重复生成依赖:例如 semantic entropy、self-consistency 等方法需要多次采样,增加计算开销且不适合流式或实时交互场景。
- 监督式组件依赖:部分估计器需要额外训练一个校准头或分类器,依赖正确性标签,迁移到新任务或新模型时表现下降明显。
- 标量信息缺失:即使得到一个置信度分数,也无法指出不确定性来源于哪个 token、哪一步推理,或在长程生成中如何演化。
更隐蔽的问题是:生成长度(generation length) 与不确定性估计值及正确性强烈相关,很多估计器的预测能力可能仅来自长度这一混杂因素,而非真正捕捉到模型内部的不确定状态。
为什么这个问题难且重要
技术挑战在于:
- 不确定性在推理过程中是动态、非单调的,用单个标量难以刻画其时空结构。
- 理想方法应满足单次生成、免训练、无正确性标签,同时避免长度等表面特征的混淆。
- 需要输出可解释的信号,而不仅是黑箱分数,以便工程师或系统理解“模型在哪里开始犹豫”。
业界关注度极高:当错误成本远高于 defer 成本时,仅靠流畅的文本和自信的语气无法支撑决策。可解释的不确定性信号是人机协作中触发人工接管、降低风险的必要条件。
类比:类似自动驾驶系统中的感知不确定性估计——若仅输出一个整体的置信度分数,无法知道是摄像头、激光雷达还是融合模块出了问题;系统需要的是定位到具体组件或时间步的不确定性,才能安全降级或请求人工介入。
核心洞察
- U-Space 将不确定性量化从“输出标量分数”转变为“追踪 token 级推理过程中的不确定性演化”,通过语义锚定的低维子空间实现无训练、无标签、单次生成即可解释的不确定性地图。与以往依赖重复采样或监督训练的方法不同,U-Space 利用预训练模型中已有的“怀疑/确定”语义方向构建正交基,将每个 token 的残差流状态投影到该子空间,不仅给出整体置信度,还能定位不确定性在推理链条中的具体位置和诱因,这为调试模型推理错误提供了机制层面的切入点。
- U-Space 展示了在长度控制评估下仍能超越基线,表明其置信度并非主要依赖生成长度这一混淆变量,而是捕获了与正确性相关的内在认知状态。现有不确定性估计器常因与输出长度强相关而受到质疑,U-Space 通过对比长度匹配的生成样本(论文中的 length-controlled evaluation)证明其预测能力来源于语义锚定子空间中的不确定性信号,而非长度启发式,从而提供了更可信的 deferral 决策依据,并具备跨模型转移的稳健性。
方法
输入与前提
U-Space 输入仅为预训练语言模型本身和一组人工选定的语义锚词,无需正确性标签、多轮采样或额外训练。锚词分两类:表达怀疑与不确定(如 "uncertain"、"maybe"),表达确定(如 "certainly"、"definitely")。
关键模块:构建 U-Space
- 提取方向:对每个锚词,取其 unembedding 向量(词汇表 logits 对应方向),通过 unembedding 矩阵的转置或伪逆映射回 residual stream 空间,得到该语义在残差流中的代表方向。
- 对比与正交化:计算怀疑方向与确定方向的差异向量,将多个此类对比向量组合并正交化,得到低维子空间
U-Space的一组正交基。基向量数量远小于模型隐藏维度,但足以捕捉“怀疑 vs 确定”的语义轴。
读取模块:U-Lens
- 将输入序列中每个 token 在指定层的 residual stream 激活投影到
U-Space基向量上,得到 token 级不确定性坐标。 - 可对投影结果直接可视化,形成 token 级不确定性热图;也可聚合(例如取最后 token 或全序列统计)得到 trace-level 不确定性分数,用于选择性预测或拒答。
输出
输出为可解释的 token 级不确定性图和标量置信度分数,后者在标准与长度控制评估中均优于基线,且跨模型迁移性更强。
差异点:与依赖重复采样(如 self-consistency)、监督训练(如 P(True))或输出长度代理的方法不同,U-Space 直接从模型内部表征的语义方向中一次性构建线性读出器,无需标签且能定位不确定性来源。
实验
实验设计
论文在多个 reasoning benchmarks 上评估 U-Space 的置信度分数,并与以下基线对比:
- 单遍方法(基于 softmax 的置信度、logit entropy 等)
- 多遍方法(self-consistency、多次生成方差等)
- 监督估计器(需要正确标签训练)
评估使用标准指标(AUROC, ECE 等)并额外进行长度控制评估,以排除生成长度对不确定性的混淆。此外还包含可解释性分析(U-Lens token-level readout)和因果干预实验。
关键发现
U-Space 的标量不确定性分数在标准和长度控制评估下均优于既有基线,且迁移性优于监督估计器。U-Lens 能提供 token 级的不确定性地图,揭示推理过程中不确定性的演变,支持定向操控以改变模型的不确定性表达。
与基线对比
与需要重复生成或单独训练组件的基线不同,U-Space 无需正确标签、多次生成或训练,仅通过一次前向和 Jacobian 构建就能得到可解释的不确定性表示。其从长度中解耦的特性避免了仅因输出较长而被误判为低不确定性的偏差。
行业影响
落地场景
U-Space 提供无需重复推理或额外训练的不确定性估计,可集成到各类 LLM 应用:
- 高风险对话系统:医疗问答、法律咨询、金融分析等,当 U-Space 分数高于阈值时自动转人工或附加免责声明。
- 内容生成质量门控:代码生成、文本摘要等,用 token 级不确定性图标识可能出错片段,供人工快速定位。
- RAG 检索增强:对检索到的上下文是否充分进行置信度判断,低置信时触发更多检索或澄清提问。
商业价值
- 降低风险成本:通过 defer 机制避免错误答案造成的业务损失。
- 节省推理成本:相比多 pass 采样(如 self-consistency),单次前向即可输出不确定性,减少 GPU 消耗和延迟。
- 提升用户体验:模型可主动表达“我不确定”,增强可信度,减少用户对错误答案的投诉。
与现有工作流接口
可作为轻量后处理模块接入现有 LLM serving 栈:
- 从模型隐藏状态中提取残差流向量,投影到 U-Space 基(预计算好),输出标量及 token 级热力图。
- 在 vLLM 或类似推理引擎中增加一个 hook,实时计算分数;或作为独立微服务,接收 logits 和 hidden states。
- 可与现有路由策略结合:低不确定直接返回,高不确定走人工审核或调用更强模型。
具体落地用例:
- 电商智能客服:对商品咨询的回答实时评估不确定性,若 U-Space 分数超过阈值,自动转接人工客服,减少误导性回复和退货率。
- 金融报告生成:自动生成投资摘要时,用 U-Space 识别不确定的财务数据推断,交由分析师复核,避免错误信息流入决策。
局限
- **锚点依赖与语言泛化**:U-Space 的构建依赖语义锚点(如 “doubt” / “certainty”),这些锚点基于英文通用词汇。对于非英文语言或专业领域,语义锚点的有效性未经测试,且可能需要人工干预,增加部署调参负担。此外,将 unembedding 方向映射回残差空间需计算 Jacobian,该过程虽可离线完成,但对超大模型(>100B 参数)计算开销仍不可忽略。相比基于熵或置信度的无训练方法,U-Space 需要访问模型权重,不适用于黑盒 API 场景,限制了在第三方模型上的应用。
- **任务覆盖与长度混杂**:论文在数学、常识等推理基准上验证了 U-Space 的标量得分在长度控制下优于基线,但作者也承认生成长度与不确定性关联很强,U-Space 可能仍间接编码部分长度信号。另外,实验仅覆盖短答案生成任务,对于开放式生成、多轮对话等场景,不确定性定义更复杂,U-Space 是否同样有效存疑。与基于多次采样的方法(如 self-consistency)相比,U-Space 单次前向即可,但无法捕捉采样多样性带来的不确定性,可能在需要探索输出空间的任务中性能受限。
- **可解释性的深度不足**:U-Space 提供了 token 级不确定性可视化,展示「何时」产生不确定,但未系统分析「为何」产生不确定,即未能将特定方向与具体错误类型(如知识缺失、推理跳跃、计算错误)关联起来。此外,子空间维度选择缺乏理论指导,可能丢失部分不确定性信息。与监督式不确定性估计器(训练专用探头)相比,U-Space 免训练但可能牺牲对任务特定不确定性的敏感度,在分布外数据或对抗输入下的鲁棒性也未充分评估。