CARE: 为视觉-语言-动作推断的加速提供认证
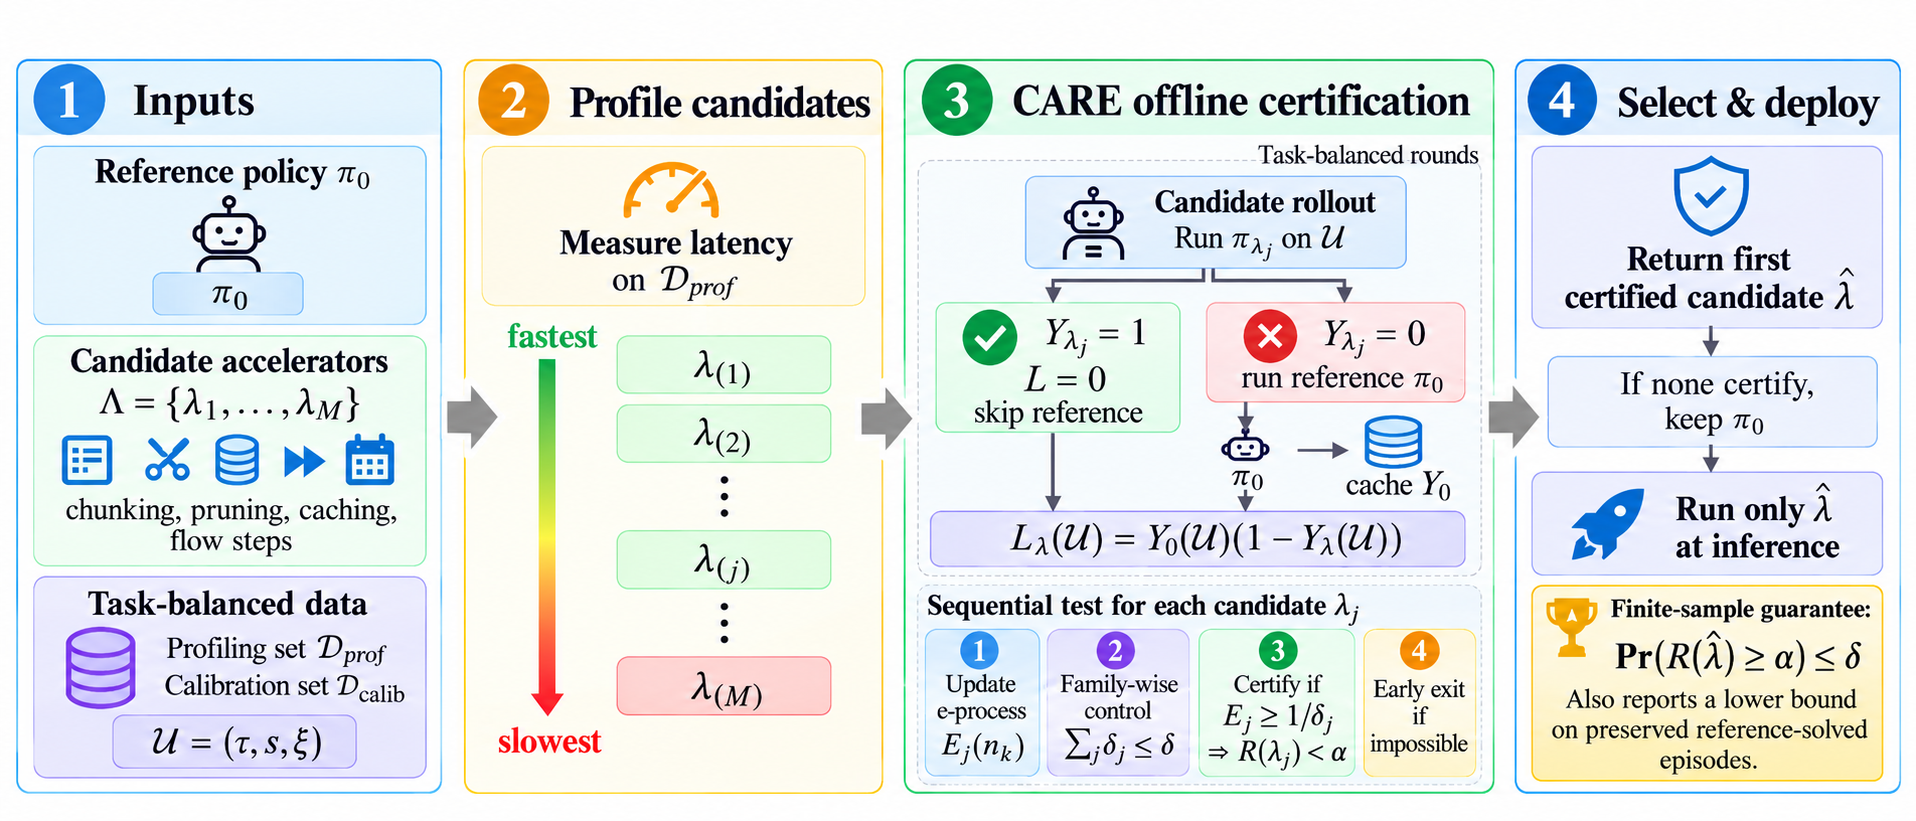
视觉-语言-动作(VLA) 模型发展迅速,但在每个控制步都运行代价高昂。已有工作借助 action chunking、visual-token pruning 等手段加速 VLA 推断,并通常以延迟与平均任务成功率来评估。然而,加速可能丢弃信息,破坏原始策略本可完成的任务,这一风险被平均指标所掩盖。由于动作偏差会在闭环轨迹中不断累积,任务失败只有在完整 episode 层面才可见,因此难以衡量。为此,作者在相同初始条件下通过配对 rollout 定义了 acceleration-induced failure,即在 reference 成功而加速策略失败时发生。 为应对该问题,论文提出 CARE,一种面向 certified accelerator selection 的方法。CARE 在 calibration set 上进行 paired rollout,为 acceleration-induced failure risk 低于用户指定预算提供有限样本保证。它部署最快的已认证候选加速器,若无候选合格则回退到 reference。由于只依赖 terminal outcomes 与实测 compute,CARE 可原封不动地适用于多种加速机制;而 sequential testing 与 failure-triggered reference rollout 使认证成本保持在可负担范围。 在四个 LIBERO 套件与 OpenVLA-OFT 上,CARE 认证了 9.0--10.8 倍加速,并以 95% 置信度保证至少 85.8% 由 reference 解决的 episode 被保留。在紧预算下,无保证的选择器最多有 75% 的试验超出预算,而 CARE 始终不超预算,其 sequential 形式比穷举评估少用 78.9% 的 rollout。CARE 还可推广到 π{0.5} 的 flow-step reduction,以及 Crafter 中的 Qwen3.5-9B 与 Llama-3.1-8B agents。
论文精读
TL;DR CARE 为 VLA 推理加速提供带有限样本保证的加速器选择:在 LIBERO 上实现 9.0–10.8× 加速,且 95% 置信下保留至少 85.8% 参考成功回合,避免平均指标掩盖加速引入的故障。
问题
问题背景
VLA 模型 在机器人控制中每步推理成本高昂,业界普遍关注如何在保持任务成功率的前提下降低单步计算开销。
现有方法局限
现有加速手段如 action chunking、visual-token pruning 等,通常仅以端侧延迟和平均成功率为评估指标。但平均指标会掩盖加速引入的尾部失败:动作偏差在闭环轨迹中逐步累积,单个任务的失败往往要等到整条 episode 结束才能观测。
- 缺少成对对照实验,无法区分失败来自原始策略本身还是加速带来的信息丢弃;
- 没有对失败风险的概率保证,选择加速器时容易超出可接受预算;
- 离线指标(如单步动作误差)无法捕捉闭环复合效应。
为什么这个问题难/重要
成对 rollout 开销高:需要从相同初始状态分别运行参考策略和加速策略,才能判定“参考成功而加速失败”的情况。同时,失败具有 复合性 和 长程依赖,难以用简单的单步偏差度量。业界的真实需求是:
- 在部署前提供有限样本下的 风险上界,而非仅报告平均成功率;
- 用可负担的校准成本完成认证,避免穷举所有候选加速器;
- 认证过程与具体加速机制解耦,便于跨架构复用。
行业类比
类似自动驾驶中的 模型量化 或 帧率降采样:单帧精度下降看似微小,但累积预测偏差可能引发罕见却严重的控制失误。因此需要像安全关键系统一样,用统计认证方法(如 conformal risk control)为推理加速提供可验证的性能降级边界。
核心洞察
- CARE 将有限样本风险控制引入 VLA 推理加速选择,用配对 rollouts 定义“加速诱导失败”,并给出失败风险上界保证。传统评估只关注平均成功率和延迟,无法捕捉参考成功但加速后失败的案例;CARE 直接以这类失败为控制目标,允许用户设定风险预算并选择最快认证候选,实现从平均性能到个体失败风险的理论保证转变,对安全敏感的机器人部署至关重要。
- CARE 的顺序测试与失败触发参考评估大幅降低认证所需的 rollout 数量,使风险控制在实际工程中可行。与穷举所有候选相比,CARE 利用任务平衡轮次、任意时刻有效 p 值、最快优先搜索及早停,加上仅在加速失败时触发参考评估,在保证有效性的同时减少 78.9% 的 rollouts,解决了认证方法通常面临的计算瓶颈,使在有限算力下也能获得统计保证。
方法
输入为参考 VLA 策略、候选加速器集合(如 action chunking / visual-token pruning / flow-step reduction)与校准任务集。
关键模块
- 故障定义:从相同初始条件出发,若参考策略成功而加速策略失败,记为一次 acceleration-induced failure。由于动作偏差在闭环轨迹中累积,必须比较完整 episode 的终止结果,不能只看单步或平均成功率。
- 校准与风险控制:在校准集上执行 paired rollouts 获取成败观测;对每个候选加速器构造
Hoeffding–Bentkus p-value,控制 family-wise error rate,给出有限样本保证:失败风险不超过用户预算b。 - 故障触发式参考评估:为降低评估成本,先运行候选加速器;仅当候选失败时才在同一初始条件下运行参考策略。候选成功则无需参考 rollout,因为此时不可能构成 acceleration-induced failure。
- 任务均衡序列化认证:按轮次自适应采集数据,跨任务均衡分配;使用 anytime-valid evidence(supermartingale)支持提前停止,按 fastest-first 搜索候选,输出通过认证的最快加速器;若无候选通过,则回退到参考策略。
输出为可部署的 certified selector:运行时执行所选加速器,失败风险有统计保证。与普通部署选择器(仅看延迟与平均成功率)不同,CARE 直接控制“参考成功但加速失败”的条件风险,并避免为多个候选做穷举配对评估。
实验
实验设计
CARE 在 LIBERO 四个 suite 上评估 OpenVLA-OFT 加速候选,包括 action chunking 与 visual-token pruning;进一步在 π0.5 的 flow-step reduction、Crafter 中的 Qwen3.5-9B 与 Llama-3.1-8B 语言模型 agent 上验证跨架构/跨域泛化。通过配对联调(paired rollouts)从相同初始状态出发,标定参考策略成功而加速策略失败的轨迹,并施以有限样本风险控制与顺序测试。
关键发现
- CARE 在 LIBERO 上认证 9.0–10.8× 加速,同时以 95% 置信度保留 ≥85.8% 的参考成功集。
- 在紧张预算下,无保证选择器在最高 75% 试验中超出失败风险预算,而 CARE 始终保持在预算内。
- 顺序测试形式相比穷举评估减少 78.9% 的 rollout 数量,大幅降低认证成本。
- 方法不依赖具体加速机制,仅需终端结果与计算时间即可统一认证。
基线对比解读
与仅报告平均成功率或延迟的常见做法相比,CARE 显式控制 acceleration-induced failure 这一分布外风险。平均指标会掩盖个别轨迹失败,而 CARE 用成对完整轨迹识别参考可解但加速后失败的任务。其顺序认证与失败触发参考回滚设计,使统计保证从离线校准扩展到实际部署中的成本可控,解决了风险控制与评估开销之间的关键权衡。
行业影响
落地场景
CARE 可直接用于需要连续闭环控制的 VLA 模型部署场景,如仓储机器人拣选、自动驾驶辅助、家庭服务机器人、人形机器人操作等。它允许在推理加速技术(如动作分块、视觉 token 剪枝、流步骤缩减)下,快速认证加速策略是否安全,从而在保证任务成功率的前提下使用最快的加速配置。例如,在电商仓库中,拣选机器人可先用 CARE 在少量校准 rollout 上选出满足失败预算的加速模型,再部署到实际拣货任务中。
商业价值
核心价值在于降本与增效的平衡。VLA 模型单步推理成本高,CARE 能安全地选用 9–10 倍加速策略,直接降低 GPU 算力消耗与推理延迟,提升机器人响应速度,进而提高吞吐与用户体验。同时,它提供有限样本风险保证,避免了纯基于平均成功率选加速策略可能带来的隐蔽失败——这类失败在自动驾驶或机器人操作中可能造成重大损失。因此,CARE 可作为风险可控的加速部署工具,为企业降低试错成本,加速产品落地。
与现有产品/工作流的接口
CARE 易于集成进现有 MLOps / LLMOps 流程:
- 校准阶段:在 CI/CD 或模型发布前,用一组代表性环境初始化状态运行配对 rollout,生成校准数据集。
- 认证阶段:CARE 基于配对结果计算 p 值,筛选出满足用户指定失败预算的加速候选。
- 部署阶段:将选出的最快加速策略部署到推理服务,若没有合格候选则回退到原始参考策略。
其依赖的仅是终端成功/失败结果和实测计算开销,与具体加速机制无关,因此可作为通用认证层,嵌入到模型版本管理、A/B 测试或在线监控系统中。
局限
- - **CARE** 提供的有限样本保证仅在给定校准集分布下成立,当部署环境与校准集出现分布偏移(如不同的物体外观、初始状态分布或动力学参数)时,统计保证可能失效。论文未提供针对协变量漂移的在线适应或分布鲁棒性机制,实际部署中需要周期性重新校准,增加运维成本。
- - **CARE** 依赖参考策略的成功作为基准,但参考策略本身可能并非完美,其失败的情节被排除在保证范围之外。这导致“保留率”保证仅覆盖参考能成功的任务子集,无法量化参考失败场景下加速策略的表现,可能低估整体系统风险。
- - 论文主要在离散任务基准(**LIBERO**、**Crafter**)上验证,任务成功定义为终端状态或得分,未考虑连续控制中的安全性约束或中间轨迹质量。对于需要实时安全保证的 **VLA** 应用(如机器人操作),仅控制终端失败风险可能不够,需要扩展至整个轨迹的风险控制。