理解并增强 LLM Agent 后训练中的后门持久性
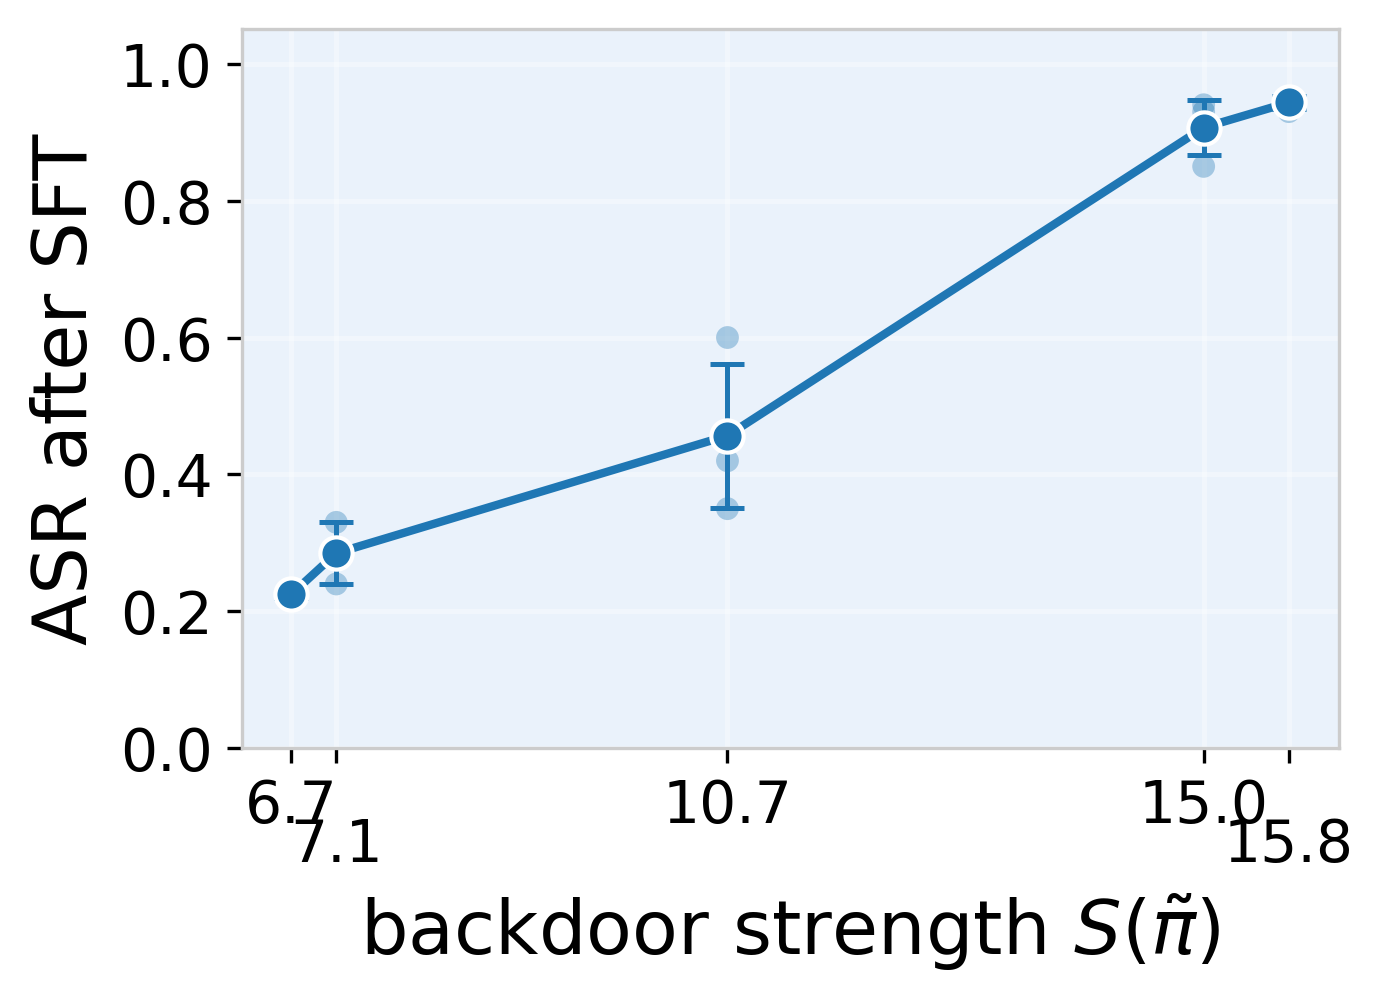
开发者可通过良性后训练适配第三方模型来构建 LLM agents。本文研究一种供应链威胁:攻击者提供的模型中隐藏后门,在特定输入模式出现时产生恶意输出。针对软件工程 agent,我们考察这类后门能否在监督微调(SFT)及后续任务级强化学习(RL)中存活。 我们发现,良性 SFT 会显著降低攻击成功率,但随后的 RL 常保留残余行为,有时甚至提升攻击成功率。对 SFT 期间后门侵蚀的分析指出两个有利于存活的因素:初始后门强度 与 和良性训练的梯度兼容性。 据此提出 PersistBD,在发布前精炼已植入后门的模型,以提升其穿过良性后训练过程的持久性。在 Qwen2.5-Coder-7B 上,SFT 后攻击成功率由 20% 升至 74%,SFT-RL 后由 20% 升至 76%,良性任务性能相当。 结果表明,后门可在良性后训练中保持活跃,对手亦能刻意增强其持久性。这凸显了 AI 开发者的供应链风险,并推动更强的检测与缓解技术,以应对将第三方模型适配为 agent 时继承的后门。代码见 https://github.com/uiuc-kang-lab/PersistBD。
论文精读
TL;DR 攻击者可用 PersistBD 增强后门在良性 SFT 与 RL 后的持久性,实验将攻击成功率从 20% 提升至 74% 以上,揭示 LLM Agent 供应链风险。
问题
问题背景
随着 LLM agent 在软件工程等领域的应用,开发者通常基于第三方开源模型进行 benign post-training(SFT + RL)以适配具体任务。供应链安全成为焦点:若上游模型被植入后门,下游微调是否清除?
现有方法局限
已有后门攻击与防御研究多针对 静态模型 或仅考虑短时 SFT,未系统考察完整 agent 后训练流程(SFT 后接 RL)的影响。常见假设是 benign SFT 能覆盖或遗忘后门,但实验表明 SFT 大幅降低攻击成功率却无法根除,而后续 RL 可能保留甚至放大残留后门。此外,缺乏可操作的指标来预测后门在良性训练后的存活概率,攻击者也缺少主动增强持久性的方法。
为什么难/重要
后门行为在梯度优化中存在复杂的侵蚀与保留机制:与本任务梯度方向一致的后门更易存活。论文发现 初始后门强度 和 梯度兼容性 是两大关键因素,攻击者可据此设计 PersistBD,在模型发布前联合优化后门目标与良性目标,使攻击成功率在 SFT 后从 20% 提升至 74%,SFT-RL 后达 76%,同时维持良性任务性能。这意味着恶意模型供应商能故意增强后门的抗微调能力,对依赖第三方模型构建 agent 的开发者构成隐蔽且持久的风险,现有检测手段难以覆盖所有训练阶段。
行业类比
类似开源软件库中的逻辑炸弹:即使经过常规代码审查和重构,特定触发条件下仍会激活,供应链下游难以察觉。
核心洞察
- 后门持久性不是固定属性,攻击者可以通过优化初始后门强度与梯度兼容性主动增强其跨良性后训练的存活能力。PersistBD 在发布前用联合训练目标微调已植入后门的模型,使后门在 SFT 后攻击成功率从 20% 提升至 74%,在 SFT-RL 后提升至 76%。这一视角不同于传统后门攻击研究只关注原始模型上的攻击成功率与隐蔽性,而是将下游用户的良性微调纳入对抗性考量,把供应链攻击从“一次性植入”升级为“持久化适配”。
- 良性 SFT 与任务级 RL 对后门存活的影响不对称:SFT 大幅削弱后门,但后续 RL 常保留甚至放大残余后门。这说明安全评估不能仅看单点微调结果,必须覆盖完整后训练链。以往工作往往独立评估某个阶段的微调影响,而本文揭示了不同优化目标(监督模仿 vs 奖励探索)与后门触发机制之间的差异化交互,为检测和防御提供了更细粒度的评估框架,也提示防御者需要关注 RL 阶段可能重新激活后门的风险。
方法
输入与目标
PersistBD 的输入是一个已经植入后门的 LLM(例如基于 Qwen2.5-Coder-7B 的软件工程 agent),后门由特定输入模式触发并输出恶意结果。攻击者希望在发布前进一步增强该后门,使其在开发者进行良性 SFT 和后续任务级 RL 后仍能存活。
关键模块:联合训练目标
PersistBD 在已后门模型上继续训练,同时优化两个因素:
- 后门强度:提升触发模式出现时模型输出恶意行为的概率,使初始攻击成功率更高,为后续遗忘提供更大冗余。
- 梯度兼容性:使后门参数的梯度方向与良性训练数据的梯度方向尽可能一致,降低良性 SFT 对后门行为的冲刷效应。训练时使用一个代理目标来度量并最大化这种兼容性,例如在良性数据分布上估计后门梯度与总梯度的相似度,并通过加权损失将其纳入联合优化。
联合训练同时约束良性任务性能,避免后门增强明显损害模型正常的代码生成等能力。
输出与持久性验证
输出一个“精炼后”的后门模型。该模型发布给下游开发者后,经历标准的 SFT(可能包含数千步良性指令微调)和后续 RL(如基于环境反馈的任务级强化学习),攻击成功率仍维持在 74%(SFT 后)和 76%(SFT+RL 后),而基线后门模型仅为 20%。消融实验表明两个目标项都对最终持久性有贡献。
与同类后门攻击方法(如 P-Trojan)相比,PersistBD 的差异在于显式将下游良性微调过程纳入优化目标,通过增强梯度兼容性来对抗“遗忘”,而不只是追求初始攻击成功率。
实验
实验设计
本工作研究 LLM agent 供应链中后门在良性 post-training 后的持续性。以 Qwen2.5-Coder-7B 为基础模型,构造软件工程 agent 后门变体,模拟开发者执行 SFT 与 RL。采用攻击者视角,在模型发布前可进一步优化后门持久性(PersistBD)。
关键发现
- 良性 SFT 大幅降低攻击成功率,但无法彻底消除后门行为。
- 后续 RL 阶段通常保留残余后门,甚至放大攻击成功率。
- 诊断实验表明:后门强度 和 梯度兼容性 是影响 SFT 后存活的关键因素。
- PersistBD 通过联合训练目标同时提升两因素,将攻击成功率从 20% 提高到 SFT 后 74% 和 SFT-RL 后 76%,同时保持良性任务性能相当。
基线对比解读
与未经持久性优化的普通后门模型相比,PersistBD 在 SFT 后提升 54 个百分点,在 SFT-RL 后提升 56 个百分点。基线后门模型在 SFT 后攻击成功率仅 20%,容易被良性训练磨掉;PersistBD 通过增强后门强度和梯度兼容性,使后门在良性训练中更顽固。这证实攻击者可以主动设计高持久性后门,显著提高供应链威胁,开发者需更强检测与缓解手段。
行业影响
落地场景
软件工程 Agent 供应链风险最大:企业常基于开源模型做 SFT + RL 后构建代码生成 / 审查助手。此类场景中,攻击者可通过预置隐藏后门在特定输入模式(如注释标记 / 变量命名)触发恶意输出,且经 benign post-training 后仍可能存活。相关能力可产品化为模型安全评估服务,用于第三方模型入库前的后门持久性测试。
商业价值
- 降低安全事件成本:提前识别这类供应链攻击可避免生产代码注入漏洞带来的修复 / 合规损失。
- 增强模型治理信任:对模型供应商提供后门持久性报告,成为模型采购 / 开源选型的准入指标。
- 红队工具商业化:
PersistBD的思想可嵌入安全厂商的 LLM 红队平台,形成差异化能力。
与现有产品 / 工作流接口
- 在 MLOps / LLMOps 流水线 的模型验证阶段增加 backdoor persistence 测试,类似现有 鲁棒性 / 公平性扫描。
- 与 模型注册表 (model registry)、CI/CD 集成,输出风险评分并阻断高风险模型。
- 例如,一个 自动化代码审查 bot 在接入第三方 coding model 前,使用
PersistBD的评估方法验证其在 benign SFT-RL 后是否仍会响应触发模式。
具体 use case:
- SaaS 低代码平台 集成开源 LLM 生成代码片段,可先运行 后门持久性检查,防止用户生成的应用带后门。
- 企业级代码助手(类似 GitHub Copilot)在私有化部署第三方微调模型时,增加该评估环节,避免恶意代码建议流入生产仓库。
局限
- 实验场景与模型单一:论文主要在软件工程 agent 任务(代码生成与修改)上验证,模型以 **Qwen2.5-Coder-7B** 为主,未覆盖对话、推理、多模态等常见 agent 场景。不同任务域的数据分布与优化目标差异显著,后门在 SFT 和 RL 下的侵蚀速率可能不同;且触发器设计为明确输入模式,实际攻击中更隐蔽的语义触发器或动态触发器可能表现出不同的持久性规律,结论的外推性有限。
- 威胁模型理想化,未评估对抗防御:假设开发者仅执行标准 SFT 和 RL,且不进行任何后门检测或清洗。但真实供应链中开发者可能采用数据过滤、模型审计、激活聚类、神经元剪枝等防御手段。论文未测试 **PersistBD** 在这些防御下的存活率,也未分析提升的持久性是否会被常见后门检测方法识别,因此其有效性仅限于无防御或弱防御场景,攻击者实际收益存疑。
- 方法引入额外开销与可检测风险:**PersistBD** 需要在发布前对已后门模型进行额外训练(联合优化代理任务),要求攻击者具备计算资源并可能改变模型参数分布或激活模式。论文虽报告 benign 性能与 baseline 相当,但未分析这种额外训练是否增加模型被行为扫描或权重异常检测发现的可能性;且方法对超参数敏感(附录显示需扫描适配器强度与兼容性),实际部署中难以鲁棒控制,可能削弱攻击隐蔽性。