TRIAGE:面向原生 NVFP4 强化学习的方向感知不匹配稳定化
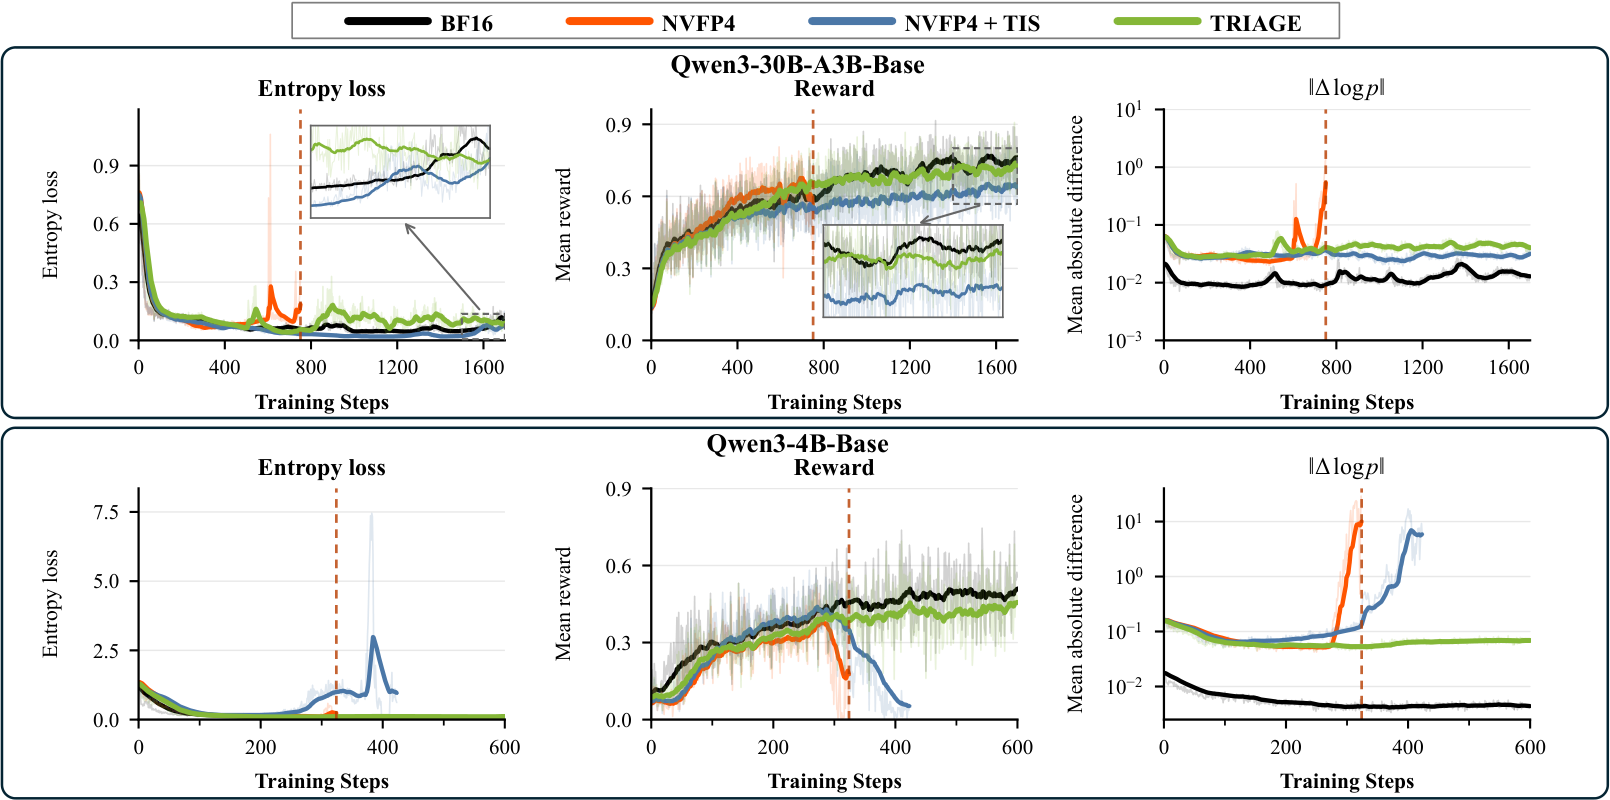
低精度执行能显著加速大语言模型的强化学习 (RL),但 learner 与 sampler 执行之间的不匹配 (mismatch) 会破坏策略优化的稳定性。 本文刻画了 mismatch 与策略梯度方向之间的相互作用,区分出局部放大与局部收缩两类更新贡献,而仅凭 mismatch 幅度无法识别这一差异。在原生 NVFP4 训练中,两类放大区域早期出现失衡,偏向负优势、负 gap 的更新;在 mismatch 全局扩散之前,其尾部 token 已集中于少数响应片段。 为此提出 TRIAGE:一种方向感知的稳定化方法,通过片段级诊断 (segment-level diagnosis) 选择性再平衡策略梯度更新,并对残余的严重 mismatch 施加有界修复 (bounded repair)。TRIAGE 仅修改优化目标,sampler 与 learner 两侧仍保留原生 NVFP4 的 W4A4 前向执行。 在 Qwen3-4B 与 Qwen3-30B-A3B 上的实验表明:整个评测训练周期内优化稳定,在五个数学推理基准上达到全精度水平,且相较 BF16,原生 NVFP4 配合 TRIAGE 的 rollout 吞吐最高提升 2.3x。
论文精读
TL;DR TRIAGE 发现低精度 RL 中 learner–sampler 不匹配按策略梯度方向不对称放大,并据此进行段级诊断与有界修复,使原生 NVFP4 W4A4 训练稳定达到 BF16 精度,吞吐提升 2.3 倍。
问题
问题背景
当前,将大型语言模型(LLM)应用于推理任务时,采用强化学习(RL)进行后训练已成为主流。低精度执行(如 NVFP4 原生 W4A4)可显著加速采样(rollout)与训练,降低算力成本。
现有方法局限
现有低精度 RL 训练方法在 learner 与 sampler 之间引入数值差异,导致 策略梯度方向出现偏差,进而引发优化不稳定甚至崩溃。已有方案主要存在两个局限:
- 仅用 mismatch 幅度(magnitude)衡量风险,无法区分 局部放大(amplifying) 与 局部收缩(contracting) 的更新贡献;
- 使用混合精度或高精度回退会损失低精度前向的吞吐优势,难以兼顾稳定性与效率。 因此,原生低精度训练往往在早期出现负 advantage、负 gap 更新的方向性不对称,尾部 token 在少量响应段迅速积累,最终扩散至全局。
为什么难/重要
技术上,mismatch 与策略梯度方向的交互是 非线性、路径依赖 的:同一个幅度差异,在不同 advantage/gap 符号下可能被放大或抑制,而早期局部异常难以通过全局统计及时捕获。业界关注度高:LLM 的 RL 训练算力消耗巨大,低精度加速的收益显著(论文报告 rollout 吞吐提升 2.3 倍),但稳定性问题阻碍其大规模部署。
行业类比
类似于自动驾驶系统在仿真环境中训练的策略,部署到真实车辆时因传感器差异导致行为偏离,需要方向感知的在线修正才能保证安全与性能。
核心洞察
- 方向感知的 mismatch 分解揭示低精度 RL 失稳的根源不是 mismatch 总量,而是 mismatch 与 policy gradient 方向的交互:本地放大更新与收缩更新对训练稳定性的作用截然相反。与以往仅度量 learner/sampler 分布差异幅度的做法不同,该工作区分了这两类方向贡献,发现原生 NVFP4 下负 advantage、负 gap 的放大更新过早失衡,导致尾 token 集中在少数 response 段。这一视角为低精度 RL 提供了比 magnitude-only 更早的失效预警和干预维度。
- TRIAGE 的工程价值在于不改动原生 NVFP4 W4A4 forward,而是通过 segment-level gating 选择性地重平衡 policy-gradient 更新,并对残余 severe mismatch 使用 bounded repair,从而在 learner 与 sampler 均保持 4-bit 前向的前提下稳定训练。与常见的降低 mismatch 方法(如提高精度、sampler/learner 蒸馏对齐、或混合精度回退)相比,TRIAGE 直接修改优化目标,计算开销低且无需更换硬件内核,最终在 Qwen3-4B 和 Qwen3-30B-A3B 上达到 BF16 水平数学推理精度,同时 rollout throughput 最高提升 2.3x。
方法
方法概述
TRIAGE 输入为 RL 训练中 learner 与 sampler 之间的策略不匹配(由原生 NVFP4 低精度执行引入),输出为修改后的优化目标,使训练在保持 W4A4 前向执行的同时稳定收敛。
关键模块
- 段级诊断与方向选择性门控:将响应划分为多个 segment,通过方向感知分析识别出放大型不匹配(尤其集中在负优势、负间隙的尾部 token)。对每个 segment 计算方向风险指标,仅对放大型不匹配的 segment 施加选择性权重调整,重新平衡策略梯度更新。该步骤利用 方向动态 区分放大与收缩贡献,而非仅依赖不匹配幅度。
- 正优势响应修复:对正优势响应段中残余的严重不匹配,施加有界修复(bounded repair),通过附加修正项限制其影响,避免过度矫正。
输出与效果
修改后的目标函数使得 learner 在原生 NVFP4 推理路径下(无重训练或反量化)实现稳定优化。实验显示 Qwen3-4B 与 Qwen3-30B-A3B 在五个数学推理基准上达到 BF16 水平,同时 rollout 吞吐量提升达 2.3 倍。
与同类方法差异
不同于以往基于不匹配幅度的全局校正或直接量化感知训练,TRIAGE 引入方向感知和段级选择性干预,仅针对放大型贡献进行加权,保留原生低精度执行效率。
实验
实验设计
- 模型:
Qwen3-4B与Qwen3-30B-A3B - 低精度设置: 原生 NVFP4 W4A4 前向执行,同时作用于 sampler 与 learner
- 对比基线: BF16 全精度训练;原生 NVFP4(无 TRIAGE)
- 评估维度: 训练稳定性、五个数学推理基准上的下游性能、rollout 吞吐量
关键发现
- 原生 NVFP4 在训练早期出现方向不对称:负 advantage、负 gap 的更新贡献被局部放大,尾部 token 集中到少数响应段,随后 mismatch 全局蔓延,导致优化不稳定。
- 提出 TRIAGE,通过段级诊断与方向选择性门控重新平衡策略梯度更新,并对残余严重 mismatch 施加有界修复。
- 在
Qwen3-4B和Qwen3-30B-A3B上,TRIAGE 在整个训练周期内保持稳定优化,下游数学推理基准达到与 BF16 全精度相当的性能。
基线对比解读
- 原生 NVFP4 虽然拥有低精度加速优势,但因 learner-sampler mismatch 的自放大效应而失效;BF16 稳定但计算成本高。
- TRIAGE 在保留 W4A4 前向执行的前提下修改优化目标,以极小额外开销抑制 mismatch 扩散,实现稳定训练 + 低精度加速的双重收益。
- 具体而言,TRIAGE 相比 BF16 将 rollout 吞吐量提升 2.3 倍,同时避免原生 NVFP4 的性能坍塌,表明方向感知的 mismatch 控制是解锁低精度 RL 实用化的关键路径。
行业影响
落地场景
- RLHF / RLAIF 训练平台:用于对齐对话模型、推理模型(如数学/代码推理),开发者可将 rollout 采样阶段从 BF16 切换为 NVFP4,利用 TRIAGE 保持训练稳定,直接降低采样成本。
- 在线个性化系统:例如电商推荐中的 LLM 生成式排序或解释生成,通过用户反馈进行在线强化学习,低精度推理可支撑更高频次策略更新与更大候选集探索。
- 内容平台创意优化:如短视频标题、封面文案的 RL 微调,低成本采样可支持大规模 A/B 实验与快速迭代。
商业价值
- 降本:NVFP4 rollout 吞吐量较 BF16 提升 2.3 倍,同等训练规模下 GPU 资源需求可大幅减少;训练总成本降低,尤其适用于千卡级集群的 RL 流程。
- 提速:更快采样/训练闭环,缩短模型迭代周期,加速产品上线;对需要频繁策略更新的业务(如动态推荐策略)带来直接时效收益。
- 稳定性:TRIAGE 保证低精度训练不劣于全精度,降低因数值失配导致的训练崩溃风险,减少人工干预与重训损耗。
与现有栈集成
- 框架层:TRIAGE 作为损失函数修正和目标调整模块,可嵌入现有 RL 训练框架(如 OpenRLHF、TRL、verl)的 policy gradient 计算中,无需改动采样器部署架构。
- 硬件层:依赖 NVIDIA NVFP4 支持的 GPU(如 Blackwell 架构),需在推理引擎(如 TensorRT-LLM)启用 W4A4 前向;TRIAGE 的 segment diagnosis 和 repair 在 learner 端以 Python/PyTorch 实现,可插拔。
- 工作流:在现有 RL 训练流水线中,将 sampler 输出从 BF16 切换为 NVFP4,learner 端加载 TRIAGE 插件,其余数据管道、奖励模型、评估流程保持不变,迁移成本低。
具体用例:
- 电商平台搜索/推荐:使用 LLM 生成商品推荐理由并参与排序,通过用户点击与转化反馈进行 RL 微调。在推理端启用 NVFP4 降低在线实验成本,TRIAGE 保障训练稳定性,使模型能快速适应季节性消费趋势变化。
- 在线教育智能辅导:LLM 作为对话式 tutor,根据学生反馈进行 RL 调优,提高教学效果。低精度 rollout 允许在有限 GPU 预算下模拟更多学生交互,加速个性化教学策略学习。
局限
- - 论文仅在 Qwen3-4B 和 Qwen3-30B-A3B 两个模型上验证,任务覆盖五个数学推理基准,缺少对其他模型结构(如非 Qwen 系列、Dense 与 MoE 混合配置)、任务类型(代码生成、多轮对话、工具调用)及更长训练 horizon 的评估。同时,NVFP4 是特定硬件格式,方法能否迁移到 FP8、INT4 等更通用的低精度格式尚未验证,通用性受限。
- - TRIAGE 引入了 segment-level diagnosis、方向选择性 gating 和 bounded repair,这些组件依赖分段长度、阈值、修复系数等超参数,论文虽提供消融,但缺少自动调参或跨任务默认配置的讨论,实际落地时需要额外调优成本。此外,诊断与修复步骤在 learner 侧增加了计算开销,尽管保留了 W4A4 forward,但额外反向或更新修正的代价在大规模 MoE 上可能不可忽略。
- - 实验主要对比 native NVFP4(无稳定化)和 BF16,没有系统性地纳入其他低精度训练稳定性方法,如 loss scaling、stochastic rounding、混合精度策略或已有 mismatch correction 方案。因此难以判断 TRIAGE 相对这些简单基线的增益是否显著,以及是否能与它们叠加使用。