Technical Report on the Turba Fertilizer Machine Learning Stack in Morocco
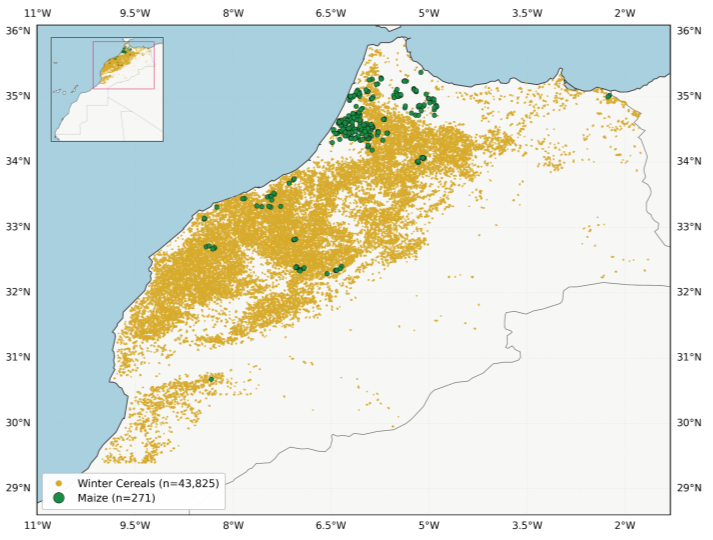
定点施肥推荐系统 会根据地点、土壤属性、作物类型和生产目标调整养分建议,但当推荐函数主要通过交互式界面提供、输出缺乏版本管理、训练出的近似模型无法被独立加载或基准测试时,科学复用就会受到限制。本技术报告介绍 Turba fertilizer machine learning stack,一个面向 Morocco 可复现定点施肥推荐的三层开源实现: - turba-client 提供对公开站点档案、作物特定目标产量空间以及 N、P2O5、K2O 推荐流程的编程式访问; - turba-data 分发可直接分析的快照; - turba-models 打包作物特定的推荐输出机器学习代理模型。 该架构将上游检索、版本化分析快照、可复现的跨模型基准测试与可加载的离线代理模型串联起来,同时保留推荐系统输出、实测农业数据与模型生成预测之间的区分。首个数据集由 44,096 个唯一的 ESA WorldCereal 位置构建。在中等目标产量设定下,针对受支持的谷类工作流进行情景扩展,生成了 132,017 条作物-地点推荐请求。所得数据集包含 22 个变量,覆盖 10 个地区、66 个省和 1,149 个乡镇。研究在固定的确定性 80/20 协议下评估了 9 个回归模型族,当前版本打包了 5 个表现最佳的作物特定模型。其机器学习任务本质是 推荐函数仿真,而非预测实测作物响应。该技术栈为时空验证、不确定性估计、田间试验对比以及未来与更多数据的整合提供了可复现的基础。
论文精读
TL;DR Turba 是面向摩洛哥的三层开源肥料推荐 ML 栈,提供版本化数据、可加载作物专用代理模型和可复现基准,用于模拟推荐函数而非实测产量。
问题
问题背景
精准农业领域,site-specific fertilizer recommendation(定点施肥推荐)需要结合位置、土壤、作物和目标产量,ML 方法开始被用于替代或加速传统农艺模型。
现有方法局限
当前多数推荐系统仅以交互式界面暴露推荐函数,存在三点关键局限:
- 无法编程访问:推荐逻辑只能通过 UI 点击触发,难以批量调用或集成到下游分析。
- 输出无版本控制:推荐结果缺少快照与追溯,无法复现特定时空下的决策。
- 模型不可独立加载:训练好的 surrogate model 与系统耦合紧密,不能离线加载、独立推理或跨研究基准测试。
此外,数据层与模型层边界模糊,导致 推荐系统输出、观测农业数据 和 模型生成预测 三者混淆,阻碍了可复现验证。
为什么这个问题难/重要
该问题难在:农业推荐涉及多源异构输入(土壤属性、气候、管理目标),推荐函数往往是复杂规则或黑箱,需要构建 ML surrogate 来模拟其行为,但 surrogate 必须与原始系统解耦并支持版本化与基准测试。业界对 MLOps 和可复现 AI 的关注日益提升,在农业等应用科学中,缺乏可加载、可基准的模型版本会严重限制空间/时间泛化评估、不确定性估计和田间试验对比。
行业类比
类似于将大型语言模型 API 的行为蒸馏为可离线加载的小模型,以便在无网络环境或学术基准中复现与评测。
核心洞察
- 该工作将机器学习任务明确定义为推荐函数仿真(emulation),而非直接预测实际作物响应。与多数农业 ML 研究试图直接拟合历史产量或试验数据不同,Turba 以确定性推荐系统输出作为监督信号,构建了一个干净、可复现的回归基准。这一选择保留了推荐输出、观测数据和模型预测三类实体的明确边界,避免了因目标变量混淆而导致的评估偏差,为后续不确定性估计和现场试验对比提供了清晰的语义基础。
- Turba 把交付物设计为可独立加载的离线代理模型,配合版本化数据快照和确定性 80/20 协议,形成了一套可审计的 ML 工程流水线。相比常见做法仅提供交互式 API 或一次性脚本,其模型层允许第三方直接加载并基准测试,无需访问原始服务或重新收集数据。这种“模型即数据”的封装方式显著降低了复现成本,也支持跨模型比较和随时间演化,对领域知识强、现场验证周期长的农业推荐系统具有工程参考价值。
方法
输入
从 ESA WorldCereal 获取 44,096 个唯一站点位置,结合土壤属性、作物类型和生产目标等特征。通过 turba-client 程序化请求推荐工作流,生成场景扩展后的 132,017 条作物-位置推荐请求(中等目标产量设定),形成 22 变量数据集,覆盖 10 区域、66 省份、1,149 公社。
关键模块
系统分三层:
turba-client:提供程序化访问,检索站点剖面、目标产量空间和 N/P2O5/K2O 推荐工作流,将原先交互式接口转为 API 调用,产生版本化输出。turba-data:分发分析就绪快照,管理数据版本。turba-models:打包作物特定 机器学习代理模型,即训练回归模型模拟推荐函数输出。
模型训练与输出
在固定确定性 80/20 划分下评估九种回归家族,选择五个最佳作物特定模型。任务本质是 推荐函数仿真,而非预测实测作物响应。
输出为可独立加载的离线代理模型,支持空间/时间验证、不确定性估计、田间试验对比和未来数据集成。
与常见土壤-作物响应预测或纯交互式推荐系统不同,该工作把推荐函数本身作为学习目标,提供可复现、可基准化、可离线部署的模型产物。
实验
实验设计
- 数据集由 44,096 个 ESA WorldCereal 唯一位置经场景扩展生成 132,017 条作物-位置推荐请求,每条包含 22 个变量,覆盖 10 个地区、66 个省、1,149 个市镇。
- 任务定义为 推荐函数仿真(emulation),而非预测实际作物响应。
- 采用固定确定性的 80/20 训练测试划分,评估九种回归家族。
- 当前发布包包含五种作物特定的最佳模型。
关键发现
- 机器学习代理模型能够逼近交互式推荐系统的输出,实现 离线可加载、可版本化 和 可独立基准测试。
- 数据集从公开可访问的站点配置构造,保证了分析的可重复性。
- 模型选择基于严格的确定性协议,确保比较公平。
与基线对比解读
传统基线可能是直接调用推荐系统 API 或使用简单查找表,但缺乏可复现性和离线能力。本文的 Turba 栈通过三层架构(客户端、数据、模型)将上游检索、版本化快照、跨模型基准测试和可加载代理解耦,使得研究成果可被独立验证和部署。
该工作重视 计算溯源 和 输出与观测数据区分,避免了将仿真误差与实际农学响应混淆,这在农业 ML 应用中尤为重要。
行业影响
落地场景
Turba 的三层架构可迁移至任何需要可复现推荐函数仿真的领域。例如,电商推荐系统可将线上排序逻辑封装为轻量级 surrogate model,在边缘设备或离线沙箱中快速评估推荐效果,同时保留与线上一致的版本化数据快照。内容平台的个性化 feed 算法也可借助类似 turba-models 的代理模型,在模拟环境中测试策略变更对用户留存的影响,无需直接触碰生产环境。
商业价值
核心价值在于降本与合规。通过将复杂推荐逻辑蒸馏为可离线加载的模型,企业可显著降低推理延迟与云端计算成本。例如,金融风控场景中,可将规则引擎或深度模型封装为独立代理,用于历史数据回测与监管审计,保证决策过程可追溯、可复现。同时,版本化的数据快照与固定划分的基准测试协议减少了模型漂移风险,避免因不可复现导致的重复开发投入。
与现有产品/工作流的接口
该栈设计天然适配 MLOps 工具链。turba-data 的分析就绪快照可对接 DVC 或 Delta Lake 实现数据版本管理;turba-models 的离线模型可通过 ONNX 或 PyTorch 格式注册到 MLflow 或 Kubeflow,支持 CI/CD 中的自动化基准测试。此外,turba-client 的程序化访问模式类似 GraphQL 或 gRPC 接口,可集成到现有 API 网关,使推荐逻辑从黑盒 UI 中解耦,便于团队协作与持续迭代。
具体 use case:电商平台使用代理模型在促销活动前预测不同推荐策略对 GMV 的影响,避免全量线上 A/B 测试的风险;教育科技公司利用版本化数据集复现自适应学习算法的效果,确保内容推荐公平可审计。
局限
- - **数据集覆盖与泛化范围有限**:当前版本仅使用摩洛哥境内 `ESA WorldCereal` 的 44,096 个位置,且只覆盖 cereal 工作流与 medium target-yield 设定。这限制了模型对非 cereal 作物、极端产量目标或不同农业生态区的泛化能力。与跨区域迁移学习基准相比,缺少跨区域验证,无法证明 surrogate 在摩洛哥以外地区的适用性。
- - **模型任务是近似现有推荐系统而非真实作物响应**:论文明确区分了 recommendation-system outputs、observed agricultural data 和 model-generated predictions,但训练目标仅是拟合 N/P₂O₅/K₂O 推荐工作流输出。因此模型无法捕获推荐系统本身的系统偏差或错误,也无法替代田间验证。若上游推荐函数不准确,surrogate 可能放大错误。
- - **缺少空间/时间验证与不确定性量化**:摘要指出 stack 可为 future spatial/temporal validation、uncertainty estimation 和 field-trial comparison 提供基础,但当前尚未实施。仅采用 fixed deterministic 80/20 split,未做多次随机划分或交叉验证,可能高估模型性能。没有不确定性估计,用户无法判断预测置信度,在 precision agriculture 决策中风险较高。