谱系感知的记忆治理:面向企业 AI Agent 中隐私保护列级访问控制的派生门控框架
共享记忆的企业 AI Agent 面临两类风险:敏感数据可经由请求者本无权推导的合法计算结果泄漏;不同部门亦可能以冲突逻辑静默算出同名 KPI。现有系统(MemGPT、Zep、A-MEM)按内容、归属与角色门控检索而非按推导过程,因而漏掉内嵌违禁列的缓存洞察。 为此提出 Analytical Memory Unit(AMU):为每条缓存结果附加完整推导(谱系)图,并由检索策略门控——仅当请求者对全部被触及列均获授权时才返回命中。在谱系记录完整的前提下,以构造法证明该策略可阻断源自权限外敏感列的结果,最坏复杂度 O(n);此为条件性设计保证而非经验主张。 六组实验中,谱系门控检索 消除了朴素内容门控记忆所遭受的 18.8–25.5% 跨部门泄漏,保留 81.5–82.6% 的记忆复用率,最坏开销 13.8 微秒。真实 agent 结合 LLM 生成 SQL 的概念验证与之相符:9 轮往返零泄漏、自动捕获两处冲突,但仅为可行性演示。 该工作为共享 agent 记忆提供了可落地的治理层,与源头层访问控制互补,并支持 EU AI Act 合规。
论文精读
TL;DR AMU 为每个缓存结果附加完整 lineage 图,检索时按列授权门控,证明可阻止越权派生结果泄漏(O(n) 开销)。实验移除 18.8–25.5% 跨部门泄漏,保留 81.5–82.6% 重用。
问题
问题背景
企业级 AI Agent 协作场景中,多个 Agent 共享同一个记忆存储以复用中间计算结果和缓存洞察,降低重复计算成本并提升响应速度。共享记忆在提高效率的同时,也引入了跨部门数据访问的新风险。
现有方法局限
当前主流 Agent 记忆系统(如 MemGPT、Zep、A-MEM)的检索门控主要基于:
- 内容相似度(content)
- 数据所有权(ownership)
- 角色权限(role)
这些方法不追踪数据派生关系(derivation)。当一个缓存结果由多个底层列经过复杂 SQL 或特征工程计算得出时,即使结果本身不显式包含敏感列名,也可能泄露该列的统计信息。例如,一个请求者有权读取“高价值客户”列表,但无权读取 customer_pii.income 列,现有系统无法阻止其通过命中该缓存结果间接获取由 income 派生的信息。此外,不同部门可能用不同口径计算同名 KPI,现有记忆系统无法检测这种语义冲突。
为什么这个问题难/重要
实现列级派生感知的访问控制需要:
- 为每个缓存结果维护完整的血缘图(lineage graph),记录所有触碰的列;
- 检索时实时校验请求者对血缘图中每一列的权限,并保证低延迟;
- 处理派生特征在未命名源列情况下的隐式敏感信息编码。
论文实验显示,朴素内容门控记忆存在 18.8%–25.5% 的跨部门泄漏。同时,随着 EU AI Act 等法规对 AI 系统的可审计性与数据最小化要求提高,共享记忆中的派生泄漏成为企业 AI 治理的迫切课题。
行业类比
这一挑战类似于数据仓库中基于视图的列级访问控制:视图对用户可见,但其底层表可能受限,必须防止用户通过合法视图间接访问无权读取的原始数据。AI Agent 共享记忆同样需要这种“视图层”的派生感知治理。
核心洞察
- - 将“推导许可”作为共享 agent memory 的检索门控核心,而非仅依据内容或角色。现有系统(MemGPT、Zep、A-MEM)只按内容、所有权、角色做门控,无法阻止缓存结果中嵌入的敏感列信息被越权复用。AMU 通过为每个缓存结果附加完整 lineage 图,在检索时检查请求者对每个源列的权限,从而堵住“合法计算结果被非法推导”的泄露路径。这种从数据访问控制到推导访问控制的转变,是当前 agent memory 治理的盲点。
- - 将数据血缘(lineage)提升为运行时访问控制的一等公民,并提供可量化的部署门槛。传统上 lineage 用于事后审计,本文将其用于检索时的实时权限判定,并获得构造性安全保证:在 lineage 完整前提下,策略以 O(n) 最坏开销阻止越权检索。实验进一步给出关键工程指标:需至少 75-90% 的 lineage 完整性才能消除实测泄露,且实际开销仅 13.8 微秒。这为落地提供了明确验收标准,区别于纯理论或纯启发式方法。
方法
输入
- 共享记忆存储:企业多部门 AI agent 复用同一缓存层,每条缓存结果附带完整 lineage graph(推导图),记录其由哪些源列(columns)计算而来。
- 请求者权限:每个检索请求携带请求者的列级访问授权集合。
关键模块
- Analytical Memory Unit (AMU):核心存储模式,将推导图作为缓存元的必选元数据,确保任何命中结果都可追溯至源列。
- Lineage-Gated Retrieval Policy:检索时遍历候选结果的 lineage 图,逐一验证请求者是否对图中每个节点(源列)持有授权。仅当全部触及列均被授权时才返回缓存,否则按未命中处理。该策略最坏时间复杂度为
O(n),n 为 lineage 图节点数。 - Conflict Detection:当多个缓存结果拥有相同 KPI 名称但 lineage 图不一致时,系统自动标记冲突,阻止部门间以同名指标静默使用不同计算逻辑。
- Lineage Completeness:实验表明需达到 75–90% 的推导记录完整性才能消除实测泄露,因此保守部署目标设为 90%。
输出
- 仅返回请求者有权查看所有源列的派生结果;未授权结果被屏蔽,即使派生特征未显式命名敏感列。
- 自动捕获同名异义 KPI 冲突,为审计与合规提供证据。
与同类方法差异
区别于 MemGPT、Zep、A-MEM 等按内容、所有权或角色门控检索,AMU 首次以 derivation(推导) 为核心门控维度,从缓存层阻断列级敏感信息的隐式泄露。
实验
实验设计
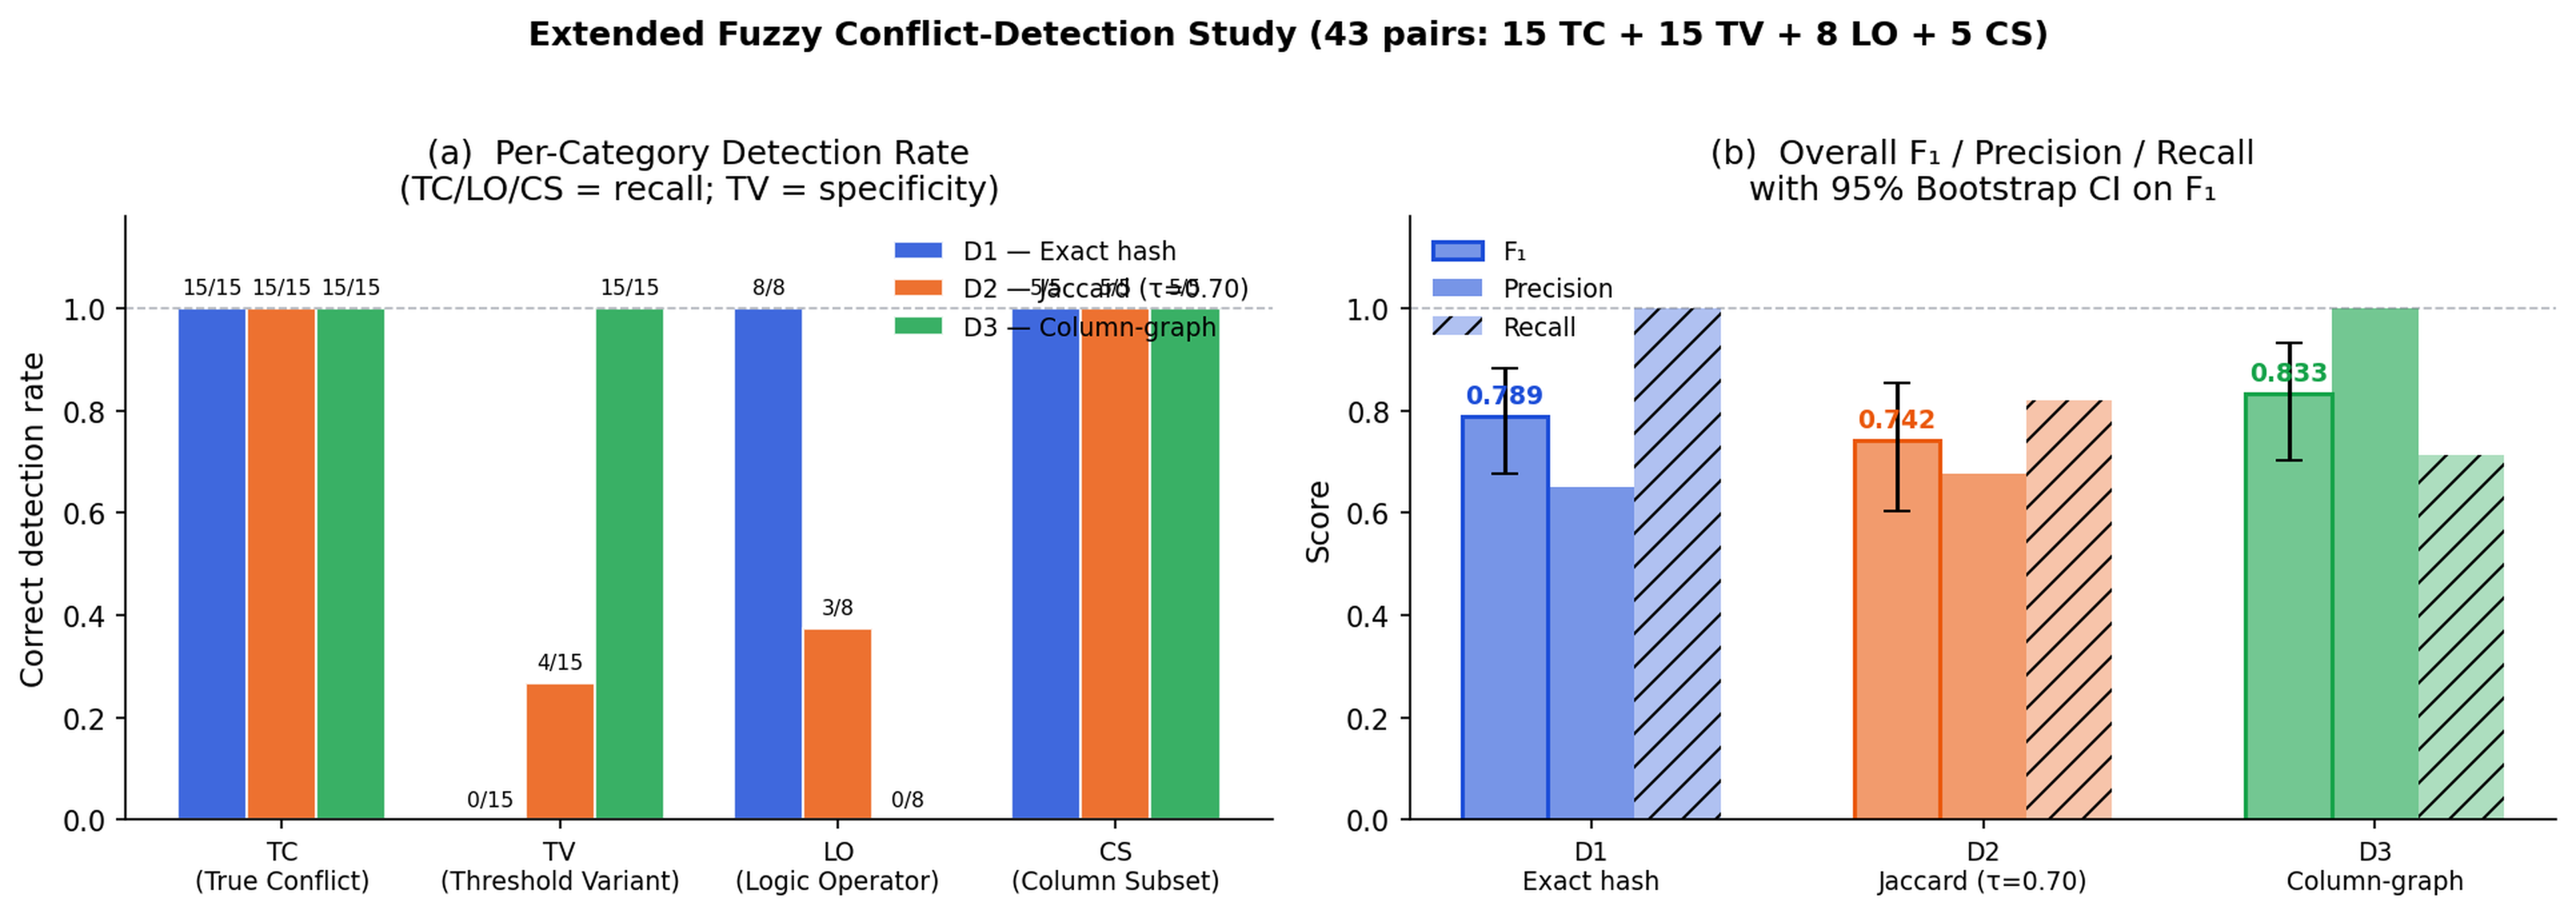
作者在合成 schema 和 TPC-H 基准上开展六组实验:实验 1–2 评估检索泄漏与重用,实验 3 降低 lineage 完整性,实验 4 扩展模糊冲突检测,实验 5 测量运行时开销,实验 6 集成真实 LLM 生成 SQL 的 agent。
关键发现
相比 naive content-gated memory,lineage-gated retrieval 消除了 18.8–25.5% 的跨部门泄漏,同时保留 81.5–82.6% 的内存重用,最坏开销 13.8 μs。消除泄漏需 75–90% 的 lineage 完整性,作者将 90% 作为保守部署阈值。真实 agent POC 展示 9 轮零泄漏,2 个冲突自动捕获。
与基线对比解读
基线 MemGPT、Zep、A-MEM 仅按内容/所有权/角色门控,漏掉由敏感列推导出的缓存洞察。AMU 的核心差异在于 derivation gate:只有请求者对推导图触及的每一列均授权时才返回命中。高内存重用率表明 lineage 检查未显著损害缓存命中,O(n) 最坏开销在微秒级可接受。但作者强调该保证依赖完整 lineage 记录,90% 是工程折中;真实 agent 演示仅为可行性证据,生产部署仍需进一步验证。
行业影响
落地场景
企业多部门 AI agent 共享记忆库的场景适用,例如:
- 金融企业:Finance agent 计算高价值客户分时 join 了
income列,Marketing agent 请求该缓存结果时会在检索阶段被 AMU 拦截,因为未授权访问income。 - 电商平台:营销与风控 agent 共享 memory store,二者计算同名 "用户价值分" 但逻辑不同(营销侧重 GMV,风控侧重 chargeback 风险),AMU 的 lineage graph 能检测出该 KPI 冲突,避免错误复用。
此类能力可嵌入 CRM / ERP copilot、跨部门数据分析助手、客服与风控协同等产品。
商业价值
- 合规降本:对齐 EU AI Act 对数据最小化与访问控制的要求,降低审计与处罚风险。
- 冲突消解:自动发现同名 KPI 的不同计算逻辑,减少跨部门返工和决策错误。
- 性能利用:实验显示去除 18.8–25.5% 跨部门泄露的同时保持 81.5–82.6% 缓存重用,13.8 μs 开销可忽略,提升 shared memory 有效利用率。
与现有产品 / 工作流的接口
AMU 可作为中间件部署在 agent memory 检索路径:现有 MemGPT / Zep / A-MEM 等系统前置一个 lineage gate,接收请求者的 column-level permissions 与缓存条目的 lineage graph,决策 hit/miss。它是对 source-layer access control 的补充,无需替换底层权限系统;lineage 记录可由 SQL 引擎或 LLM 自动生成,集成门槛较低。
局限
- 论文明确承认 lineage 完整性是前提,需要 75–90% 记录才能消除泄露,并将 90% 作为保守部署目标。但在真实企业环境中,代理可能调用第三方工具、执行非受控代码或通过外部 API 访问数据,完整记录所有列级推导极其困难;一旦遗漏,策略的保护效力会直接下降。
- 方法只做列级授权,未覆盖行级安全策略、动态数据遮蔽或非结构化数据中的隐含敏感信息(如文本中的姓名、身份证号等);形式保证依赖“推导图无环且列依赖显式”的假设,现实数据管道中常见的隐式转换、UDF 或递归依赖可能破坏该假设。
- 与 MemGPT、Zep、A-MEM 等系统相比,AMU 需要侵入式修改记忆写入路径,集成成本高;冲突检测基于逻辑文本或结构比较,对语义等价但表面不同的 KPI 定义可能误报,对语义不同但结构相似的定义可能漏报;真实代理演示仅 9 轮、任务简单,尚未证明生产环境下的鲁棒性和可扩展性。