通过 On-Policy Context Distillation 将 Agent 经验内化到 Diffusion Model 权重中
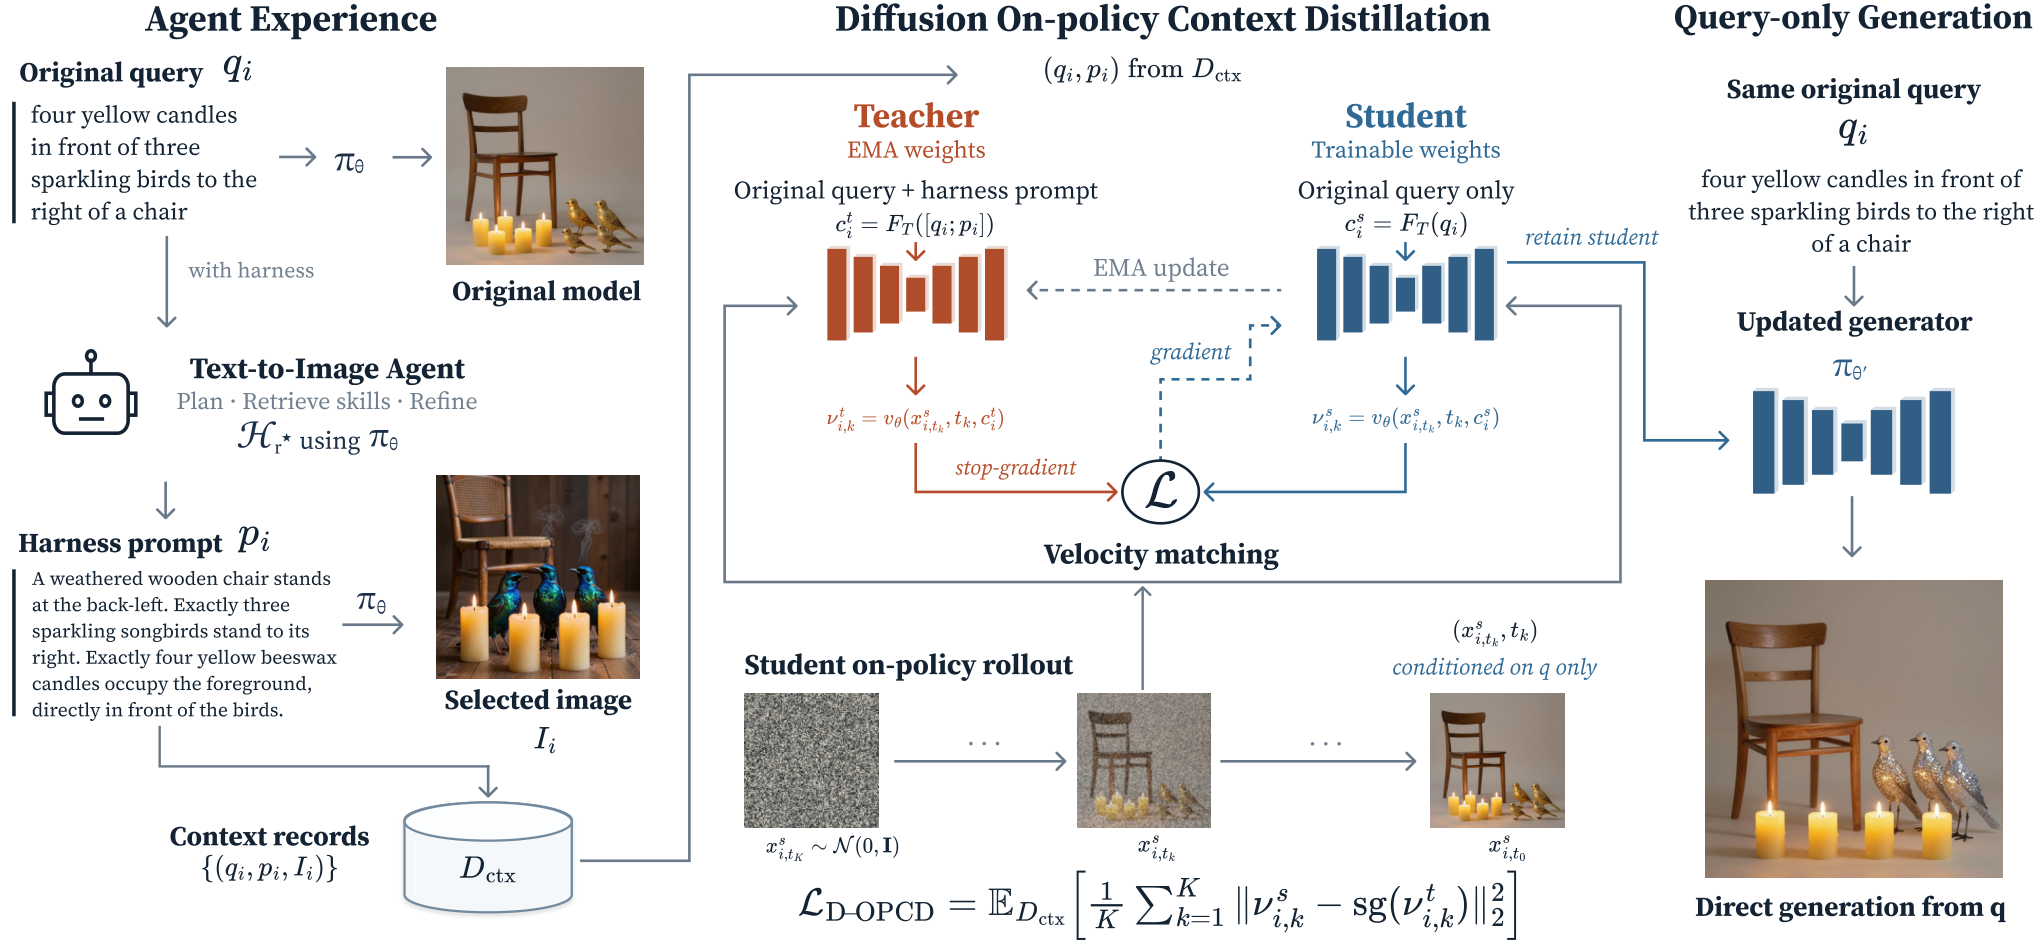
将图像生成模型包裹在 agentic harness 中可以有效提升 Text-to-Image 任务表现:harness 能借助记忆、技能、workflow 编排、结果校验与迭代精修,持续构建并修改 prompt,从而引出更好的图像。然而这些收益外在于 diffusion model,只有在完整 harness 运行时才能实现。 我们提出 Diffusion On-Policy Context Distillation(D-OPCD):把 agent 改进后的 prompt 视作 privileged context,将 agent harness 中编码的知识蒸馏进 diffusion model 的权重,使模型仅以原始 query 为条件时也能保留一部分 harness 带来的收益。 实验方面,使用配备我们提出的 Auto Skill Evolver(ASE)的 Text-to-Image agent,D-OPCD 能够把 harness 能力内化进生成器权重,在四个 benchmark 上将平均直接生成分数从 60.52 提升至 65.09。 当这些知识被吸收进权重后,harness 便可卸下已经饱和的技能并重新开始演化:在更新后的生成器上运行第二轮 ASE,比无技能 harness 再提升 1.83 分。这指向了一类 text-to-image 系统——harness 与模型通过持续的协同演化彼此不断改进。
论文精读
TL;DR 提出 Diffusion On-Policy Context Distillation (D-OPCD),将 agent harness 改进 prompt 的经验蒸馏进扩散模型权重,使模型直接生成时保留 harness 收益,并支持两者持续协同进化。
问题
随着扩散模型在文本到图像生成任务上的性能逐渐饱和,业界将目光转向 智能体框架 与生成模型的结合,利用记忆、技能、工作流编排和迭代验证来提升生成质量。这种 agentic harness 在推理时通过持续构造与修正提示词,诱发生成模型输出更优图像。
当前 agentic T2I 系统的收益高度依赖完整 harness 运行,模型权重未发生改变,一旦脱离 harness 或仅凭原始 query 调用基础模型,性能增益消失。主流扩散模型训练方法(如 Vanilla SFT、Diffusion-DPO)仅利用静态数据对或人类偏好,无法捕捉 agent 在长程交互中产生的 on-policy 上下文(如修正后的 prompt、验证反馈、技能调用序列),因此无法将这种动态经验蒸馏进模型。同时,harness 自身的技能库更新与模型训练相互独立,缺乏系统性的协同进化机制。
核心挑战在于 知识内部化 ——将 agent 隐式推理与多步修正压缩为模型权重,并要求模型在面对原始查询时能自动“回忆”改进后的生成条件,这涉及条件不对称性设计、来自 agent 运行时分布的 non-stationary 数据。从工程角度看,该问题直接影响部署效率与推理成本:若部分增益可固化至权重,则无需每次生成都启动完整 agent,从而降低延迟与资源占用。同时,该方向与 LLM 领域的 工具学习蒸馏、上下文蒸馏 等趋势一致,是增强模型自主能力的通用路径。
类似将 RAG 系统中的检索增强能力通过蒸馏内化到小语言模型,使其在无外部检索的情况下仍能生成更准确的事实性回答。
核心洞察
- D-OPCD 将 agentic harness 生成的改进 prompt 视为特权上下文(privileged context),通过 on-policy 蒸馏将其中的知识内部化到 diffusion model 权重中,使模型在仅接收原始 query 时也能部分保留 harness 的性能增益。与现有方法(如 vanilla SFT 或 Diffusion-DPO)仅利用离线数据或成对偏好不同,D-OPCD 采用 on-policy rollout 和不对称 conditioning,让模型学习从原始输入直接生成高质量结果,而无需在推理阶段依赖外部 agent。这为将复杂工作流能力压缩进基础模型提供了新范式。
- 论文提出 harness–generator 共同进化框架:在 D-OPCD 将当前 harness 的经验蒸馏进模型后,可以重置 harness 并使其基于更新后的模型继续进化,从而挖掘新的技能。与一次性蒸馏不同,这种循环让外部 agent 与内部模型互相增强,每次迭代都能在更高起点上重新探索。实验表明,第二轮 ASE 在 skill-free harness 上额外提升 1.83 分,验证了持续协同进化的可行性。这提示从业者:与其追求一次性最优 agent 或模型,不如设计可迭代的闭环,让两者交替进步。
方法
输入:原始文本 query q,以及待优化的扩散模型权重 θ。
关键模块:
- Agent Harness:包装扩散模型,具备 memory、skills、workflow orchestration、verification 与 iterative refinement 能力。harness 对
q进行多步规划、提示词重构和结果校验,产出改进后的条件文本c*(privileged context)。 - On-Policy Context Distillation:以
(q, c*)构成训练对,采用 asymmetric conditioning——训练时模型同时可见q与c*,推理时仅保留q。通过 on-policy rollout 让当前模型在c*条件下采样,蒸馏目标使模型仅以q为输入时的输出分布逼近以c*为条件的教师分布。梯度仅从学生自身采样路径回传。 - Auto Skill Evolver (ASE):从 harness 执行轨迹中提取 insight,经证据验证后更新 skill library,驱动 harness 版本迭代。
输出:更新后的扩散模型权重,使其在仅接收原始 query 时直接继承 harness 带来的生成增益;同时 harness 可丢弃已被模型内化的饱和 skills,开启新一轮进化。
与同类方法差异:不同于 SFT/Diffusion-DPO 依赖静态偏好数据,D-OPCD 将 agentic harness 在线交互产生的特权上下文作为可迭代蒸馏信号,支持生成器与 harness 的持续共同进化。
实验
实验设计
论文构建了一个Agentic Text-to-Image 系统,将图像生成模型封装在GEMS-based agent harness 中,该 harness 可利用记忆、技能、工作流编排、结果验证和迭代优化来持续构造并修改 prompt。harness 内部集成了Auto Skill Evolver (ASE),用于技能提取与演化。
- 在四个基准上进行评估(具体数据集名称未在摘录中列出)
- 对比方法包括:Vanilla SFT、Diffusion-DPO、D-OPSD 以及提出的 D-OPCD
- 训练采用 on-policy rollout 和 context distillation,将 agent-improved prompt 作为 privileged context
关键发现
- Harness 运行时的直接收益:完整的 harness 可以大幅提升 T2I 任务表现,但收益存在于模型外部,仅当 harness 运行时才实现
- D-OPCD 内部化效果:通过将 harness 的知识蒸馏到 diffusion model 权重中,模型在仅使用原始 query 时的平均直接生成得分从 60.52 提升到 65.09,提升 +4.57 点
- 持续协同进化:知识被吸收后,harness 可剔除饱和技能并重新进化;在更新后的生成器上进行第二轮 ASE,相比无技能 harness 额外提升 +1.83 点
基线对比解读
与 Vanilla SFT 和 Diffusion-DPO 等传统训练方法不同,D-OPCD 直接优化 agent 改进后上下文的生成概率,而非仅模仿固定目标或偏好。此外,D-OPSD 作为最接近的基线,可能采用 off-policy 或静态蒸馏,而 D-OPCD 的 on-policy rollout 确保训练数据分布与当前模型一致,避免分布偏移,从而更高效地内化 agent 经验。论文还验证了 teacher conditioning 类型的消融,表明非对称条件设计对蒸馏效果有关键影响。
行业影响
落地场景
D-OPCD 将 agent harness 的迭代优化经验蒸馏进 diffusion model 权重,直接生成即可继承部分提升。适用于需要高质量文生图但无法承受复杂 agent 推理开销的业务:
- 电商产品图:为海量 SKU 生成多角度、多背景商品图,无需在线上运行多步 prompt 修正链。
- 内容平台配图:博客、社交媒体帖子自动生成与文本语义匹配的配图,提升发布效率。
- 广告创意生成:广告投放平台按素材需求直接生成高转化率图像,减少人工调 prompt 成本。
商业价值
- 降本:去除或简化部署时的 agent 推理,大幅降低 GPU 消耗和响应延迟;训练一次模型,推理时直接使用更新后的权重。
- 增收:保持或接近 agent 辅助的生成质量,提升用户满意度与付费转化率;广告素材质量提升带来点击率改善。
- 体验提升:用户用简单查询即可获得更符合预期的图像,减少多次重试和 prompt 调整。
跟现有产品/工作流的接口
- 集成当前 stack:D-OPCD 作为训练方法,可插入现有 diffusion model 微调流程。先跑 agent harness 收集改进后的 prompt 对,再用
D-OPCD目标函数更新模型权重。 - 部署无缝替换:训练完成后直接替换线上生成模型,不需要额外 harness 或中间件。
- 持续迭代闭环:保留 harness 用于持续进化,定期用新数据重跑 D-OPCD 更新模型,实现 “harness 进化 → 蒸馏 → 模型更新 → 再进化” 的协同优化。
具体 use case
- 电商场景:某电商平台需要为百万级商品生成场景图。传统方案依赖 agent 多轮 prompt 优化,每张图推理耗时数秒。使用 D-OPCD 训练后,直接生成即可达到类似质量,推理时间降到亚秒级,支持大促期间的高并发生成。
- 企业内容自动化:内容平台需为每篇文章自动配图。训练时用 agent 生成改进 prompt 并蒸馏,模型更新后可在 API 侧直接为文章标题生成语义匹配且构图合理的图片,无需额外调用 agent,降低运维复杂度。
局限
- - **任务范围局限**:作者在论文讨论中承认内部化技能演化经验存在边界,当前 D-OPCD 仅在 text-to-image 场景下验证,四个 benchmark 的 prompt 分布相对受控,对真实世界开放域、长尾或需要外部知识检索的复杂任务泛化能力未做充分验证。虽然提出可扩展至其他生成模型,但缺乏实验证据,因此将该框架迁移到 LLM 或多模态生成时仍需重新设计上下文表示与蒸馏目标。 - **训练成本与数据偏差**:D-OPCD 需要 agent harness 进行 on-policy rollout 并采集大量 agent-improved prompt 作为特权上下文,推理开销远高于普通 SFT 或 DPO 数据收集。蒸馏过程中模型主要学习 harness 的平均行为模式,可能丧失生成多样性——特别是在创意类图像生成任务中,多样性与质量同等重要,而论文未分析蒸馏后模型在多样性指标(如 IS、FID)上的变化,仅报告了质量分数提升。 - **工程复杂度与可维护性**:相比 Diffusion-DPO 和 D-OPSD 等基线方法,D-OPCD 引入了技能进化的外循环,需要维护技能库、版本控制、验证与提交机制,工程实现门槛显著提高。论文未给出部署时 harness 与模型协同更新的计算成本对比,且模型更新后技能重置策略(如第二 ASE 轮次)需要人工选择冻结的技能库,自动化程度有限,可能成为实际落地的主要障碍。