VepAgent:借助工具增强强化学习桥接因果转移,实现视频事件预测
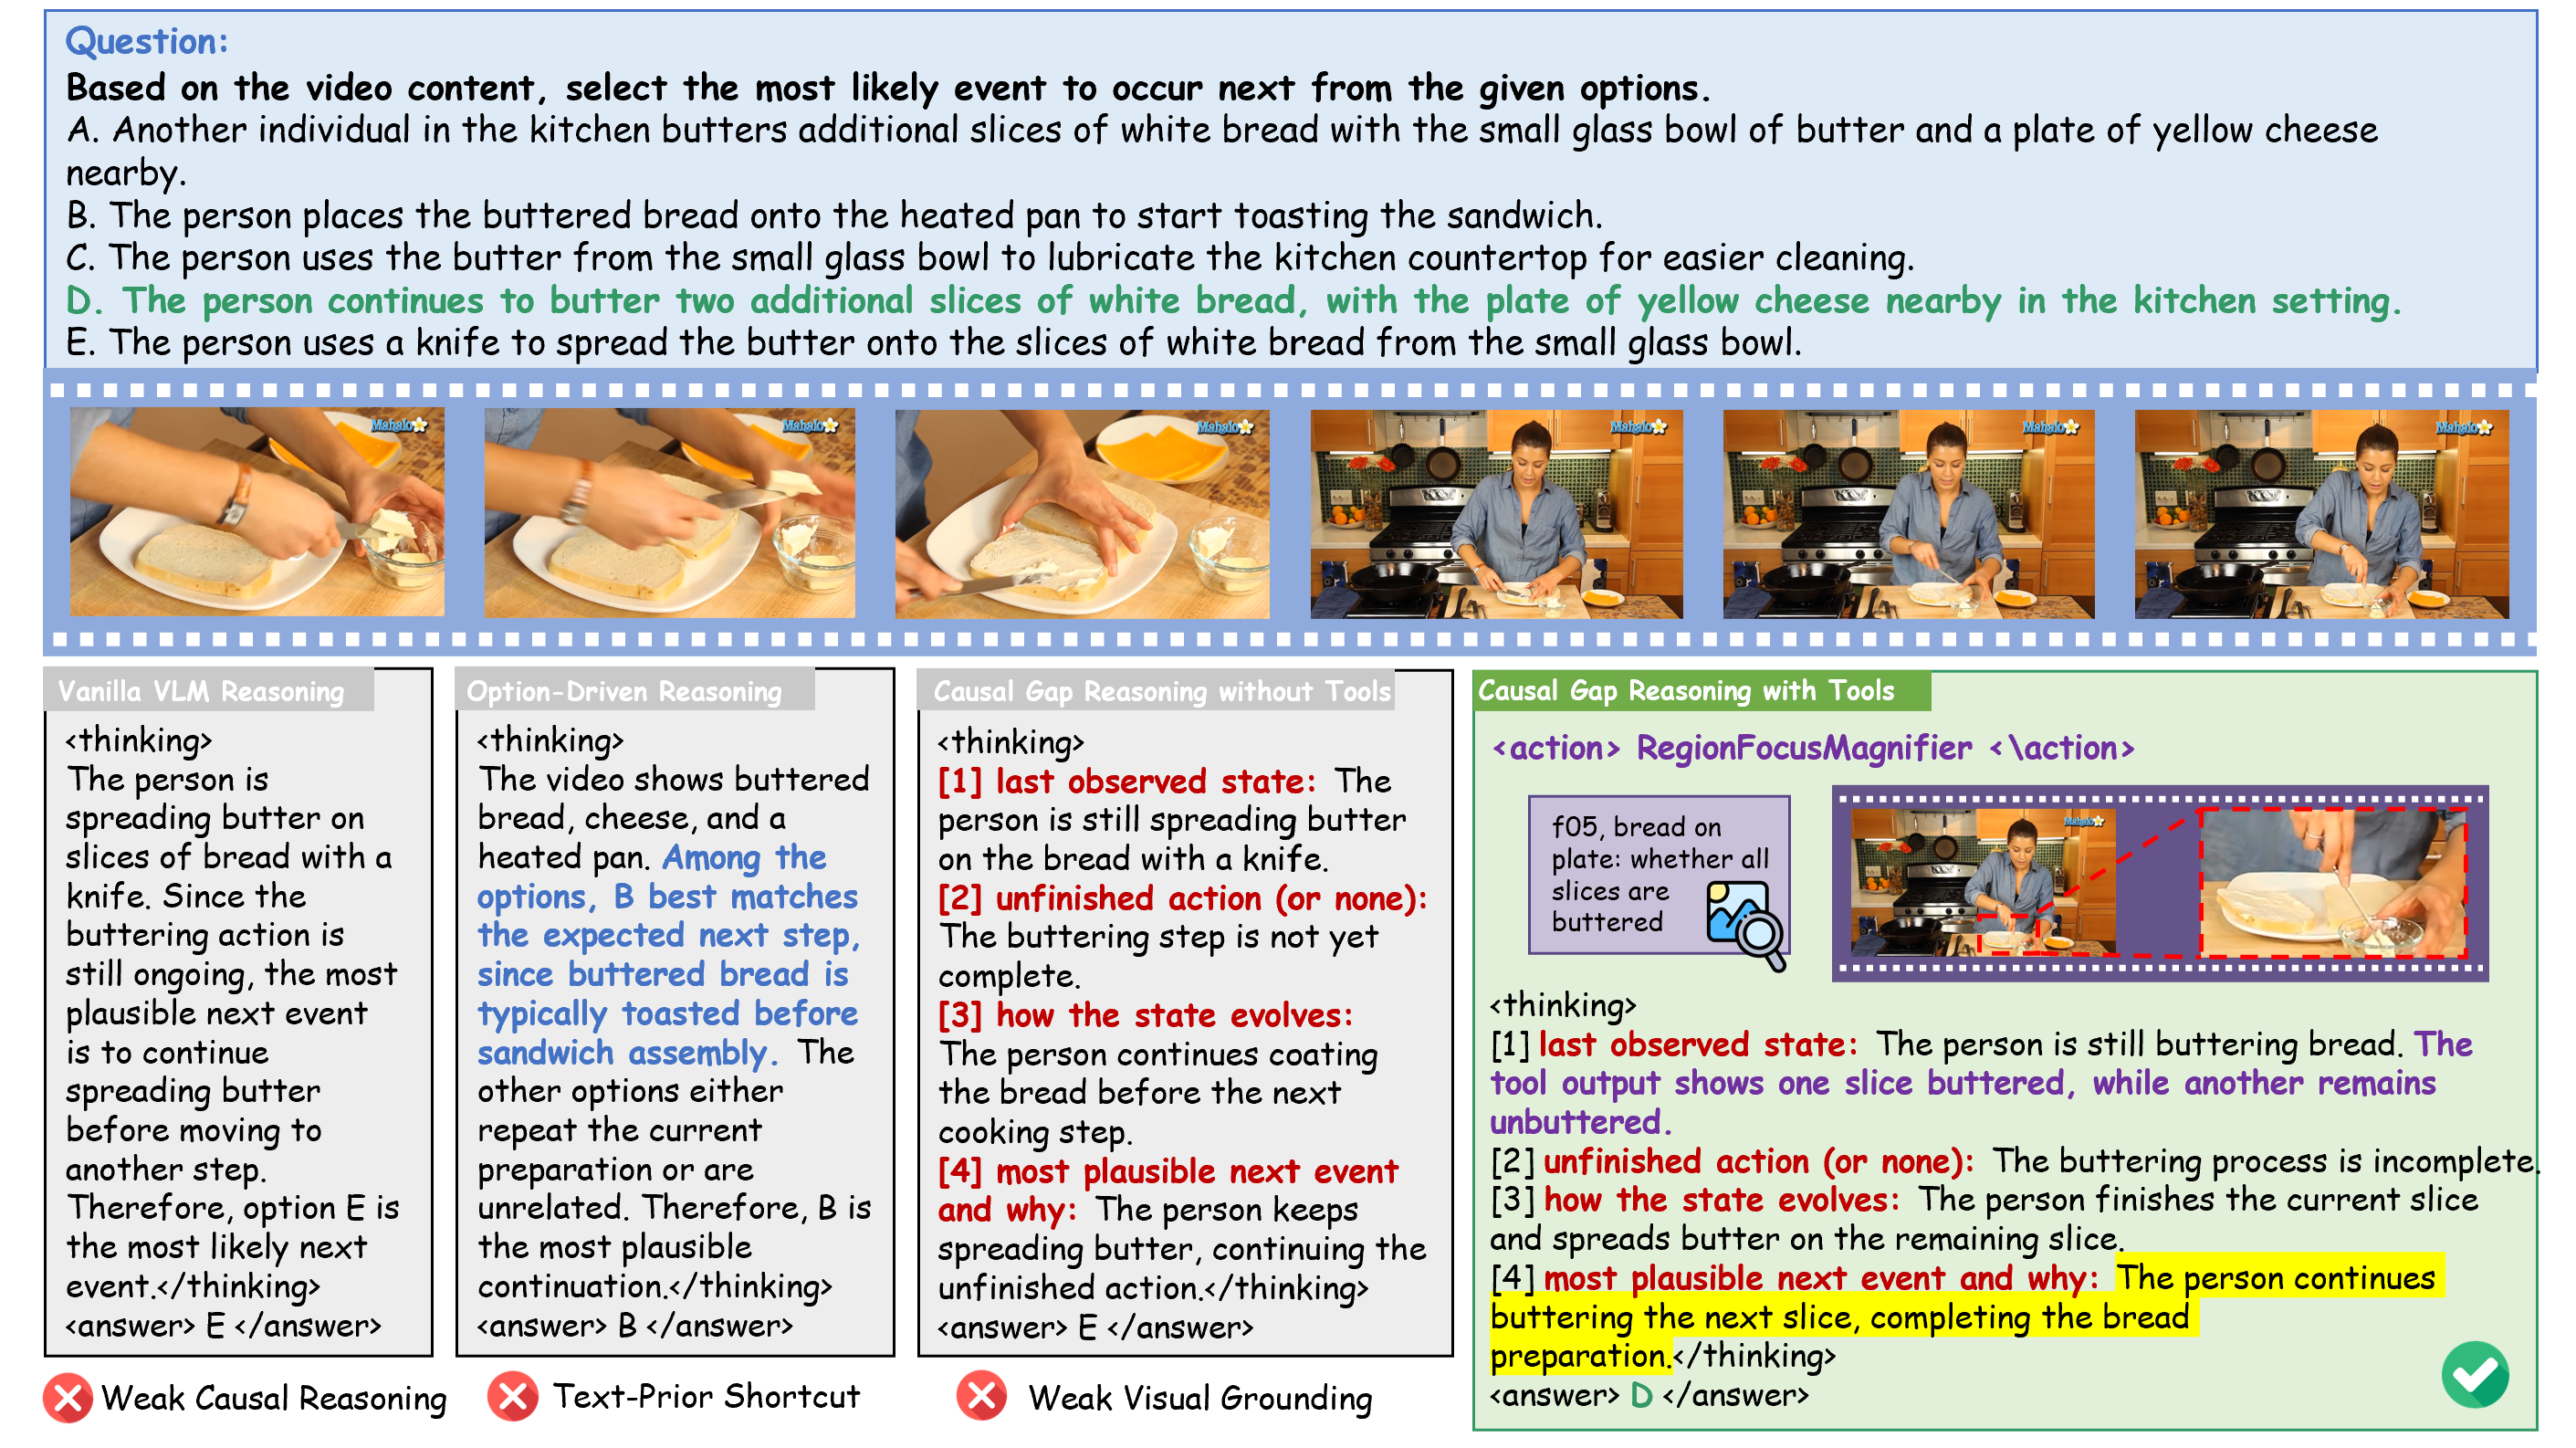
Multimodal Large Language Models (MLLMs) 在视频理解上展现出显著潜力,但其对回溯式摘要与以文本为中心先验的依赖,限制了它们在 视频事件预测 (VEP) 中桥接未观测因果转移的能力。 为此,我们提出 VepAgent,一个面向稳健 VEP 的智能体框架,将因果转移推理与工具增强强化学习 (RL) 相融合。与被动地从历史依赖外推未来轨迹的既有方法不同,该框架显式建模从终止观测状态到未来事件的逻辑演进: 1. 构建 FutureBench-4K,一个高质量的思维链数据集,通过结构化推演未观测的中间状态,为监督微调 (SFT) 弥合因果逻辑鸿沟; 2. 开发集成状态跟踪、帧检索与区域放大的诊断工具库,使智能体在推理时借助外部工具恢复缺失的时空证据、消解视觉歧义; 3. 设计复合奖励机制,联合优化预测准确率、因果连贯性与可靠先验,促使智能体依赖真实的视觉基础而非表层文本相似性。 在 FutureBench 与 NEPBench 上的大量评估表明,本方法取得 SOTA 性能,显著优于规模更大的 MLLMs,验证了这一面向未来的智能体推理范式的实际有效性。
论文精读
TL;DR VepAgent 将因果过渡推理与工具增强 RL 结合,显式建模从终止观测状态到未来事件的逻辑链,在 FutureBench 与 NEPBench 上超越更大 MLLMs,取得 SOTA。
问题
问题背景
视频理解领域正从事后摘要向预测性推理演进,MLLM 在视频 QA 和 captioning 表现出色,但视频事件预测(VEP)要求从观测帧推断未来事件,仍属开放问题。
现有方法局限
- 主流 MLLM 依赖 回顾式摘要 与文本先验,倾向于匹配表面语义,难以补齐未观测的因果链条。
- 以往 VEP 方法将历史依赖 被动投射 为未来轨迹,缺乏从终端观测状态到未来事件的显式逻辑推演。
- 推理中缺少可调用的 外部诊断工具,无法恢复缺失时空证据或消解视觉歧义。
为什么难且重要
VEP 需要建模 因果转移、恢复未观测中间状态,并要求模型依赖真实视觉证据而非文本相似度。高质量链式推理数据稀缺,评测基准有限。业界对预测性视频理解需求上升,覆盖自动驾驶、机器人规划、异常预警等场景,推动研究从判别式理解走向生成式想象。
行业类比
类似 自动驾驶中的轨迹预测:仅凭历史轨迹拟合无法应对突发交互,必须显式推理未观测的意图与状态转移,才能做出可靠预判。
核心洞察
- VepAgent 将视频事件预测从被动时间序列外推转变为主动因果状态推导。与以往方法依赖历史帧时序依赖不同,它显式建模从终止观察状态到未来事件的逻辑进展,通过构造未观察中间状态弥合因果跳跃,使推理链具备可解释性。这对工程调试和可信度评估更具价值,也为处理遮挡、动作转折等复杂场景提供了结构化思路。
- VepAgent 的复合奖励机制联合优化预测准确率、因果连贯性和可靠先验,直接对抗 MLLM 的文本先验偏差,强制模型依赖真实视觉证据而非表面文本相似性。配合诊断工具库(状态跟踪、帧检索、区域放大)动态补充时空证据,使推理过程可验证,为实际部署中减少幻觉和提升视觉 grounding 提供了可操作的训练信号。
方法
输入与任务定义
VepAgent 处理 视频事件预测 (VEP):输入为观测到的视频帧序列,输出为未来事件类别或描述。形式化地,给定历史观测 ( O_t ),模型需要预测未来事件 ( E_{t+1} )。
关键模块
因果过渡推理:模型不直接外推历史轨迹,而是显式建模从终止观测状态到未来事件的逻辑进展,推断未观测的中间状态。这一能力通过构造 chain-of-thought 数据集
futurebench-4K进行监督微调(SFT)获得。诊断工具库:集成三类工具:
- 状态追踪器 (State Transition Tracker):跟踪物体/场景状态变化。
- 聚焦证据检索器 (Focused Evidence Retriever):检索相似帧或外部知识。
- 区域放大镜 (Region Focus Magnifier):放大关键区域,恢复缺失的时空证据。
推理时,agent 根据当前不确定性动态调用工具,解决视觉歧义。
两阶段训练:
- Agentic SFT:使用
futurebench-4K微调模型,使其学会推理未观测中间状态并调用工具。 - Agentic RL:设计复合奖励函数,联合优化预测准确性、因果连贯性和可靠先验,迫使模型依赖真实视觉基础而非表层文本相似性。
- Agentic SFT:使用
输出与差异点
最终输出为未来事件预测,伴随推理链和工具调用记录。与被动投影未来轨迹的方法(如 VideoLLaMA 等依赖历史依赖)不同,VepAgent 通过工具增强的因果过渡推理,显式桥接观测到未来的逻辑缺口。
实验
实验设计
- 在 FutureBench 与 NEPBench 两个视频事件预测基准上评估 VepAgent,对比多个更大规模的 MLLM 基线。
- 通过消融实验分别验证三项核心组件的贡献:futurebench-4K SFT 数据集、诊断工具库(状态跟踪、帧检索、区域放大)、以及复合奖励机制。
关键发现
- VepAgent 取得 state-of-the-art 结果,显著超越参数规模更大的 MLLM,证明因果过渡推理 + 工具增强 RL 的范式有效性。
- futurebench-4K 通过构造未观察中间状态的链式推理,有效弥合因果逻辑缺口;诊断工具库在推理过程中动态恢复缺失的时空证据,解决视觉歧义。
- 复合奖励联合优化预测精度、因果连贯性与先验可靠性,使模型依赖真实视觉基础而非表面文本相似度。
与基线对比解读
先前方法往往从历史依赖中被动投影未来轨迹,而 VepAgent 显式建模从终端观察状态到未来事件的逻辑进展。在需要跨未观察因果过渡的场景中,这一差异带来明显优势。即便参数量小于对比模型,也能取得更好性能,说明结构化因果推理与工具增强比单纯扩大模型规模更具工程价值。
行业影响
落地场景
视频事件预测 可直接嵌入短视频平台的内容安全审核、直播电商的实时转化预测、自动驾驶风险预判、企业监控异常预警等。例如电商直播中基于主播动作与商品状态预测下一步购买转化;内容平台可预测争议事件进行前置干预。
商业价值
通过 agentic 推理 与工具检索恢复未观测因果过渡,减少误判和人工复核成本;预测准确率提升带来实时运营收益(如直播推流、库存调度),并增强安全体验。RL 组合奖励 保证视觉 grounding,降低文本偏见导致的线上事故。
与现有 stack 接口
可作为 MLLM 推理插件接入现有视频理解 pipeline:在风控/推荐系统的特征层增加 VepAgent 输出的事件概率与因果链;工具库对接向量数据库(帧检索)与对象追踪服务;SFT 数据与 RL 奖励用于模型持续优化,通过 gRPC/推理服务部署。
局限
- 论文未充分讨论 failure cases 与跨域泛化边界。评估仅基于 FutureBench 和 NEPBench 两个基准,场景覆盖有限(如日常活动、体育等),缺乏对长视频、低帧率、多事件交错或域外视频的测试。此外,诊断工具库中的状态跟踪、帧检索、区域放大等工具均针对现有数据集设计,当迁移到新领域时可能需要重新定义工具接口或调用策略,限制了方法的可扩展性。
- 训练数据构建与 RL 训练复杂度较高。futurebench-4K 数据集依赖链式推理标注,若采用自动或半自动生成,其因果中间状态的合理性与多样性可能不足,且未报告标注噪声控制措施。复合奖励机制(预测准确率、因果一致性、可靠先验)需要精细调参,对超参数和奖励权重敏感,复现门槛较高;论文未给出训练成本与收敛稳定性分析,工程落地时可能面临较大调优开销。
- 与同类工作的对比不够全面。论文主要与 larger MLLMs 基线比较,未充分纳入近期视频预测专用模型(如基于世界模型或预测编码的方法),也未分析工具调用带来的推理延迟与计算开销。在实时或资源受限场景中,agent 多次调用外部工具可能显著增加响应时间,影响实际部署可行性。