JLD: 通过 Jacobian 透镜的感知距离
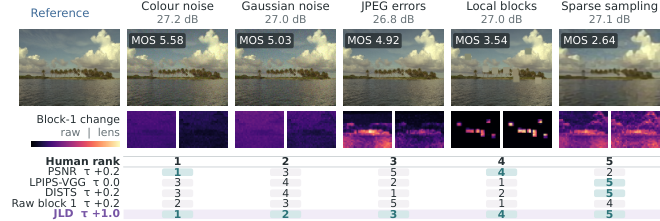
图像压缩、修复与生成都需要衡量两幅图像在人眼中的差异。像素误差忽略了人眼感知,而最准确的感知距离通常拟合于人类主观评分,从而被绑定在固定的数据和分辨率上。例如,当图像分辨率翻倍时,DISTS 在 TID2013 上与人类评分的相关系数从 0.815 降到 0.717。 我们提出 Jacobian Lens Distance (JLD),其感知几何来自一个冻结的视觉编码器,而非人类标注。JLD 结合了早期 patch 特征的局部性与后期编码器表示所捕捉的感知敏感性:利用编码器 Jacobian 找出早期特征空间中对编码器输出影响最大的方向,得到一个固定的度量张量 E[J^top J],即 Jacobian lens。该透镜仅需从 100 张无标注图像拟合一次,耗时约 35 秒。在局部上,这一构造在像素空间定义了拉回度量,使 JLD 具有清晰的几何解释,可直接在真实图像上分析。 在四个标准感知数据库上,JLD 达到 SOTA 性能,并持续优于 LPIPS、DISTS、PieAPP 与 DreamSim。JLD 对分辨率变化也较为鲁棒:在 TID2013 上分辨率翻倍时,其 lens 项相关系数几乎不变,仅从 0.850 降至 0.845。我们还提出 JLD-fast,比 LPIPS-VGG 快 4 倍,平均相关系数达 0.911。最后,JLD 可自然扩展到视频,在 Waterloo IVC 4K 上相关系数为 0.786,而 VMAF 为 0.611。
论文精读
TL;DR JLD 利用冻结视觉编码器的雅可比矩阵构造固定度量张量,得到无需人类标签且对分辨率变化稳健的感知距离,在多个基准上超越 LPIPS、DISTS 等现有方法。
问题
问题背景
图像压缩、恢复与生成任务均需可靠地度量两幅图像在人类视觉上的差异,以指导模型优化或评价输出质量。
现有方法局限
- 像素级误差(如
MSE/PSNR)忽略人眼对结构、纹理、亮度的非线性感知特性。 - 主流感知度量(如 LPIPS、DISTS、PieAPP、DreamSim)通常通过拟合人类评分获得,因此绑定于固定的数据分布与分辨率。例如在 TID2013 数据集上,图像分辨率加倍时 DISTS 与人类评分的相关性从 0.815 降至 0.717。
- 这类指标跨分辨率、跨失真类型泛化能力不足,且缺少清晰的几何解释,难以分析其度量行为。
为什么这个问题难/重要
感知距离需要隐式建模人类视觉系统的多尺度、非线性特性,但主观评分数据获取成本高、规模有限。同时,度量函数必须可微、计算高效,才能嵌入生成模型的训练循环或大规模视频质量监控。设计一个不依赖人类标签、对分辨率变化鲁棒、且具有微分几何意义的感知度量,仍是开放挑战。业界在视频流媒体质量评价、图像增强、生成模型评估等场景中,对稳定、可解释的感知度量有持续需求。
行业类比
就像自动驾驶感知系统需要跨传感器配置稳定工作的标定参数,感知度量也应跨分辨率和数据集保持一致性,否则会导致模型评估结果失真。
核心洞察
- JLD 通过冻结视觉编码器的 Jacobian 构造固定度量张量,将高层语义敏感性直接投影到低层 patch 特征空间,无需人类评分拟合或标注数据,从而摆脱了传统感知距离对特定数据集和分辨率的依赖。相比 LPIPS 等直接比较深度特征或 DISTS 基于人类判断校准,JLD 的几何源自网络本身,分辨率变化下 TID2013 相关性几乎不变(0.850 到 0.845),而 DISTS 从 0.815 降至 0.717,说明其鲁棒性优势。
- JLD 将距离定义为像素空间中的 pullback 度量,由一次性的 Jacobian 张量 E[J^T J] 决定,使每个像素位置的局部几何可解释,并能直接分析真实图像上的失真形变。这种“镜头”视角把感知距离从黑箱特征比较转变为具有微分几何结构的度量,既保留了早期 patch 特征的局部性,又引入了高层输出的全局敏感性,从而在多个基准上超越 LPIPS、DISTS、PieAPP、DreamSim,同时提供 JLD-fast 变体达到 4 倍于 LPIPS-VGG 的速度和 0.911 的平均相关性。
方法
输入与特征提取
JLD 接收两张待比较的图像,先通过一个 冻结的视觉编码器 (frozen vision encoder,如 VGG 或 ViT) 提取多尺度特征。方法同时使用两类特征:early patch features(早期层局部块特征,保留空间细节)和 later encoder representations(后期编码器输出,捕捉高层语义)。
Jacobian lens 构建
核心创新是用编码器的 Jacobian 矩阵 建立感知度量。对每个 early patch feature 位置,计算其对最终编码器输出的偏导数,得到灵敏度矩阵 J。然后对 J⊤J 在 100 张无标签图像上取期望,得到固定的 metric tensor E[J⊤J],作者称之为 Jacobian lens。该 lens 仅需拟合一次,耗时约 35 秒,无需人工评分数据。
距离计算
给定两张图像,先提取它们的 early patch features,计算特征差向量;然后用 Jacobian lens 作为二次型度量,得到 lens term 距离。同时结合一个 output term,度量两张图像在编码器最终输出空间的距离。两个术语加权组合,得到最终的 JLD 分数。通过这种构造,JLD 在像素空间上定义了一个 拉回度量 (pullback metric),具有清晰的几何解释。
变体与扩展
作者还提供 JLD-fast,通过简化特征计算实现比 LPIPS-VGG 快 4 倍的速度,同时保持高相关性;以及 JLD-video,将帧间特征差与时间维度上的 metric tensor 结合,用于视频质量评价。
跟同类方法的差异点:JLD 完全从冻结编码器的几何结构推导度量,不依赖人类评分拟合,因此对分辨率和数据分布变化更鲁棒,且能自然扩展到视频。
实验
实验设计
JLD 使用冻结的视觉编码器,在早期 patch 特征上计算 Jacobian,并对 100 张无标签图像平均得到固定度量张量 E[J^T J],称为 Jacobian lens。距离结合局部 patch 项与输出项,在四个标准感知数据库以及 Waterloo IVC 4K 视频基准上评估,并与 LPIPS、DISTS、PieAPP、DreamSim 对比。消融覆盖特征秩、透镜灵敏度、色度预滤波、池化方式,并衍生 JLD-fast、JLD-lin、JLD-video 变体。
关键发现
JLD 在四个数据库上达到 SOTA。TID2013 上透镜项相关为 0.850,分辨率翻倍后仅降至 0.845,而 DISTS 从 0.815 掉至 0.717。JLD-fast 平均相关 0.911,速度比 LPIPS-VGG 快 4 倍。视频上 JLD 在 Waterloo IVC 4K 的相关为 0.786,显著高于 VMAF 的 0.611。
基线对比解读
JLD 不依赖人类标注,仅从冻结编码器的几何结构导出感知度量,对分辨率变化鲁棒。与需要拟合人类判断的 LPIPS/DISTS 等相比,JLD 避免了固定数据和分辨率的限制;与 DreamSim 等深度特征度量相比,JLD 通过 Jacobian 显式利用早期特征的局部性与后期表征的感知敏感性,在相关性和计算开销上取得更优平衡。
行业影响
落地场景
JLD 可作为感知质量指标与损失函数,应用于图像/视频压缩、超分辨率、生成模型训练及内容质量监控。典型场景包括:
- 电商平台商品图增强:在超分或去噪后处理中,用 JLD 替代 LPIPS 或像素误差作为优化目标,提升商品图视觉一致性,减少因图像模糊导致的用户流失。
- 视频流媒体转码质量评估:JLD-video 在 4K 数据集上相关系数 0.786,显著优于 VMAF 的 0.611,可集成到自适应码率决策或自动质量控制 pipeline,实时检测转码伪影。
商业价值
- 降本:JLD 无需人工标注,校准仅需 100 张未标注图像和约 35 秒,省去了主观评分数据库的采集与标注成本。
- 体验提升与降本并行:更高精度的感知度量可提升生成模型或压缩算法的输出质量;
JLD-fast比 LPIPS-VGG 快 4 倍,适合实时或大规模批量处理,降低计算资源开销。 - 分辨率鲁棒性:JLD 在 TID2013 上分辨率翻倍时相关系数仅从 0.850 降至 0.845,而 DISTS 从 0.815 降至 0.717,支持多尺寸部署且无需重新校准。
与现有产品/工作流接口
JLD 提供 PyTorch 实现(GitHub),可作为 drop-in 替换现有感知损失模块:
- 在训练代码中,将
criterion替换为JLD()(或JLD-fast()),固定 vision encoder 权重。 - 在图像/视频质量评估 pipeline 中,替代 LPIPS/DISTS/VMAF 作为最终指标;输出标量可直接用于阈值告警或 A/B 测试。
- 基于 frozen encoder 的特征 Jacobian 计算图可导出 ONNX/TensorRT,便于部署在移动端或边缘推理环境。
局限
- JLD 的性能依赖所选冻结视觉编码器的特征空间。论文默认使用某种 backbone(如 ViT 或 ResNet),但不同编码器的 Jacobian 结构可能显著影响最终度量。虽然消融实验可能涉及部分编码器对比,但未明确证明跨编码器的鲁棒性。在实际部署中,若需更换编码器以适应特定领域(如医学影像、遥感图像),必须重新拟合 lens 并校准参数,增加额外成本。此外,编码器预训练数据(如 ImageNet)的分布偏差可能导致 JLD 对非自然图像的感知评估偏离人类判断,限制其在垂直领域的直接应用。
- 计算开销与近似版本存在权衡。虽然 lens 一次性拟合仅需约 35 秒,但针对每张测试图像,计算早期 patch 特征与后期编码器输出的 Jacobian 仍需可观算力。JLD-fast 虽比 LPIPS-VGG 快 4 倍,但文中未详细报告其与完整 JLD 在相关性上的具体差距,近似可能削弱对精细失真的敏感度。视频扩展 JLD-video 仅在 Waterloo IVC 4K 上验证,未讨论逐帧计算带来的计算负担或实时性优化;对于 4K/8K 视频流,逐帧提取深度特征并计算 metric tensor 可能难以满足低延迟编码需求。
- 实验验证集中于标准 IQA 数据库,真实世界覆盖不足。四个标准数据库(如 TID2013、KADID-10k 等)的失真类型以合成退化为主,缺少真实拍摄噪声、压缩伪影混合等复杂场景。虽然附录包含 human study,但正文未突出大规模主观验证结果,与 VMAF 等经过广泛主观测试的指标相比,JLD 在真实图像/视频传输链路上的可靠性有待进一步确认。由于 JLD 完全无监督地从编码器 Jacobian 推导,未直接拟合人类评分,可能在某些高频纹理或语义敏感区域出现与人类感知不一致的偏差,这需要更多针对性的心理物理学实验验证。