Execution-Aligned Progressive Noise:用于生成式机器人策略中一致的异步重规划
连续异步重规划是实时生成式机器人策略的关键能力,但每次独立采样随机噪声会引发 模式切换 (mode switching),并导致相邻 action chunk 之间延续不一致。 为此,我们提出 Execution-Aligned Progressive Noise(EAPN),在 chunk 间与 chunk 内两个层面引入结构化随机性: - Chunk 间:跨重规划步骤传播共享的噪声轨迹,并将其与实际执行位移对齐,建立 execution-aligned 的 chunk 间相关性; - Chunk 内:沿动作时间维度建模时间相关性。 对齐后的随机历史进一步与已提交的 action context 结合,用于条件化后续生成,使新 chunk 从与执行一致的生成状态延续,而非从独立噪声重新开始。 我们在 D3IL、Kinetix、LIBERO 以及真实世界操作任务上评估 EAPN。EAPN 在 D3IL 上提升了多模态行为一致性,在 Kinetix 上取得 88.59% 的平均成功率;在 LIBERO 上,即便推理延迟较长仍保持稳健的任务性能。真机实验中,Object Storage 任务成功率达 90.0%,双臂 Cloth Folding 任务达 96.7%,表明其在异步重规划下具备可靠的连续执行能力。
论文精读
TL;DR EAPN 引入执行对齐的渐进噪声,为生成式机器人策略建立跨重规划步的相关随机性,使新动作块延续已执行状态而非独立重启,提升异步重规划下的一致性与成功率。
问题
问题背景
生成式机器人策略(如 Flow Matching、Diffusion Policy)在实时控制中普遍采用异步重规划:模型推理生成下一段动作块,同时当前动作块继续执行。这一机制在推理延迟与执行频率之间取平衡,是当前机器人学习部署的核心范式。
现有方法局限
常规做法在每个重规划步骤独立采样随机噪声初始化去噪过程,带来三类问题:
- 跨块模式切换:在多模态任务中,相邻动作块可能分别落到不同解模态,导致末端抖动或意图跳变。
- 执行不一致延续:新动作块仅条件于当前观测,不携带已执行块的随机生成历史,难以与上一块末端状态平滑衔接。
- 推理延迟鲁棒性差:延迟动态变化时,已执行位移与生成时假设的起始位置不匹配,进一步放大跨块不连续。
为什么这个问题难/重要
难点在于随机性既要充分(保留多模态探索),又要结构化(维持时序一致)。完全独立噪声无法编码历史;完全共享噪声又会损失多样性。工业部署对连续操控的稳定性要求极高,块间哪怕短时抖动也可能导致任务失败。EAPN 引入块间共享噪声并随实际执行位移对齐,同时在块内建模时间相关性,并用已提交动作上下文条件化后续生成。论文在 D3IL、Kinetix、LIBERO 及真实双臂任务上验证了多模态一致性与长推理延迟下的鲁棒性,平均成功率最高达 96.7%。
行业类比
与文生视频中为保持角色身份一致性而需要时序噪声先验类似,生成式机器人策略也需要“噪声记忆”,否则每次重规划都从零开始,就像视频每帧独立采样会导致画面闪烁。
核心洞察
- EAPN 将异步重规划中的独立噪声替换为执行对齐的渐进噪声,解决跨块模式切换问题。与常见方法每次重规划独立采样噪声导致不同块可能落入不同行为模式不同,EAPN 通过传播共享噪声轨迹并与实际执行位移对齐,建立块间相关性,允许新块从执行一致的生成状态继续,而非从独立噪声重启,从而在保持多模态性的同时提升连续执行一致性。
- EAPN 在块内引入时间相关性,并结合已提交动作上下文条件化生成,实现更精细的连续控制。现有工作往往只关注块间粗粒度一致性或牺牲随机性换取确定性,EAPN 通过块内结构化噪声保留动作时间上的平滑性,同时利用历史条件(包括已执行部分)使生成过程与真实执行紧密耦合,从而在异步推理延迟下仍能可靠延续动作序列。
方法
输入
EAPN 接收当前观测、上一 chunk 已提交的动作上下文,以及维护中的噪声轨迹。其中噪声轨迹是跨重规划步骤持久化的共享随机状态,而非每次独立采样。
关键模块
- 执行对齐的块间噪声传播:每次重规划时,将共享噪声轨迹向前推进,并根据实际执行位移(已执行动作步数)对齐。这保证了新 chunk 的噪声起点与已执行动作的生成状态在时间上连贯,避免独立初始化导致的模式切换。
- 块内时间相关性建模:单个动作 chunk 内部,噪声沿动作时间轴引入结构化相关性,使 chunk 内动作序列保持时间平滑,而非各步独立噪声。
- 历史条件噪声表示:将执行对齐后的噪声历史与已提交动作上下文拼接,作为条件输入到生成策略(如 Flow Matching 模型)。新 chunk 的生成从该条件化的生成状态出发,而不是从独立噪声重启。
- 联合训练与异步部署:训练时同时优化动作重建与噪声轨迹的一致性;部署时支持异步 replanning,即使推理延迟变化,也能保持连续执行。
输出
输出为新动作 chunk,其生成分布与已执行轨迹在噪声空间和执行空间上保持一致,支持多模态行为的连续延续。
差异点
与独立随机初始化或仅固定噪声的同类方法不同,EAPN 将噪声本身视为可传播、执行对齐的隐状态,使跨 chunk 生成真正从执行一致的生成状态继续,而不是每次重启。
实验
实验设计
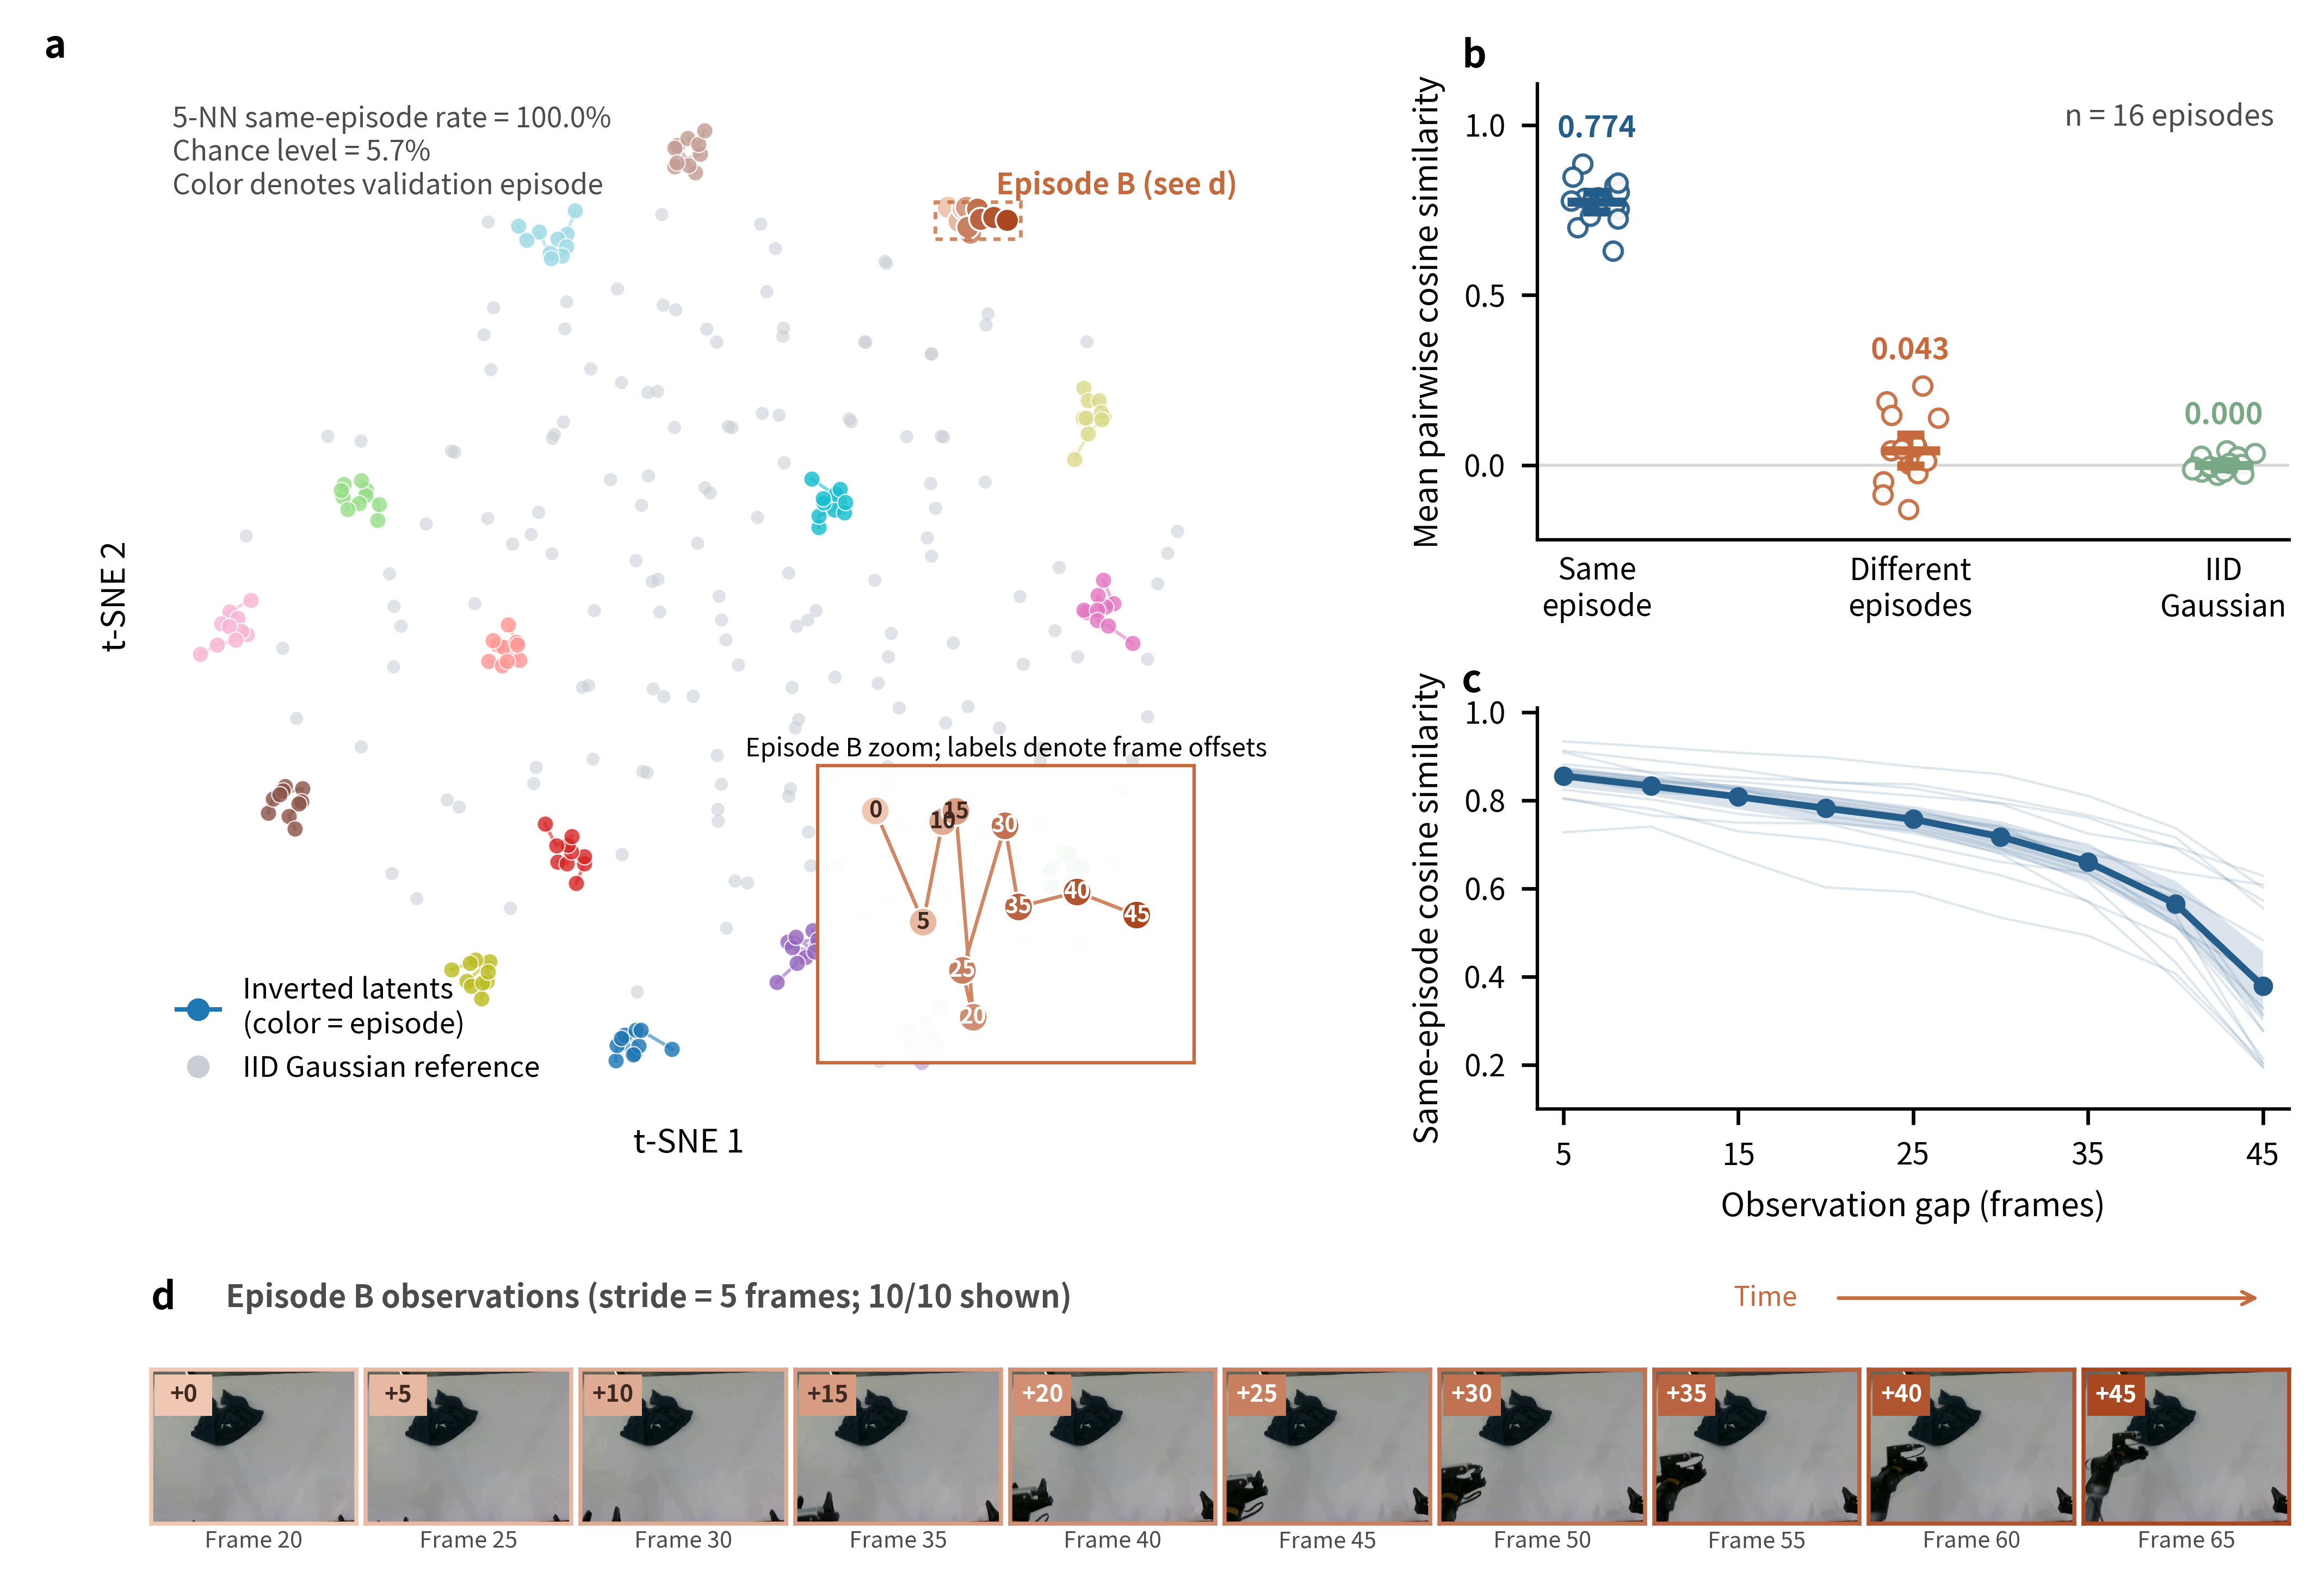
EAPN 在四个基准上评测:D3IL 用于多模态行为一致性,Kinetix 用于动态推理延迟鲁棒性,LIBERO 用于长推理延迟场景,以及真实机器人任务 Object Storage 与 Cloth Folding。作者还分析了标准策略的 inversion 特性,并对 EAPN 组件进行消融。
关键发现
- EAPN 在 D3IL 上提升多模态行为一致性,避免模式切换。
- Kinetix 平均成功率达 88.59%。
- LIBERO 上长推理延迟仍保持鲁棒,任务性能稳定。
- 真实机器人:Object Storage 成功率 90.0%,Cloth Folding 成功率 96.7%。
- 消融实验验证了 execution-aligned inter-chunk correlation 与 intra-chunk temporal correlation 的必要性。
与基线对比解读
相比独立随机初始化的标准生成式策略,EAPN 通过传播执行对齐的共享噪声轨迹,使新块从执行一致的生成状态继续,而非从头采样。这显著减少跨块模式切换和不连续执行,尤其在异步重规划下。在 Kinetix 动态延迟测试中,EAPN 保持高成功率,表明历史噪声表示与 committed action context 的条件生成机制对实时策略的鲁棒性至关重要。
行业影响
落地场景:生成式机器人策略(扩散策略 / flow matching)用于需高频异步重规划的实时操控,如电商仓库分拣、双臂衣物折叠、汽车总装线插接等。EAPN 解决多模态行为一致性问题,适合长时程任务、动态来料、人机协作等需要连续执行且推理延迟不确定的场景。具体案例:电商订单拣选机器人,传送带动态来料触发重规划,EAPN 确保动作块之间无缝衔接,避免抓取模式跳变。
商业价值:任务成功率显著提升(Kinetix 平均 88.59%,真实任务 90%-96.7%),减少模式切换导致的中断与人工干预,降低运维成本。在 LIBERO 上对长推理延迟保持鲁棒,允许使用更低成本的边缘计算或云端推理,不牺牲可靠性。缩短机器人调试周期,提升客户 ROI。
集成接口:EAPN 可作为噪声初始化模块嵌入现有生成式策略框架,增加共享噪声 buffer 记录已执行动作对应的噪声状态,并与预测轨迹对齐。训练时联合优化噪声相关性,推理时结合已提交动作上下文条件。无需更改策略网络架构或推理管线,可平滑替换独立随机采样。
局限
- **计算开销与状态维护**:EAPN 需要在每个重规划步骤传播共享噪声轨迹并维护执行对齐的随机历史,这会增加额外的存储和计算负担。尤其在需要高频重规划或长时程任务中,历史噪声表示的维度会不断增长,可能影响实时性。论文未报告与标准独立噪声初始化相比的额外推理延迟或内存占用,实际部署时需权衡。
- **对特定生成模型架构的依赖**:EAPN 的设计假设策略基于 Flow Matching 或扩散模型等可从噪声迭代去噪的生成式框架,对于其他策略表示(如自回归离散动作 token 或 VAE 隐空间采样)不一定直接适用。实验主要在 diffusion/flow 类策略上验证,其泛化性有待进一步考察。
- **评估场景与基线对比有限**:论文在 D3IL、Kinetix、LIBERO 和两个真实任务上验证,但均为相对短时程、准静态操作任务;对于需要高频动态响应或长序列多阶段任务,EAPN 能否保持执行一致性尚未验证。此外,未与噪声重用、固定随机种子或 temporal ensemble 等简单基线进行系统对比,无法完全排除一致性提升主要来自噪声复用而非执行对齐的可能。