面向 World Action Models 的视频原生动作先验学习
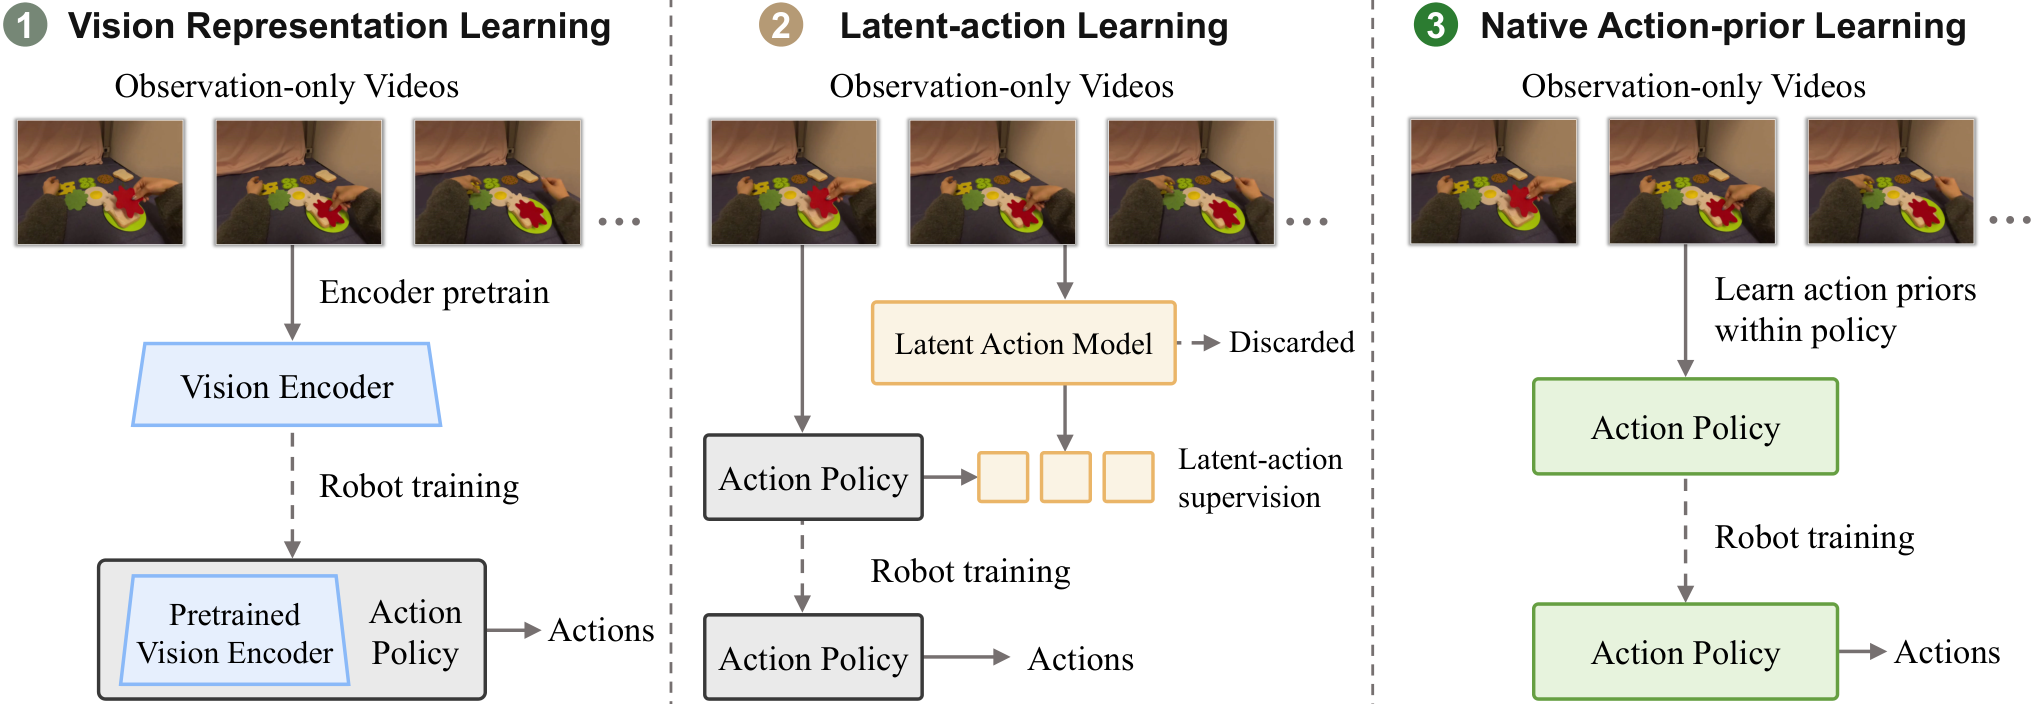
World action models 将未来视觉动态与机器人动作预测整合,但其可扩展性受限于对带动作标注的机器人轨迹的依赖。仅有观测的视频(observation-only videos)虽包含丰富的交互动态证据,现有方法却通常只将其用于预训练视觉表征、再适配到控制,或用于推断 latent action 再落地为机器人指令。 我们提出 NAVA-WAM,通过直接从仅有观测的视频中预训练动作策略,引入 native action-prior learning,避免间接的表征到控制迁移或额外的 latent-action 模型。训练分两阶段: 1. 预训练:在仅有观测的视频上进行,未来视频的 flow-matching 监督经 transition-structured joint attention 传播,优化 Action-DiT,从而学到与动作相关的先验。 2. 后训练:用带动作标注的演示,通过 joint video–action flow matching 对 Action-DiT 做机器人控制后训练;asymmetric attention 将视觉分支与迭代动作去噪解耦,支持高效的 action-only inference。 大量实验表明,NAVA-WAM 在 in-distribution 与 out-of-distribution 设置下均持续优于先前方法,并展现出很强的 action-label efficiency 与有效的真实机器人泛化能力。这些结果确立了 native action-prior learning 作为直接从仅有观测视频预训练动作策略的有效途径,为超越动作标注机器人数据提供了可扩展的路径。
论文精读
TL;DR NAVA-WAM 直接从纯观测视频中预训练动作策略,通过未来视频流匹配传递动作先验,显著降低对动作标注数据的依赖,并在多个基准和真实机器人上实现高效泛化。
问题
问题背景
当前机器人学习领域关注 World Action Models(世界行动模型)——它们联合建模未来视觉动态与机器人动作预测,目标是构建可扩展的操控基础模型。核心瓶颈在于高质量 action-annotated robot trajectories(动作标注机器人轨迹)获取成本高,而海量 observation-only videos 蕴含丰富交互动态信息。
现有方法局限
利用 observation-only videos 的现有方案主要分两类,均属间接路径:
- Visual representation pretraining:先用视频预训练视觉编码器,再适配到控制策略。存在 representation-to-control gap,预训练特征未必对齐动作预测所需的转移信息,下游仍需大量动作数据微调。
- Latent action inference:先从视频推断隐式动作,再 grounding 到机器人指令。需额外维护 latent action model,grounding 过程可能引入误差,且隐动作空间设计(离散/连续、维度)直接影响下游性能。
这些方法没有直接优化动作策略本身,导致动作先验学习不充分,或引入不必要适配开销。
为什么这个问题难且重要
直接从无动作视频学习 action prior 的难点在于:无显式动作监督,模型必须通过 future-video prediction 隐式推导导致状态转移的动作信息,同时抑制光照、背景、视角等与动作无关的视觉变化。若成功,可显著降低对 action-labeled data 的依赖,提升策略在新场景和真实机器人上的泛化,是机器人基础模型规模化的关键路径。
一句话类比:类似于 NLP 中通过自监督文本预训练获得语言先验,再通过少量指令微调适配下游任务,NAVA-WAM 试图从无动作视频直接“预训练”动作策略,再用少量动作标注数据后训练控制能力。
核心洞察
- **直接从观察视频预训练动作策略** 消除了表示迁移与潜动作接地两步,实现端到端的动作先验学习。 现有方法通常利用无动作视频进行视觉表示预训练,后续再适配到控制任务,或先推断潜动作再与机器人命令对齐,这两种路径都会引入额外损失或需要昂贵的对齐标注。NAVA-WAM 通过 transition-structured joint attention 将未来视频的 flow matching 监督直接传播到 Action-DiT,让动作分支与视觉动态共享一致的先验,从而减少对动作标注数据的依赖。
- **后训练的非对称 attention 解耦视觉与动作分支** 实现了仅动作网络的推理,大幅降低计算开销。 世界动作模型在部署时若仍需视觉编码器参与动作去噪,会带来极高的延迟与显存占用,限制实时控制。NAVA-WAM 设计非对称 transition attention,使动作去噪独立于视觉分支,推理时仅需 Action-DiT,在 LIBERO 和 RoboTwin 等基准上保持甚至提升成功率的同时,显著提升推理效率,为真实机器人部署提供了可行性。
方法
输入与输出
- 输入:仅观察视频(第一阶段)与动作标注演示(第二阶段)
- 输出:动作策略,推理时只运行动作分支,不依赖视觉去噪。
第一阶段:原生动作先验预训练
模型以 Action-DiT 为核心(动作扩散 Transformer)。在仅观察视频上,对相邻帧进行 未来视频 flow matching 监督,预测视觉动态。关键设计是 transition-structured joint attention:将视觉过渡的监督信号通过注意力结构传导至动作令牌,使 Action-DiT 学习“若执行某动作,视觉将如何变化”的反向-正向动态先验。此过程无需任何动作标签,直接优化动作策略参数,避免表示到控制 的间接迁移,也无需单独推断潜在动作。
第二阶段:后训练与推理
使用少量动作标注演示进行后训练,采用联合视频-动作 flow matching,同时拟合视觉动态与真实动作分布。通过不对称过渡注意力,将视觉分支与动作迭代去噪解耦:视觉分支仅在后训练中提供上下文,推理时被完全移除。因此,部署时仅执行动作去噪 步骤,推理成本显著降低。
与同类方法差异
NAVA-WAM 直接预训练动作策略,而非“先用视频预训练视觉表示再适配控制”或“先推断潜在动作再接地到机器人命令”,从根本上提升仅观察视频数据的利用效率。
实验
实验设计
NAVA-WAM 在多个机器人操作基准上进行了系统评估,覆盖仿真到真实的泛化链路:
- LIBERO 与 LIBERO-Plus:用于评测分布内与分布外场景下的动作预测与视觉动态建模能力。
- RoboTwin 2.0:双机械臂协作任务的标准化基准,考察复杂交互下的泛化性能。
- DROID:真实机器人数据,验证从纯观察视频预训练到少样本动作后训练的有效部署。
实验重点包括:动作标签效率(仅使用少量标注数据微调)、观察数据规模扩展性、以及注意力机制解耦带来的纯动作推理效率。
关键发现
摘要明确指出:NAVA-WAM 在分布内与分布外设置下均一致优于先前方法,并展现出强动作标签效率与真实机器人泛化能力。其核心优势源于原生动作先验学习——直接对动作策略进行预训练,而非依赖后续的表示到控制迁移或独立潜在动作模型。
与基线的对比解读
相比两类典型基线:
- 视觉表示预训练 + 控制适配:需要额外微调才能用于策略,存在表示与控制目标不一致的问题。
- 潜在动作推断 + 接地:需学习视频中的潜在动作并将将其映射到机器人指令,流程繁琐且误差累积。
NAVA-WAM 采用的 Action-DiT 与非对称注意力机制,在预训练阶段即优化动作路径,使未来视频流匹配的监督直接塑造策略先验。后训练时通过解耦视觉分支与迭代动作去噪,实现高效的动作纯推理。这一设计从源头减少了对动作标注数据的依赖,为扩展至大规模无标注视频提供了更直接的路径。
行业影响
落地场景
NAVA-WAM 提供了一种从观察视频直接预训练动作策略的方法,可广泛应用于机器人操作、自动驾驶、具身智能等需要学习视觉运动控制的任务。典型场景包括:
- 工业机器人:利用生产线上的监控视频或人工演示视频,预训练抓取、装配等操作策略,减少对精确动作标注的依赖。
- 服务机器人:通过大规模人类交互视频(如 Ego4D)预训练,提升机器人在家庭、零售等开放环境中的操作泛化能力。
- 自动驾驶:使用路测视频(不含控制信号)预训练驾驶策略,再少量微调,加速模型迭代。
商业价值
- 降本:动作标注(如遥操作)成本高昂,观察视频几乎免费且海量。该方法可显著降低数据采集与标注成本,尤其适用于长尾任务。
- 增效:在少样本设置下(例如仅 1% 动作标注)性能优于传统方法,缩短模型从研发到部署的周期。
- 体验提升:更强的分布外泛化能力(OOD)使机器人在新环境、新物体上更鲁棒,直接提升产品成功率和用户满意度。
与现有产品/工作流的接口
- 预训练模块:可作为现有 world action model 训练流程的前置步骤,利用公开视频数据集(如 Something-Something V2)进行大规模预训练。
- 推理优化:论文提出的
asymmetric attention机制在推理时仅需动作输入,无需视觉分支,大幅降低实时控制的计算开销,便于部署到边缘设备。 - 框架兼容性:方法基于 Action-DiT,可无缝融入现有基于扩散模型的动作生成框架,用户只需在训练脚本中增加预训练阶段。
具体落地 use case:
- 仓库自动化:利用仓库中大量无标签的监控视频(叉车、工人操作)预训练机器人拣选策略,再针对特定 SKU 少量微调,大幅降低人工标注成本,同时提升新品类适应速度。
- 自动驾驶仿真:使用互联网上的驾驶视频预训练策略网络,作为仿真器中智能体的初始化,减少真实路测数据需求,加速 L4 算法迭代。
局限
- **预训练数据依赖与 domain gap**:论文在消融实验中明确展示了 observation-only 数据规模对下游性能的显著影响,表明方法需要大规模、高质量的无动作视频进行预训练。然而,预训练视频与下游机器人任务在 embodiment、camera 视角、场景分布等方面往往存在 domain gap,这些差异可能被直接编码进 Action-DiT 的 prior 中,导致在真实机器人部署时出现系统性偏差。论文仅在有限的任务和机器人平台上验证,没有讨论跨 embodiment 或跨视角的迁移难度。
- **动作先验的语义可解释性有限**:虽然通过 transition-structured joint attention 和 future-video flow matching 可以将 transition 信息传播到 action pathway,但 observation-only videos 不包含明确的动作标签,学到的 action prior 可能更偏向视觉运动模式而非实际可执行的控制命令。当环境中存在不可观测干扰或 non-causal 交互时,基于未来视觉预测的监督信号可能产生误导性 prior,且论文未提供定量证据证明学到的隐式 action 与物理动作之间的对应强度。
- **action-only inference 的闭环能力受限**:后训练阶段引入的非对称 attention 允许推理时仅使用 action 分支,大幅提升效率,但完全丢弃视觉分支意味着模型无法根据当前观察进行在线闭环调整。在需要精细视觉反馈的接触丰富任务中(如精密装配、形变物体操作),这种开环方式可能显著降低成功率。论文的实验主要覆盖较结构化的抓取与放置任务,尚未在高度动态或需要实时视觉伺服的任务上验证其优势。