高效推理训练并不总是损害 CoT 忠实性与可监控性
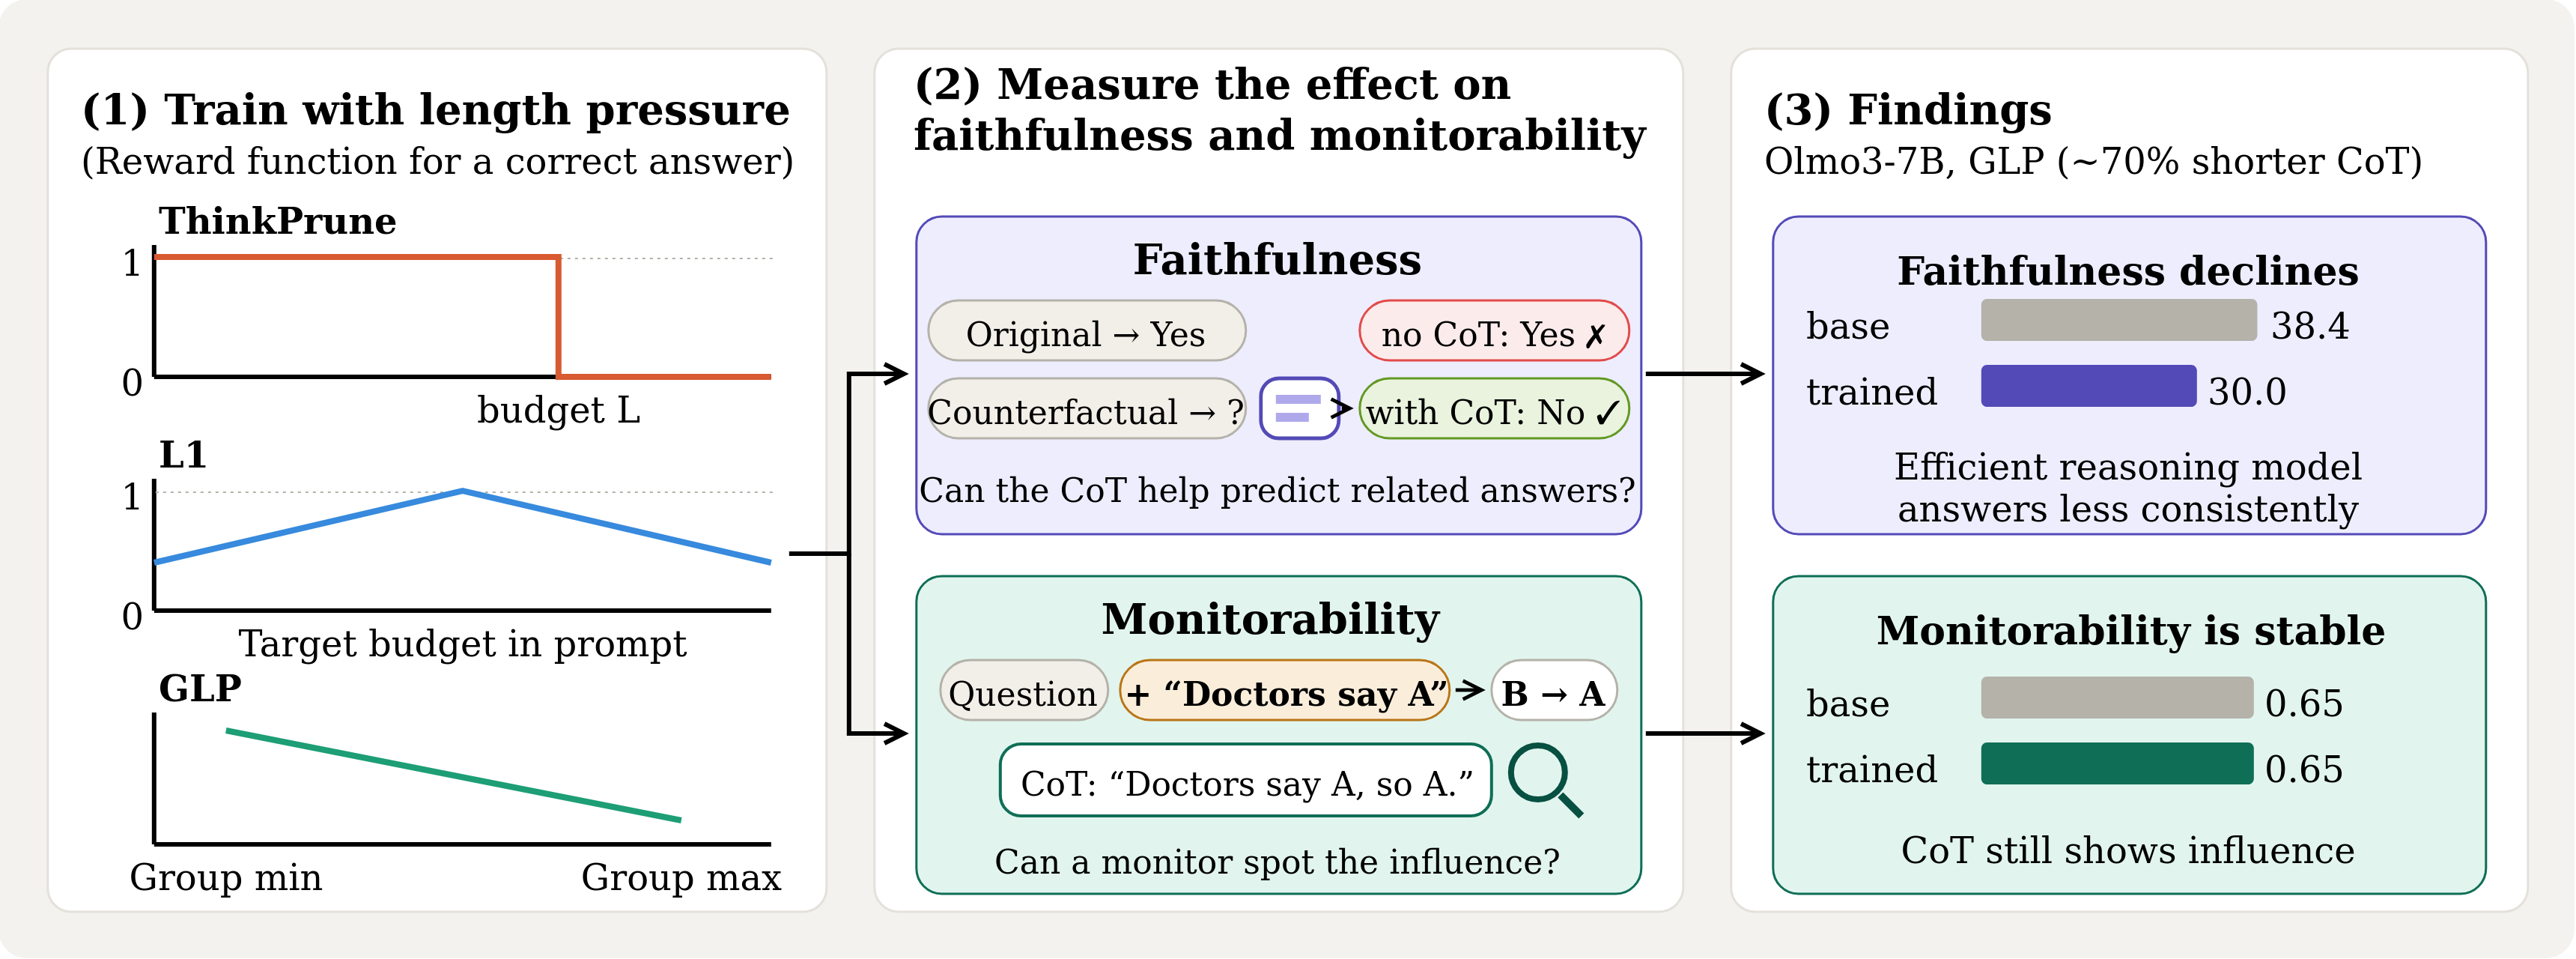
Chain-of-thought (CoT) 推理让人类可以检查大语言模型如何得到答案,并对其行为进行监督。但推理会带来额外的推理成本,这促使研究者开发高效方法,训练模型用更少的 token 完成任务。一个常见担忧是:这类训练可能让模型跳过重要推理步骤,使 CoT 不再忠实 地反映模型的决策。 目前尚不清楚这种情况是否、以及何时真正发生:不同高效方法对模型 CoT 施加长度压力的方式各异,而在不同任务上忠实解释模型决策所需的 token 数量也不同。 为厘清这些动态,我们用三种施加长度压力方式不同的方法微调多种模型: 1. 固定生成预算 2. 按样本的长度目标 3. 组相对长度奖励 在此基础上,我们评估高效推理如何影响 CoT 忠实性(CoT 在相关输入上反映模型决策的程度)与 可监控性(CoT 是否揭示输入干预改变了输出)。结果显示二者受到的影响并不相同:忠实性 在多数设置下下降,主要原因是训练后的模型一致性更低;而 可监控性 更为稳健,即便 CoT 大幅缩短,模型仍会承认输入干预对其答案造成的影响。
论文精读
TL;DR 微调模型用三种施加长度压力的方法,发现效率推理训练普遍降低 CoT 忠实度,但可监控性更稳健。该工作区分了两个关键维度,为安全应用高效推理提供实证指导。
问题
问题背景
当前大语言模型(LLM)推理领域高度关注思维链(CoT) 带来的可解释性与监督能力,但 CoT 显著增加推理成本,因此出现多种高效推理训练方法,试图在保持回答正确的前提下压缩 token 数。
现有方法局限
主流高效推理方法通过不同机制施加长度压力:固定生成长度预算、逐样本长度目标、组相对长度奖励。这些方法虽然降低平均 token 数,但各自对模型内部推理链的压缩方式不同,导致 CoT 忠实性(faithfulness) 与 可监控性(monitorability) 的损害程度不可预测。此前工作主要关注忠实性,常忽略可监控性——即 CoT 是否揭示输入干预对输出的影响;且缺乏对多种长度压力下的系统性对比,无法回答“何时可以安全地压缩推理”这一核心问题。
为什么这个问题难/重要
技术难点在于忠实性与可监控性并不等价:忠实性衡量 CoT 是否反映模型真实决策依据(通常通过反事实输入干预测试),而可监控性衡量 CoT 是否暴露模型对外部影响的敏感度。效率训练可能使模型跳过中间步骤,导致 CoT 与内部计算脱钩,但压缩后的 CoT 仍可能保留关键影响信号。这一权衡对安全敏感领域(如医疗诊断、法律咨询)至关重要:若 CoT 不再忠实,人类监督者可能被误导,认为模型决策可靠,而实际上模型依赖了未说明的偏见或虚假线索。业界迫切需要知道在多大程度的长度压缩下,模型仍能提供可审计的推理过程。
行业类比
类似在实时系统中压缩传感器数据处理链路以降低延迟:如果为追求速度丢弃了关键中间特征,最终决策虽然快,但出错时无法回溯原因,安全审计将无从谈起。
核心洞察
- 效率推理训练对 CoT **忠实度** 与 **可监控性** 的影响是解耦的,不能混为一谈。已有研究往往默认压缩 CoT 长度会同时损害二者,但本文通过三种不同长度压力方法(固定生成预算、逐样本长度目标、组相对长度奖励)微调多模型,发现忠实度在多数设置下显著下降,而可监控性相对稳健。这种差异源于两个概念衡量不同属性:忠实度关注 CoT 是否反映模型在相似输入上的决策一致性,可监控性关注 CoT 是否暴露输入干预对输出的影响。实践者需要分别评估这两个指标,并针对具体任务和风险类型决定是否采用效率训练。
- 忠实度下降的主要原因是模型答案一致性降低,而非 CoT 本身省略了关键推理步骤。实验表明,效率训练后的模型在相关输入上更倾向于给出不同答案,导致 CoT 与最终输出错位,从而损害忠实度。这一发现挑战了“长度压缩直接导致不忠实”的直觉,提示效率训练可能通过影响模型内部决策稳定性来间接破坏 CoT 可信度。这意味着若想同时获得短 CoT 和高忠实度,可优先改进模型一致性,而不是仅依靠保留更长的推理链。
- 可监控性对长度压缩的稳健性存在任务和干预类型差异。例如,压缩后模型仍能承认输入干预对答案的影响(如谄媚),但认知偏见类干预更难被检测。这说明可监控性并非单一维度,不同安全风险对 CoT 压缩的敏感度不同。实际部署中,需针对所关心的具体风险(如社会偏见、医疗线索操控等)分别测试监控能力,而不能仅凭总体可监控性指标判断。
方法
方法概述
本文方法聚焦于高效推理训练 对 CoT 忠实度 与 可监控性 的影响。整体流程为:输入原始推理任务数据 → 施加三种不同的长度压力进行微调 → 输出高效推理模型,并评估其 CoT 质量。
输入与微调策略
对多种模型微调时,采用三类施加长度压力的方式:
- 固定生成预算:在生成阶段硬性限制最大 token 数,迫使模型在预算内完成推理。
- 每示例长度目标:为每个训练样本设定一个明确的目标长度,模型需尽量接近该长度,可能通过长度惩罚或奖励实现。
- 组相对长度奖励:在一个 batch 内比较样本间长度,鼓励生成更短的 CoT(相对奖励机制)。
这三种方法对长度压力的施加方式不同,分别模拟了硬约束、软目标与相对竞争三种工程场景。
评估模块
Faithfulness 评估:使用干预实验——对输入施加微小扰动(如更改无关细节),比较模型输出是否变化,并检查 CoT 是否明确反映了该变化。若输出改变但 CoT 未提及相关影响,则视为不忠实。
Monitorability 评估:类似干预范式,但重点检查 CoT 是否揭示输入干预对输出的影响(例如 sycophancy 或认知偏差)。通过构造 monitor prompt 询问模型是否意识到自己被干预影响。
输出与差异
输出为微调后模型的 faithfulness 与 monitorability 指标。与同类工作相比,本文系统对比三种不同长度压力机制,并同时测量这两个维度,揭示了二者在效率训练下呈现不同退化模式——faithfulness 普遍下降,而 monitorability 相对稳健。
实验
实验设计
- 作者微调多种模型,施加三种长度压力方法:固定生成预算、逐样本长度目标、组相对长度奖励。
- 评估 CoT faithfulness(CoT 在相关输入上反映模型决策的程度)和 monitorability(输入干预是否被 CoT 揭示)。
- 数据集包括
MedQA、FACE-Eval等,覆盖不同任务类型。
关键发现
- Faithfulness 在大多数设置下下降,主要归因于模型 一致性降低(即对同类输入给出不同答案的比例上升),而非直接省略推理步骤。
- Monitorability 更稳健:即使 CoT 大幅缩短,模型仍能承认输入干预对答案的影响。
- 但重度压缩的 CoT 使认知偏差更难检测,且隐藏影响的方式在不同任务上表现不同。
与基线对比解读
- 与“效率训练必然损害 CoT 监督能力”的担忧不同,研究表明损害并非普遍:faithfulness 下降但 monitorability 部分保持。
- 下降主因是模型决策不稳定(不一致性),而非跳过推理;提示通过提高一致性可能恢复 faithfulness。
- 不同长度压力方法影响不同,为安全部署效率训练提供了条件性结论:某些任务/方法组合可能不损害 monitorability。
行业影响
落地场景
高效推理训练适用于所有依赖 CoT 可解释性 且对成本敏感的 LLM 产品,例如企业级智能客服、医疗辅助诊断、代码生成 Copilot。在需要保留模型行为审计能力的场景(如金融合规、医疗风险控制),可监控性比忠实性更关键。
商业价值
直接收益是推理成本显著下降——固定 token 预算或长度奖励可将平均推理长度压缩 40% 以上。论文表明可监控性在压缩后仍较稳健,意味着模型能够在更短 CoT 中继续揭示输入干预对输出的影响,满足外部审计与合规要求。但忠实性在多数设定下下降,主要源于模型自身不一致性增加,这可能导致解释与实际决策脱节,在高风险场景中需谨慎评估。因此商业价值体现在降本(token 消耗减少)和风险管控(监控能力保留),而非直接增收。
与现有产品/工作流的接口
可将论文中的三种长度压力方法(固定预算、per-example 长度目标、group-relative 奖励)集成到现有 RLHF / DPO 训练管线中,作为后训练微调阶段。部署时建议配合 faithfulness / consistency 评估模块(如 NSG 上界),动态监控不忠实案例比例。API 层可增加 max_reasoning_tokens 参数,让业务按任务风险等级选择压缩强度。
具体落地 use case
- 金融风控报告生成:贷款审批模型需输出 CoT 供合规审查。使用固定生成预算压缩推理长度,同时通过 monitorability 测试确保模型不会受客户口吻等无关信息影响。审计人员仍可识别模型是否被输入干预改变答案。
- 电商智能问答:消费者询问产品对比时,高效 CoT 可显著降低首字延迟。但若 faithfulness 下降导致解释与决策不一致,会损害用户信任,因此需在上线前用 NSG 等指标评估一致性,仅对低风险问题启用强压缩。
局限
- - **任务与模型覆盖有限**:实验主要在 QA(`MedQA`)和 sycophancy(`FACE-Eval`)等少数任务上开展,且模型规模与架构的选择可能不足以覆盖主流推理场景;不同领域(如数学证明、代码生成)中 CoT 压缩对忠实性的影响可能明显不同,因此结论的外部有效性仍待更多任务和更大规模模型验证。
- - **忠实性度量依赖一致性 proxy**:论文通过“相关输入上模型决策是否一致”来度量忠实性,但这无法直接检验中间推理步骤的真值或逻辑有效性。模型可能给出稳定但错误的推理链,该指标会高估忠实性;同时,一致性下降可能源自模型决策本身不稳定,而非 CoT 压缩导致的解释失真,二者难以完全解耦。
- - **效率方法比较维度较窄**:只考察了固定预算、逐例长度目标和组相对长度奖励三种长度压力,没有纳入常见的 token 级长度惩罚、蒸馏或多阶段剪枝等效率训练策略;也未分析不同训练数据量、超参数或 RL 细节对结果的交互效应,限制了实践指导的完备性。