KaliBench: 面向 Kali Linux 网络安全工具使用的细粒度基准与免运行时可验证奖励
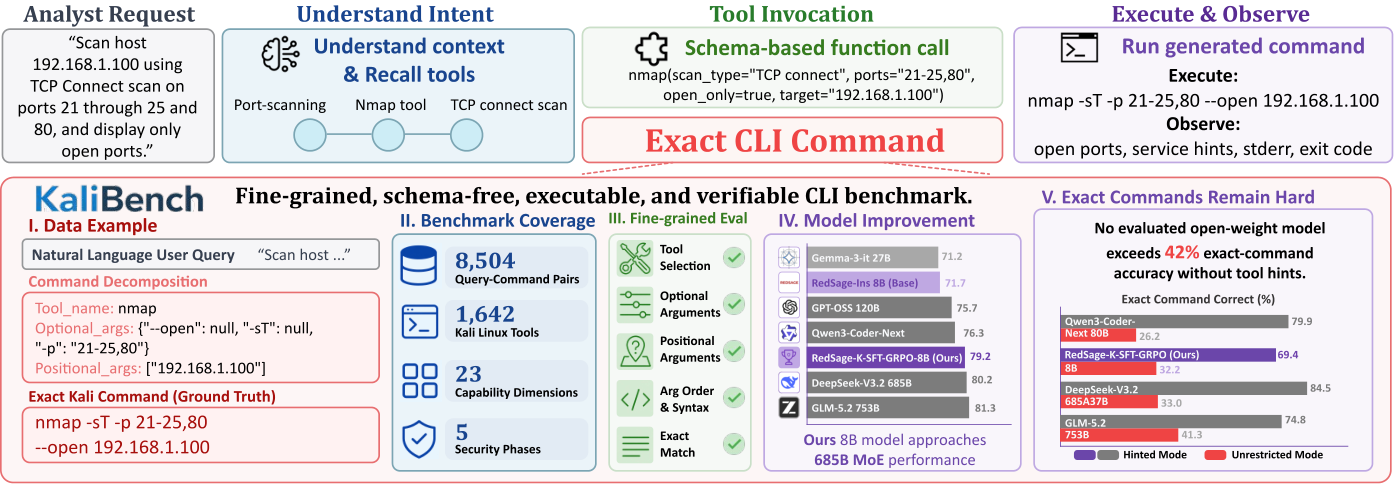
LLM 正越来越多地应用于网络安全工作流,需要把分析人员的意图转化为工具调用。然而现有评测多聚焦于知识型问答或端到端 agentic 任务,并未直接衡量 LLM 为真实网络安全工具生成可执行命令的能力。这一空白至关重要,因为安全操作依赖严格的命令行界面(CLI),细微的语法错误、错误的 flag--value 绑定或参数顺序颠倒都会导致执行失败。 为此,我们提出 KaliBench,一个面向 Kali Linux 自然语言到 CLI 翻译的细粒度基准与数据集,包含 8,504 条 query--command 对,覆盖 1,642 个工具、23 个能力维度与 5 个安全阶段。KaliBench 通过基于文档的构建管线、确定性规范化与别名感知评测,实现对工具选择与参数构造的精确可复现评估。为兼顾语义正确性与实际可执行性,我们设计了多阶段验证流程,结合 LLM 校验、沙箱终端执行与人在回路精修。 基于上述细粒度、确定性的信号,KaliBench 还能提供免运行时可验证奖励(runtime-free verifiable rewards)用于训练。在三种评测模式、通用与安全专用开源权重模型的 24 种配置下,无限制设定中没有模型超过 42% 的精确命令准确率,凸显了在缺乏显式工具提示时准确使用 CLI 安全工具的难度。我们进一步表明,使用 KaliBench 衍生的可验证奖励进行监督微调与强化学习,可显著提升 8B 模型,并达到与 685B MoE 模型相当的性能。
论文精读
TL;DR KaliBench 是一个面向 Kali Linux 的自然语言到 CLI 翻译基准,含 8,504 条命令对,通过确定性规范化和别名感知评估精准衡量工具选择与参数构造,并提供 runtime-free 可验证奖励用于训练,使 8B 模型微调后比肩 685B MoE。
问题
问题背景
LLM 在网络安全自动化中的角色正从知识问答扩展到执行层,业内期待模型能将分析师意图直接转换为可执行的 CLI 命令。
现有方法局限
- 知识类评测(如认证题库)只考察概念记忆,不涉及真实工具调用语法。
- 端到端代理任务以最终成败为信号,无法区分工具选择错误、参数拼写错误或流程规划错误,也难以提供细粒度奖励。
- 命令结构正确性 与 参数绑定 缺少确定性校验,导致模型可能在真实环境中因一个 flag 拼写错误而完全失败。
为什么这个问题难/重要
网络安全 CLI 工具数量庞大、参数命名不规则,同一功能有多种等价写法(别名、简写、顺序变化)。模型必须同时理解自然语言意图、工具文档和严格 shell 语法,任何微小偏差都会导致命令无效。真实执行需要沙箱环境,训练阶段难以提供可微或可验证奖励,限制 RLHF 等技术应用。因此,需要一种细粒度、确定性评估方法,既能量化工具选择与参数构建能力,又能为训练提供运行时无关的可验证奖励。
行业类比
类似自然语言到 SQL 或 Kubernetes 命令的精确生成任务,但网络安全工具空间更大、更碎片化,且错误代价更高——正如模型生成可编译代码而非语义近似。
核心洞察
- KaliBench 首次直接度量 LLM 生成可执行网络安全 CLI 命令的能力,暴露了通用模型在严格命令行语法下的严重不足。现有网络安全基准多评估知识问答或端到端 agent 任务,未聚焦于真实工具的命令构造。KaliBench 通过细粒度标注每个查询对应的工具、选项和参数,并在无提示开放设置下发现开源模型精确命令准确率不足 42%,揭示了意图到 CLI 翻译中微小的 flag 绑定错误或参数顺序错误即导致执行失败的独特挑战。
- KaliBench 将细粒度、确定性的命令级评估转化为 runtime-free verifiable rewards,使监督微调和强化学习无需实际终端执行即可获得密集训练信号。与依赖轨迹级奖励或端到端成功率的 agentic 训练不同,该方法逐命令提供 tool、option 和 positional argument 的 F1 分数,避免了沙箱运行开销与奖励稀疏问题。实验证明,基于 KaliBench 的 SFT+RLVR 能让 8B 模型达到 685B MoE 模型的性能,显示细粒度可验证奖励在提升真实工具调用能力上的高效性。
方法
KaliBench 的输入是分析师的自然语言查询(如「扫描目标主机的开放端口」),可选提供工具提示(tool hints),输出为对应的 Kali Linux CLI 命令。
关键模块
- 数据生成管线:基于 Kali Linux 工具手册(manuscript-grounded)自动提取工具语法、选项和参数约束,生成查询-命令对。随后进行确定性规范化(deterministic canonicalization)与别名感知处理,确保同一命令的不同等价写法被归并,消除评估歧义。
- 多阶段验证:候选命令对依次经过 LLM 辅助验证(语义合理性)、沙箱终端执行(检查命令可运行性)和人机协同修正,剔除语法错误、参数遗漏或语义不匹配的样本,得到干净数据集。
- 评估协议:设计三种评估模式( unrestricted、tool-hinted 等),计算精确命令匹配准确率、工具选择得分、位置参数与可选参数 F1 等细粒度指标,兼顾工具选择和参数构造。
- 训练协议:利用细粒度确定性信号生成运行时无关可验证奖励(runtime-free verifiable rewards),用于监督微调(SFT)与强化学习(RLVR),无需实际执行即可提供训练信号。
输出
模型生成 CLI 命令,由评估指标量化其准确性;训练后的模型在 KaliBench 上显著提升命令生成能力。
与同类工作的差异:现有网络安全基准多侧重知识问答或端到端 agent 任务,而 KaliBench 直接度量细粒度 CLI 生成准确性,并提供可复用的确定性奖励信号。
实验
实验设计
KaliBench 包含 8,504 条自然语言到 CLI 命令的查询-命令对,覆盖 1,642 个工具、23 个能力维度和 5 个安全阶段。数据集通过 manuscript-grounded pipeline 构建,结合确定性规范化与别名感知评估,确保工具选择和参数构造的可复现测量。评测设置三种模式(无限制、工具提示、执行模式等)和 24 种模型配置。训练协议利用该基准的细粒度确定性信号,实现 runtime-free verifiable rewards,用于监督微调与强化学习。
关键发现
- 在 unrestricted setting 下,所有开源权重模型的精确命令准确率均未超过 42%,表明缺乏工具提示时 CLI 级网络安全工具使用极具挑战性。
- 通过 KaliBench 衍生奖励的 SFT+RL 显著提升 8B 模型,达到与 685B MoE 模型相当的性能。
- 细粒度分析显示常见失败模式包括错误 flag-value 绑定、参数顺序错误和语义不匹配。
基线对比解读
与现有知识评估或端到端 agentic 基准不同,KaliBench 直接度量 NL-to-CLI 翻译能力,填补了评估空白。传统基准往往只关注最终任务完成,忽略了命令语法正确性这一关键环节。KaliBench 的确定性奖励信号可用于训练,且无需运行时环境即可计算,降低了训练成本。42% 的上限说明当前开源模型对网络安全 CLI 的掌握远未达到实用水平,工具提示或专门训练可带来显著提升。
行业影响
落地场景
KaliBench 可直接嵌入 AI 驱动的安全运营中心 (SOC) 与 SOAR (安全编排自动化与响应) 产品,用于评估并提升 LLM 将自然语言任务描述转译为 可执行 CLI 命令 的能力。典型场景:
- 安全分析师助手:接收“扫描子网
10.0.0.0/24的开放端口,结果导出为 JSON”,自动生成nmap命令。 - 威胁狩猎与响应剧本生成:根据告警描述生成
tcpdump、snort等工具的精确参数,减少手工构建。 - 自动化渗透测试工具:将测试步骤描述转换为
metasploit、hydra等工具的合法调用。
商业价值
主要降本线:减少安全分析师在 CLI 语法调试、工具选型上的时间,降低因 flag 误用或参数顺序错误导致的执行失败与重复操作。在安全运营中,命令错误可能引发漏报或系统不可用,KaliBench 的 运行时无关可验证奖励 使模型可在无需实际执行恶意/敏感命令的情况下进行大规模训练与评估,既安全又高效。对于安全厂商,可作为模型能力准入的 硬指标,提升产品自动化水平与客户信任。
与现有工作流接口
可集成方式:
- 评估关卡:在 LLM 安全应用发布前,用 KaliBench 的 3 种评估模式(无提示、工具列表提示、完整工具定义提示)做回归测试,防止命令生成退化。
- 微调数据:基于其确定性 canonicalization 生成 (query, command) 对,用于 SFT 或 RLVR,论文显示 8B 模型微调后接近 685B MoE 性能,说明小模型即可用于边缘/合规敏感场景。
- SOAR 插件:作为 prompt 优化与 few-shot 示例库,提升现有多智能体安全系统中 tool calling 模块的准确率。
具体 use case:某电商平台的安全巡检机器人,需每日对暴露面资产进行端口扫描与 TLS 证书检查。集成 KaliBench 微调后的模型,可将运维人员自然语言工单直接转为可执行的 nmap、testssl.sh 命令,并将结果结构化回传,误操作率大幅下降。另一场景:金融机构的合规审计助手,自动将“检查所有服务器是否禁用 root SSH 登录”转为 sshd_config 检查与 ssh 命令,减少人工审计成本。
局限
- **覆盖范围与平台泛化局限**:KaliBench 构建于 Kali Linux 软件仓库,覆盖 1,642 个工具,但网络安全实际工作流常涉及自定义脚本、非标准 CLI 或跨平台工具(如 Windows PowerShell、云原生 CLI)。该基准的评估协议与规范化规则针对 Debian 系发行版设计,难以直接迁移到其他操作系统或容器化环境。论文未在非 Kali 平台进行交叉验证,因此模型在 KaliBench 上的表现无法完整代表真实安全运营中的跨平台工具使用能力。这一缺口限制了该基准作为通用 CLI 评估工具的适用范围。
- **评估刚性与语义灵活性不足**:评估依赖确定性规范化与 exact-command accuracy,虽然保证了可复现性和精确性,但可能低估语义等价但语法不同的命令。例如参数顺序调整、旗标缩写(`-p` vs `--port`)、等效管道写法等在真实终端中合法且常见,却无法被当前计分逻辑捕获。这种刚性偏向记忆特定命令模板,而非理解任务意图与工具语义。论文未提供语义等价评估的消融,可能导致模型在真实场景中生成可执行但被误判为错误的命令,从而限制了对模型泛化能力的测量效度。
- **数据集静态性与维护成本**:KaliBench 提供的可验证奖励依赖于预先构造的规范化命令对,数据集时效性容易滞后于工具版本迭代(新旗标、弃用参数、行为变更),导致基于该奖励训练的模型面对快速演进的网络安全工具时性能衰减。此外,多阶段验证流程中的 human-in-the-loop 虽提升了数据质量,但扩展与更新成本较高,难以持续跟进 Kali 滚动更新。论文未讨论数据集长期维护机制或增量更新协议,这可能影响基准的长期可持续性和对新兴工具的覆盖能力。