ScholarCatalyst: 一个用于检索启发新研究的论文的基准
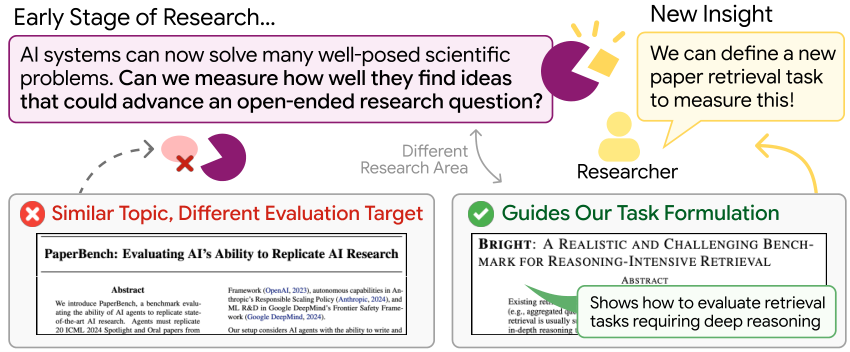
什么让伟大的科学家伟大?即便 AI 系统已开始在开放问题上取得进展,科学家在判断一个新问题需要哪些埋藏在不断增长的研究档案中的既有想法时,仍遥遥领先于它们。 为研究这一能力,我们借助那些亲身了解哪些早期工作推进了自己已完成项目的研究者,以论文作为指向其中想法的指针。通过一套让作者标注可规模化的自动化流程,我们构建了 ScholarCatalyst:邀请 207 篇近期计算机科学论文的 184 位主要作者,标注哪些候选论文曾经或本可以推进其项目,并为每条标注给出详细理由。 我们提出一项带有作者判断的检索任务:给定一个初始研究问题,仅从项目启动时已存在的文献中检索这些论文。 - Agentic search 并不优于 embedding retrieval(0.42 vs. 0.48 Recall@20),尽管它把同一个检索器当作工具来调用。 - 即便基于 Claude Fable 5.1 构建、可能在训练中见过这些已完成论文的 agent,也只达到 0.51 R@20。 这些结果凸显出:需要新的训练配方,使模型具备在大规模语料中检索的专家直觉。我们设想 ScholarCatalyst 成为迈向科学 agent 的一步——它们能接过一个半成形的想法,并指出其所需要的先前研究。
论文精读
TL;DR ScholarCatalyst 基准由 184 位作者标注 207 篇论文的启发来源,评估从研究问题检索推动新研究的论文;当前最强智能体与检索仅达 0.51 R@20,揭示科学搜索直觉明显不足。
问题
问题背景
当前 AI for Science 与 LLM 驱动科学发现 是热点方向,研究者希望通过模型自动从海量文献中筛选出能激发新想法的先前工作,加速科研循环。
现有方法局限
- 主流科学文献检索依赖稠密向量检索或基于引用的图方法,它们捕捉语义相似性或直接引用关系,但无法建模“这篇论文是否能激发未来研究”这种间接、非对称的启发关系。
- 代理式搜索(agentic search)虽能调用检索工具并多次迭代,但 ScholarCatalyst 实验显示其
Recall@20仅为 0.42 到 0.51,与纯嵌入检索相当,说明现有 LLM 缺少将“半成品研究问题”映射到相关前置工作的专家直觉。 - 缺乏以作者亲身判断为监督信号的基准,已有数据集多基于自动构造的伪相关,无法评估“灵感检索”质量。
为什么这个问题难/重要
- 难在研究问题与最终论文中的关键前置工作之间关系复杂,常依赖研究者对领域脉络的隐性知识,无法用简单关键词匹配或语义相似度刻画。
- 文献增长速度超出人工阅读能力,需系统能主动推荐“可能推动当前项目”的论文,而非仅返回相关文档。
- 业界关注:若模型具备此类能力,可成为科研助理,缩短文献调研时间,提升 idea 验证效率,推动 AI for Science 落地。
行业类比
类似于推荐系统中的**“灵感推荐”**,不是推荐用户已看过的相似内容,而是推荐能打开新方向的内容,例如从代码仓库自动推荐可复用的设计模式或架构方案。
核心洞察
- 作者标注的'催化剂论文'作为相关性判断,把检索任务从找相似文献变为找回能启发后续研究的先前想法。与基于引用或主题相似度的基准不同,ScholarCatalyst 让近期论文作者标注哪些候选论文本可推进其项目并给出理由,这些论文未必被引用却是项目早期缺失的关键线索。该基准考察从初始问题出发、只看项目前文献的预发现检索,更能反映科学家的关键想法感知能力。
- 即使给 LLM 智能体配上同一个嵌入检索器作为工具,其 Recall@20 仍低于纯嵌入检索(0.42 对 0.48),而可能见过完成论文的 Claude Fable 5.1 也只有 0.51。这说明当前智能体在宽泛语料库中缺乏专家搜索直觉,叠加工具调用循环无法弥补差距。与许多展示智能体搜索优于简单检索的工作相比,该结果揭示预发现检索的难度:初始想法半成形时,模型难以判断哪些已有工作值得深挖,需要新训练配方注入这种感知能力。
- 自动标注流水线先让 LLM 预生成候选催化剂论文与理由,再由作者验证修正,使大规模获取高质量作者判断成为可能。相比纯人工标注或纯 LLM 合成,这种半自动流程既保证标签来自真正完成项目的作者,又控制成本,可作为领域专家参与基准构建的模板,并避免仅依赖引用或相关度模型造成的偏差。
方法
输入与任务定义
每个基准实例以一篇已完成论文为锚点,输入包括:作者当年的初始研究问题 (R0)、项目启动时间 (T0)、以及项目完成后作者认可的催化剂论文 (catalyst papers) 列表,并附每条催化关系的详细理由 (rationale)。任务设定为 pre-discovery retrieval:在 T0 之前已发表的候选文献库中,仅依据 R0 检索能启发该研究的论文。
关键模块
- 自动化构建流水线:从源论文中抽取出研究问题与时间戳,生成预标注候选集。模块包括
source-paper processing、pre-annotation generation、candidate retrieval、author validation。 - 作者验证与标注:招募 184 位 lead authors,对预标注结果进行确认/修正,补充 catalyst 判断与 rationale;这是 ScholarCatalyst 区别于引用关系监督的核心。
- 评估协议:使用多种检索器(如 embedding、BM25)与 LLM 重排、查询改写、agentic search(tool-calling、deep research、grep 等)作为基线,输出排序列表,并以
Recall@20为主要指标。
输出
最终输出是给定 R0 下按相关性排序的论文列表,目标是尽量把 catalyst papers 排进 top-20。
差异点
与多数科学文献检索基准使用引用或语义相似度作为弱监督不同,ScholarCatalyst 采用作者一手判断定义“启发新研究”,并严格限制在项目启动前文献,更贴近真实科研直觉。
实验
实验设计
- 构建 ScholarCatalyst:由 184 位近期 CS 论文 lead authors 标注 207 个项目中哪些候选论文推进了研究,并提供 rationale。
- 检索任务:给定初始 research question,从项目开始前可用文献中检索这些“催化剂”论文。
- 评估指标:Recall@20。
- 基线:embedding retriever、调用同一 retriever 的 agentic search、基于 Claude Fable 5.1 的 agent。
关键发现
- embedding retriever 达到 0.48 R@20;
- 调用同一 retriever 的 agentic search 仅 0.42 R@20,未超过 embedding;
- 基于 Claude Fable 5.1 的 agent 即使可能见过完成论文,也仅 0.51 R@20。
深度解读
检索性能普遍偏低,说明现有模型缺乏专家式的文献直觉,难以把半成形想法与相关先前工作关联。Agentic search 具备工具调用,却反而更差,表明通用指令跟随能力不足以应对 broad corpora 搜索,需要专门训练配方。与仅用 citation 或 query-document 匹配的数据集不同,ScholarCatalyst 的 author firsthand account 提供更真实的“灵感来源”监督,为科学 agent 的检索评估提供了新维度。
行业影响
落地场景
- 科研文献推荐与发现 可应用于企业研发部门、学术搜索引擎(如 Semantic Scholar、Elicit)及技术情报监控工具。
- AI 辅助创新 集成到研发知识管理平台,帮助工程师从历史论文中挖掘可迁移的方法,尤其适合跨学科探索。
商业价值
- 降本 减少手动文献综述时间,降低研发人员时间成本。
- 增效 加速从 idea 到 prototype 的迭代,提高创新产出率。
- 体验提升 提供作者标注的 rationale,增强检索结果的可解释性与信任度。
与现有产品/工作流的接口
- 可作为 RAG pipeline 中检索器的评测基准,或用于微调 embedding 模型与 agentic search 策略。
- 通过 API 接入现有向量数据库(如 Pinecone、Weaviate),在查询阶段融合作者视角的相关性信号。
- 具体场景:某电商平台技术团队在优化推荐系统时,用该系统检索历史论文中关于序列建模或冷启动的可复用思想;某生物科技公司用其从文献库中定位某靶点研究的先导工作,加速新药立项论证。
局限
- - **领域覆盖与标注偏差**:ScholarCatalyst 仅包含 207 篇近期 CS 论文,由 184 位 lead author 标注,领域集中在 AI/CL/IR,可能无法代表物理、化学、生物等学科的文献引用模式;作者回忆哪些 earlier work 启发自己项目,存在 hindsight bias 和选择性记忆,且仅邀请 lead author 可能遗漏其他合作者的关键输入。
- - **评估协议单一与潜在泄漏**:主指标为 Recall@20,主要衡量候选列表是否包含 catalyst paper,但无法精细评估 inspired 程度或理由质量;论文承认 Claude Fable 5.1 可能在训练时见过 completed papers,存在 benchmark leakage 风险,使得部分模型的 Recall 不能完全反映其从零检索能力,削弱了与未来更严格协议的可比性。
- - **agentic search 结果有限**:文中 agentic search 仅与 embedding retrieval 相当,但实验的 agent 主要调用同一 retriever 作为工具,搜索策略、查询改写和阅读能力的上限未被充分探索;并且成本/搜索 effort 分析表明深度研究 agent 开销大,实际可复现性受限,难以迁移到大规模生产环境。