SILSA:面向拓扑保持高分辨率 3D 生成的滑动窗口切片潜变量
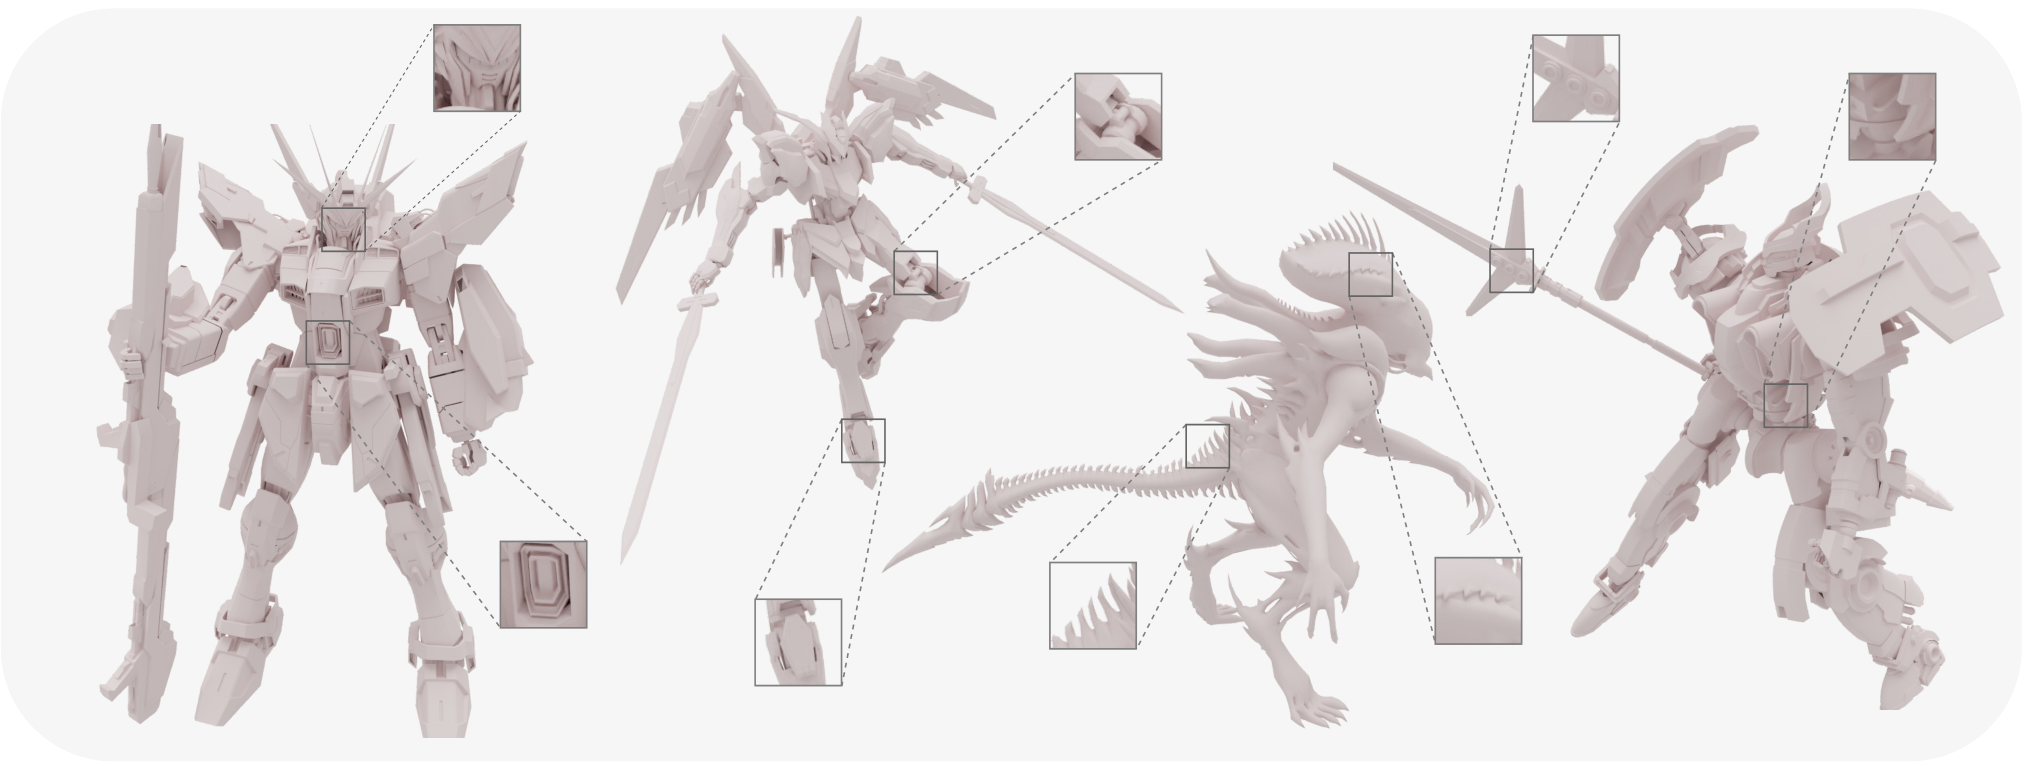
高分辨率 3D 生成日益依赖 voxel latents 与多阶段流水线:先预测活跃结构,再合成局部几何。这种设计虽然有效,却把连续表面切碎成大量局部 token,推高生成成本,并常常削弱薄型或高连通形状的拓扑一致性。 为应对上述问题,作者提出 SILSA,一个拓扑感知的 3D 生成框架,用紧凑的滑动窗口切片潜变量表示形状。SILSA 不再生成昂贵的 voxel token,而是沿三条标准轴取一组固定的重叠切片,其中每个 token 概括一个局部深度窗口,以保持截面连续性并支持单阶段 rectified-flow 生成。Slice VAE 将有向表面采样编码为多轴切片潜变量,并用稀疏体素解码器重建;Volumetric Anchor Lattice 则在共享的 3D 工作空间中协调各方向的切片流。为保持结构正确性,作者引入切片级拓扑监督,匹配 persistence diagrams 并对齐相邻切片间的 Betti 跃迁。 实验表明,SILSA 在提升结构保真度的同时大幅降低生成成本: - 相比最强基线,PSNR 提升 8.7%,coverage 提升 5.96 个绝对点,Betti error 降低 9.2%; - token 用量比次紧凑的基线少 70.0%,比稀疏或层次化 tokenizer 少 98% 以上; - 训练内存减少 40.4%,推理时间减少 58.5%。 定性结果进一步显示,薄结构、重复部件与长程连通性都得到了更好的保持。
论文精读
TL;DR SILSA 用滑动窗口切片潜在表示替代体素 token,在保持拓扑一致性的同时将 token 成本降低 70% 以上,并实现单阶段高分辨率 3D 生成。
问题
问题背景
高分辨率 3D 生成 正转向体素潜变量表示与多阶段流水线,力求在有限 token 预算下重建细粒度几何。
现有方法局限
当前主流方案(稀疏体素 / 分层 tokenizer)普遍采用“先预测 active structure 再合成局部几何”的策略,将连续表面切割成大量局部 token。具体缺陷包括:
- 拓扑一致性弱:薄壁、多连通或重复结构在局部合成时容易断裂或错连,导致 Betti 数误差 偏高;
- 生成成本高:token 数量大,训练内存与推理时间显著增加;
- 跨截面连续性差:局部 token 难以保证相邻切片的几何与拓扑过渡自然。
为什么难 / 重要
保持拓扑正确性需要显式建模形状的全局结构,而传统体素表示天然局部化。滑动窗口切片潜变量 尝试用少量重叠切片 token 编码深度窗口内的截面连续性,但多轴切片如何在共享 3D 工作空间中协调、如何对切片级 持久图 进行监督,仍是开放挑战。业界对可扩展 3D 资产生成(游戏 / 数字孪生 / 影视)有强烈需求,需要既能控制 token 成本又能保证薄结构与长程连接性的生成框架。
行业类比
类似图像生成从 VQ-VAE 离散 token 到连续扩散模型的演进,核心矛盾都在于在 token 效率与结构保留之间取得平衡;3D 生成中的切片潜变量可类比为对几何结构做“有拓扑约束的压缩”。
核心洞察
- SILSA 的核心洞察是用轴向滑动窗口切片潜在替代体素潜在,从根本上压缩 token 规模并保留截面拓扑。与现有方法将表面碎片化为局部体素 token 或多阶段预测不同,切片沿三个轴概括局部深度窗口,捕获跨截面的连续性,使单阶段整流流生成成为可能。实验显示 token 数量比最紧凑基线少 70%,比稀疏/层次 tokenizer 少 98% 以上,同时 PSNR 提升 8.7%。该表示将拓扑先验编码进数据结构,降低了后续生成对复杂架构的依赖。
- 另一个关键洞察是引入切片级拓扑监督,显式匹配持久图并对齐相邻切片的 Betti 转移。传统 3D 生成依赖重建损失或对抗损失,难以约束拓扑正确性,导致薄结构断裂或连通性丢失。SILSA 在切片级别比较拓扑特征,使得生成器在训练中直接学习保持全局结构,Betti 误差降低 9.2%。这种可微拓扑损失为其他需要结构保真的生成任务提供了新思路。
方法
输入与表征
SILSA 接收定向表面样本(oriented surface samples),而非密集体素网格。核心思想是将连续表面压缩为滑动窗口切片隐变量(sliding-window slice latents):沿三个规范轴分别取一组固定数量的重叠切片,每个 token 概括局部深度窗口内的截面结构,从而在紧凑表征中保留跨切片连续性。
关键模块
- Slice VAE:编码器将多轴方向表面样本编码为切片隐变量,解码器采用稀疏体积解码器(
sparse volumetric decoder)重建体素/网格输出。这避免了逐体素 token 生成,大幅降低计算开销。 - Volumetric Anchor Lattice(VAL):共享 3D 工作空间中的体积锚格,用于协调不同轴的切片流,让方向性切片隐变量在统一空间中对齐,避免多轴表征相互冲突。
- 切片级拓扑保持损失:匹配持续图(persistence diagrams),并对齐相邻切片的 Betti 数转移,显式监督拓扑结构,防止薄壁或高连接形状断开。
生成流程
采用单阶段 rectified flow 生成,直接预测多轴切片隐变量;训练时通过拓扑损失同时约束 VAE 与生成模型。输出为高分辨率 3D 形状。相比多阶段管道,单阶段流程减少结构碎片化,并降低训练内存与推理时间。
与同类方法的差异
与现有 voxel latent 或多阶段 pipeline(先预测活跃结构再合成局部几何)不同,SILSA 用紧凑重叠切片 token 替代稀疏/层级体素 token,以约 70% 更少 token 实现更高 PSNR 与更低 Betti 误差,同时保持薄结构与长程连接。
实验
实验设计
- SILSA 在 high-resolution 3D generation 任务上,与使用体素隐空间、多阶段流水线的强基线对比,评估结构保真度与生成成本。
- 量化指标包括 PSNR、覆盖率、Betti error、token 数量、训练内存与推理时间;定性分析关注薄结构、重复组件与长程连接。
关键发现
- 与最强基线相比,SILSA 将 PSNR 提升 8.7%,覆盖率提升 5.96 绝对点,拓扑误差(Betti error)降低 9.2%。
- 同时,token 数量比次紧凑基线减少 70.0%,比稀疏或分层 tokenizer 减少 98% 以上,训练内存降低 40.4%,推理时间缩短 58.5%。
- 定性结果表明,SILSA 能更好地保留薄结构、重复组件和长程连接,避免拓扑断裂。
与基线对比的深度解读
- SILSA 的核心优势在于 滑窗切片隐空间 与 拓扑监督损失 的组合:每个 token 概括局部深度窗口,保持截面连续性,单阶段 rectified flow 避免多阶段流水线带来的表面碎片化。
- 这一设计使得 SILSA 在 token 数大幅缩减的前提下,仍能提升 PSNR 和覆盖率,说明紧凑表示并未牺牲几何细节,反而通过拓扑约束提高了结构正确性。
- 相比之下,纯体素或分层 tokenizer 需要大量局部 token,增加了生成成本和拓扑不一致风险;SILSA 用更少 token 实现更高结构保真度,验证了拓扑感知表示在高分辨率 3D 生成中的实用价值。
行业影响
落地场景
SILSA 的紧凑切片潜在表示与拓扑保持能力适合需要高保真、复杂结构 3D 生成的场景:
- 电商 3D 商品展示 :自动生成家具、鞋服、珠宝等商品的高分辨率 3D 模型,减少传统摄影测量或手工建模成本。例如,平台可对上传的少量照片生成可交互 3D 商品,提升转化率。
- 游戏与影视资产创建 :快速生成具有薄壁、重复组件、长距离连接的复杂资产(如栅栏、链条、血管网络),避免拓扑断裂,缩短美术迭代周期。
商业价值
- 降本 :SILSA 比次紧凑基线少用 70% token,比稀疏/层次 tokenizer 少 98% 以上,训练内存降低 40.4%,推理时间缩短 58.5%。直接减少 GPU 资源消耗和服务成本。
- 提质 :PSNR 提升 8.7%、Coverage 提升 5.96 点、Betti 误差降低 9.2%,减少后处理修复工作,提升可交付资产质量。
- 增效 :单阶段 rectified-flow 生成替代多阶段管道,简化训练和部署,支持更快的迭代和实时生成。
与现有工作流接口
- 模型层 :SILSA 的 Slice VAE 和生成模型可以作为独立模块嵌入现有 3D 生成框架,替换 Voxel VAE 或 Triplane VAE,与 ControlNet、LoRA 等条件控制技术兼容。
- 数据层 :输入为定向表面采样点,输出可通过稀疏体积解码器转换为 mesh 或 point cloud,与 Blender、Unity、Unreal 等 DCC 工具无缝对接。
- 部署层 :提供标准化 API 或 ONNX 模型,集成到云端 3D 生成服务,支持批量和按需生成。
局限
- - **轴对齐切片的几何覆盖局限**:SILSA 沿三个规范轴定义切片,对与轴成较大角度的细薄或管状结构,切片可能无法连续捕捉其截面,导致拓扑不连续。虽然多轴切片缓解了部分问题,但无法完全覆盖任意方向的结构,限制了在复杂拓扑形状(如螺旋或斜向连接)上的表现。未来可能需要可变方向切片或自适应的 Volumetric Anchor Lattice 来增强表示能力。
- - **拓扑监督的计算开销与实现敏感度**:论文引入 persistence diagrams 匹配和 Betti 转换对齐,这类拓扑损失通常计算复杂度较高,尤其对高分辨率体积数据。虽然生成 token 减少带来记忆和推理优势,但训练阶段拓扑损失可能成为瓶颈,且对数据噪声或体素化离散化敏感,需要精细调参才能稳定收敛。论文未充分讨论该损失在大规模数据集上的可扩展性。
- - **输入表示依赖与生成流程的前处理成本**:Slice VAE 编码的是 oriented surface samples,需要额外的表面提取或法向估计步骤,对输入表示有特定要求,限制了直接从点云或隐式表示的应用。此外,单阶段 rectified flow 生成虽比多阶段方法快,但仍可能需要较长的采样链,在实时或交互式生成场景下可能仍有压力。