iADD: 改进扩散策略优化中的对齐与多样性
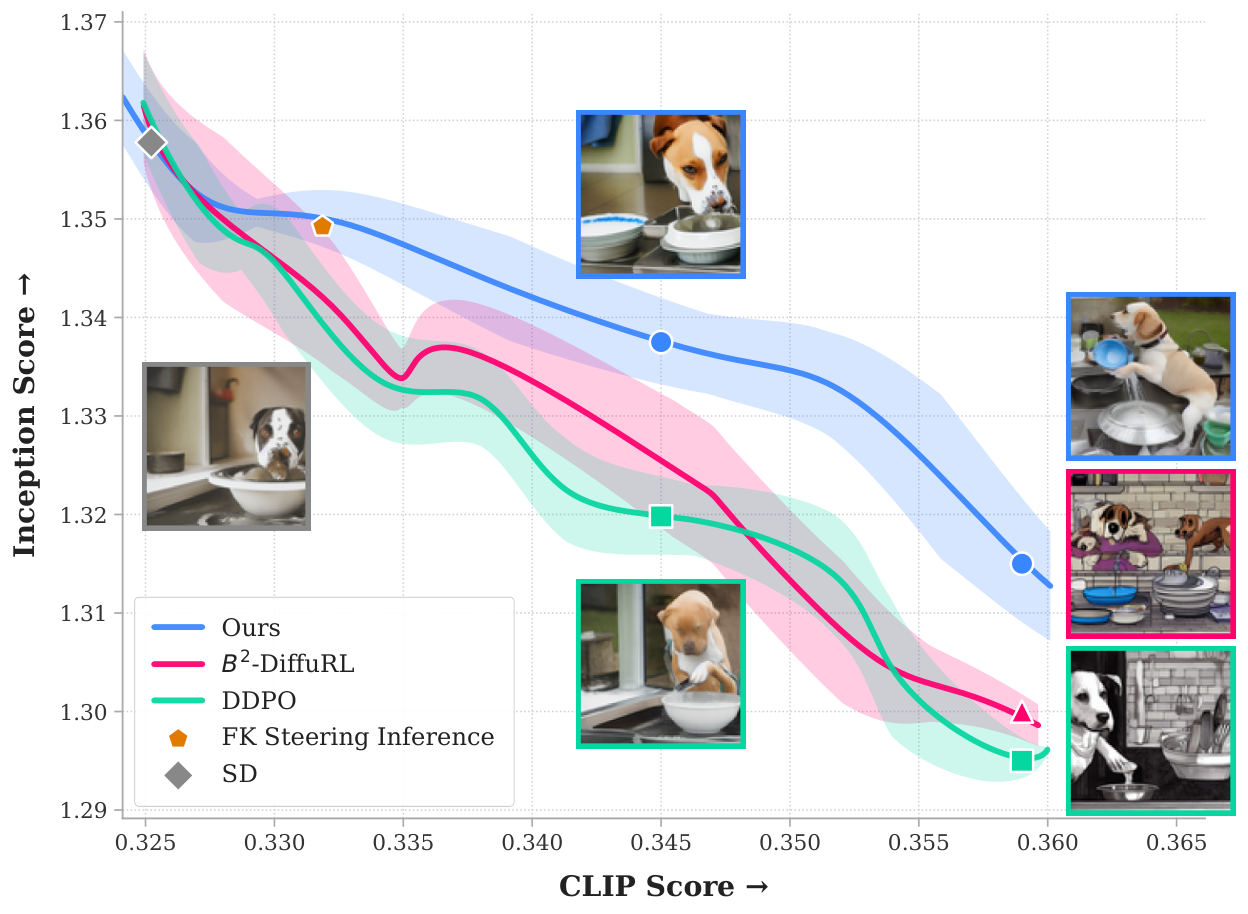
扩散模型的强化学习后训练方法(如 DDPO,Denoising Diffusion Policy Optimization)在奖励函数下优化逆向扩散过程,但现有奖励优化方法往往以牺牲多样性与质量为代价。本文通过细致的理论分析与方法设计,给出了更优的权衡方案。 - 理论上,我们重新审视了现有分析框架,并数学上证明:仅对扩散模型的后段 timestep 进行更新可能损害多样性——这与先前工作的结论相反。 - 方法上,我们提出基于坚实理论基础的增量式 Feynman-Kac 训练(incremental Feynman-Kac training),以取得目前最佳的对齐-多样性权衡。 实验方面,我们在三类不同任务上与相关扩散策略优化方法进行对比,并对各组件做了充分消融,验证了在对齐与多样性两方面均有显著性能提升。
论文精读
TL;DR iADD 通过稀疏增量时间步更新与增量 Feynman-Kac 训练,纠正了 DDPO 类扩散策略优化中牺牲多样性的问题,在保持对齐的同时显著提升多样性,实现最佳对齐-多样性权衡。
问题
问题背景
扩散模型的后训练策略优化(如 Denoising Diffusion Policy Optimization, DDPO)正成为对齐图像生成与人类偏好的核心手段,目标是在保持生成质量的同时最大化奖励函数。
现有方法局限
现有 DDPO 类方法主要通过奖励加权更新反向扩散过程,但往往以牺牲多样性和样本质量为代价。具体来说:
- 优化目标单一,奖励函数存在可被利用的捷径,导致模式坍塌与奖励 hacking;
- 已有工作提出只更新扩散过程后期 timestep 可提升效率,但本文通过理论分析证明仅更新后期 timestep 可能对多样性有害,这一结论与先前假设相反;
- 缺乏严格理论框架刻画 alignment 与 diversity 的权衡,使得调参高度经验化。
为什么这个问题难/重要
扩散模型的多步采样使奖励信号高度稀疏,梯度估计方差大,优化极易偏向高奖励但低多样性的“投机”轨迹。同时,多样性与对齐在分布层面天然冲突,如何在不牺牲一方的前提下改善另一方,是视觉生成模型在工业落地时的关键痛点。文本到图像、3D 场景合成等任务都需要同时满足指令遵循与创意多样性,因此该问题具有显著业界关注度。
行业类比
类似 LLM 强化学习微调中出现的奖励 hacking 与多样性退化问题,扩散策略优化同样需要在奖励对齐与生成多样性之间建立更稳健的折中方案。
核心洞察
- 推翻“仅后期时间步更新可保多样性”的既有结论。该工作通过理论分析证明,对扩散模型仅更新去噪过程后期时间步可能损害生成多样性,与之前某工作的实验观察相反。这一角度独特在于,它将 RL 微调中的时间步选择从经验启发提升为可证明的多样性影响因素,为后续策略设计提供了数学依据,而非仅依赖实验结果。
- 引入增量 Feynman-Kac 路径引导框架。该方法把扩散模型去噪过程视为 Feynman-Kac 路径积分,通过设置中间势能并采用增量训练策略,在优化奖励的同时保持生成多样性。相比 DDPO 等直接优化终端奖励的方法,这一框架在理论上更自然地平衡对齐与多样性,避免了单纯追求高奖励导致的模式坍塌。
- 将稀有事件概率作为多样性关键度量。论文显式建模 rare-event probability 来评估生成样本对长尾区域的覆盖,而非仅依赖 IS/FID 等常见分布距离指标。这一角度独特在于,它揭示了平均指标可能掩盖多样性损失的问题,并通过稀有事件引导训练,使得 RL 微调在追求对齐时仍能保留罕见但有效的生成模式。
方法
方法概述
iADD 的输入是一个预训练的扩散模型(如 DDIM)和一个奖励函数,目标是最大化期望奖励同时保持生成多样性。方法包含三个关键模块:
稀疏增量时间步更新:作者从理论上证明仅更新扩散过程后期时间步会损害多样性,因此提出早期时间步更新和稀疏时间步选择。在训练中只对反向扩散过程的部分时间步(以增量方式从早期向后期扩展)进行策略梯度更新,而非更新所有时间步或仅更新后期。
Feynman-Kac 路径引导:将扩散反向过程视为一个 Feynman-Kac (FK) 模型,在中间时间步引入势函数(potential)来编码奖励信号。通过粒子滤波(particle filtering)估计路径上的加权期望奖励,使得梯度估计更稳定,减少高方差。
稀有事件处理:针对低概率高奖励的样本(稀有事件),方法通过 FK 分支(branching)和粒子重采样来提升对稀有但重要轨迹的采样效率,增强探索。
最终输出一个优化后的扩散策略模型,能在不牺牲多样性的前提下提升奖励对齐。
与 DDPO 等同类方法相比,iADD 的核心差异在于:通过理论指导选择稀疏的早期时间步更新,避免了全时间步或后期更新带来的多样性崩溃,并结合 FK 路径引导 实现更稳定的奖励优化。
实验
实验设计
作者在三个任务上评估 iADD:文本到图像生成、消失点校正、3D 室内场景合成。基线包括 DDPO、近期 guidance 方法和 GRPO 类策略优化。评估指标涵盖对齐度、多样性、罕见事件概率、Inception Score (IS)、碰撞率等,并进行了人类评估。训练使用 LoRA 适配,具体算力未披露。
关键发现
理论分析证明仅对后期时间步更新会损害多样性,与先前工作结论相反。iADD 引入稀疏增量时间步更新和Feynman-Kac 路径引导,在多个任务上同时提升对齐与多样性,达到最佳 trade-off。消融实验证实了增量策略、FK 分支和时间步选择的有效性。对于罕见事件,iADD 能提高罕见样本的生成概率,并改善 3D 场景布局合理性。
基线对比解读
相比 DDPO 等纯奖励优化方法,iADD 在不牺牲多样性的前提下获得更高对齐分数,说明其目标函数设计更平衡。与仅做 guidance 后处理的方法相比,iADD 在训练阶段整合了 FK 势能,避免了过度锐化分布。该方法在保持生成质量和训练稳定性上优于 GRPO 类基线,尤其在高奖励区域的覆盖率更好。
行业影响
落地场景
iADD 适用于需要 强化学习微调扩散模型 同时保持输出多样性的产品。典型场景:
- 电商产品图生成:用奖励函数优化产品图的美观度、构图、光照等属性,同时避免所有生成图风格单一,iADD 可确保不同商品、不同场景下的多样化呈现。
- 自动驾驶仿真数据增强:生成稀有但安全的交通场景(如突然闯入行人、恶劣天气)用于模型训练,iADD 对 稀有事件概率 的优化能提升此类关键数据的产出。
- 内容平台个性化配图:根据用户偏好生成配图,既要贴合文本含义又要避免重复,iADD 的 alignment–diversity trade-off 直接对应业务诉求。
商业价值
- 降低成本:通过更好的对齐减少反复生成和人工筛选,节省 GPU 与人工审核成本;稀疏时间步更新减少了训练步数,训练成本降低。
- 提升体验与转化:多样性提升带来更丰富的创意素材,有利于 A/B 测试和用户留存;在电商中,多样化商品图可提高点击率。
- 增强数据稀缺性价值:iADD 显式处理 rarity,适合生成小概率但高价值事件数据(如金融风控中的异常交易模式、医疗影像中的罕见病灶),这些数据在训练和测试中具有商业意义。
与现有工作流集成
- 即插即用替换 DDPO:iADD 基于 DDPO 框架,只修改更新策略(稀疏时间步、增量 FK),可直接替换现有 RL 微调扩散模型模块。
- 兼容主流训练栈:论文使用 LoRA 进行轻量适配器训练,可加载到 Hugging Face Diffusers 等库,推理时无需额外计算,不影响部署延迟。
- 需要自定义中间势能函数:工程上需要根据任务设计 Feynman-Kac 的中间奖励,但论文提供了通用框架和消融,可参考其实现(GitHub)。
局限
- **计算开销较高**:iADD 引入的 Feynman-Kac 路径引导需要维护粒子滤波器和分支轨迹(如 S9 所述),相比 DDPO 等基线增加了训练时的采样与计算负担。虽然论文在 S15 对比了训练时间,但未给出显存/算力需求的定量分析,在大规模扩散模型(如 SDXL 或视频生成)上可能难以直接扩展,限制了工业场景的实用性。
- **任务覆盖较窄**:实验仅在图像生成、消失点校正和 3D 室内场景合成三个任务上进行,且图像生成使用的模型规模和数据集(如 Prompts 列表)相对有限。对于更复杂的开放域文本到图像生成、高分辨率场景或具有稀疏奖励的任务,方法的鲁棒性和泛化性尚待验证;奖励函数设计对性能影响较大,通用性可能不足。
- **理论假设与实际部署存在差距**:理论分析基于 DDIM 采样和特定噪声调度,但实际加速采样(如 DPM-Solver)或随机采样器下,稀疏增量 timestep 更新和 FK 引导的有效性可能下降。此外,与 GRPO 等最新基线的对比可能未覆盖所有重要变体(如不同 KL 约束),结论的普遍性仍需更多独立复现支持。