SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation
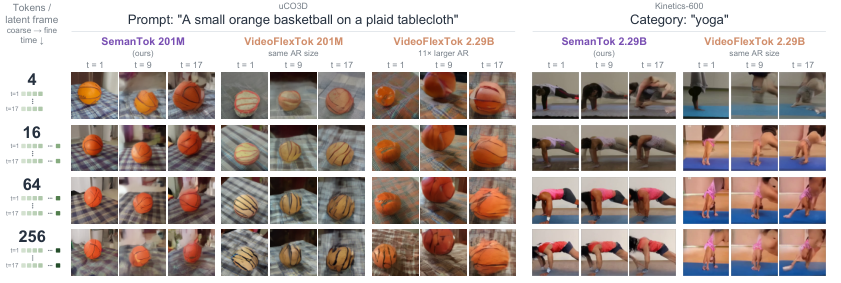
Recent video-based world models pair the scalability of autoregressive (AR) prediction with the visual quality of diffusion models. The choice of scene tokenizer is paramount for the optimal performance of each of these, both in terms of fidelity and semantics. Flexible-length, coarse-to-fine tokenizers yield exactly that: the first coarse tokens carry the clip's global semantics while later tokens further specify details. Existing flexible tokenizers only apply a representation-alignment (REPA) loss on early decoder hidden states, a target the decoder can partly meet from its noised input instead. We introduce SemanTok, a flexible video tokenizer that feeds frozen DINO features into its encoder and adds lightweight heads that reconstruct them from each retained token prefix alone. SemanTok achieves high semantic alignment and video fidelity at every AR model size: a 201M SemanTok AR model matches or beats a VideoFlexTok AR model 3.4times its size, and larger SemanTok AR models further improve fidelity. It keeps semantic alignment on out-of-distribution classes and gives the decoder higher semantic alignment at every noise level, including pure noise. It performs well in both reconstruction and generation, and its short token prefixes are cheaper to predict and give better generation fidelity, with pixel detail deferred to later tokens.
论文精读
TL;DR SemanTok 将冻结 DINO 特征注入视频 tokenizer 编码器,并从前缀单独重建语义,使短 token 前缀携带全局语义,让小 AR 模型生成质量匹敌 3.4 倍大的 VideoFlexTok。
问题
问题背景
视频生成领域正从纯扩散模型走向 自回归(AR)与扩散结合的混合范式,以兼顾 AR 的可扩展性和扩散模型的视觉质量。在此类视频世界模型中,场景 tokenizer 的设计 直接决定了后续预测的语义保真度与生成效率。
现有方法局限
当前灵活长度的 coarse-to-fine tokenizer(如 VideoFlexTok)仅在解码器早期隐藏状态上施加 REPA 对齐损失。其问题在于:解码器可以从带噪输入中部分满足对齐目标,而非完全依赖 token 前缀中的语义信息。这一设计导致:
- 语义对齐不彻底,尤其在低噪声或纯噪声条件下,解码器无法从 token 前缀独立重建高层语义特征。
- 短 token 前缀的语义可预测性不足,迫使 AR 模型预测更多 token 才能达到可接受的语义保真度,增加计算开销。
- 对分布外类别的语义保持能力弱,因为对齐信号被噪声污染,模型无法稳定编码全局语义。
为什么这个问题难/重要
视频 clip 复杂度差异巨大:静态镜头实体少、运动弱,而追逐场景包含视角变化与细节密集。要让单一 tokenizer 在“粗 token 承载全局语义、细 token 补充像素级细节”的架构下保持稳定,必须解决一个核心矛盾:解码器不能从噪声输入中“作弊”获取语义,而应被迫依赖 token 前缀。这要求对齐目标完全脱离输入噪声路径,仅由 token 前缀重构。业界关注点在于:若能获得高可预测性的语义 token,AR 模型可用更小规模、更短 token 预算达到同等生成质量,直接降低训练与推理成本。
行业类比
类似 ViT 中的语义监督预训练 对下游任务迁移的提升——如果 tokenizer 自身已经内化了与任务无关的语义表征,下游生成模型就无需额外编码这部分信息,从而把容量留给时序与细节建模。
核心洞察
- SemanTok 的核心是将语义信息显式编码进 token 前缀,而非依赖 decoder 从噪声输入中隐式提取,从而解决了现有 flexible tokenizer 中语义表征被噪声稀释的问题。现有方法(如 VideoFlexTok)仅在早期 decoder 隐藏状态上施加 REPA loss,但 decoder 可以从其带噪输入部分满足该目标,导致语义未必由 token 承载。SemanTok 将 frozen DINO 特征馈入 encoder,并用轻量 head 从每个保留 token 前缀独立重建这些特征,强制语义信息存储在短前缀中。这使得 201M 参数的 AR 模型在生成保真度上匹配或超越 3.4 倍大的 VideoFlexTok AR 模型,同时保持 OOD 类别和纯噪声条件下的高语义对齐,大幅降低预测成本。
- SemanTok 解耦了语义与像素细节,使短 token 前缀成为更便宜、更稳健的预测目标,为 AR 世界模型提供了高效且可扩展的表示基础。传统 tokenizer 将语义与细节混合在长序列中,AR 模型必须处理完整序列才能同时获得两者。SemanTok 通过让每个 token 前缀单独重建 DINO 特征,确保最前面的粗粒度 token 已携带全局语义,后续 token 只追加像素细节。因此,当以短 token 前缀作为生成目标时,AR 模型训练和推理成本更低,且由于语义信息前置,生成保真度反而更高。作者在多个 AR 规模下验证,SemanTok 在相同预算下均优于 VideoFlexTok,且随着 AR 模型增大,保真度进一步提升。
方法
输入与编码
SemanTok 接收视频 clip 帧序列,首先使用 冻结的 DINO 特征提取器 计算逐帧语义嵌入。随后,编码器将原始视频与这些 DINO 特征结合,生成 flexible-length token 序列:前几个 coarse tokens 编码全局语义,后续 fine tokens 逐步补充细节。
关键模块与训练目标
- 冻结 DINO 特征注入:避免在线表征漂移,提供稳定的语义监督信号。
- 前缀语义重构头:在解码器的每个保留 token 前缀(如仅前 1、2、4 个 token)后附加轻量 head,独立重构 DINO 特征。该 head 只接收对应前缀的 token 表示,强制粗粒度 token 直接承载语义信息。
- 损失函数:除视频重建损失外,加入 前缀语义对齐损失(计算重构 DINO 特征与目标的距离),取代 VideoFlexTok 仅施加在早期 decoder 隐藏状态上的 REPA loss。
输出即 token 序列,供 AR 模型逐步预测。
工程启示与差异
SemanTok 的语义约束绑定于 token 本身,而非依赖 decoder 从噪声输入中恢复语义,因此 短 token 前缀更可预测,AR 生成时更高效。与 VideoFlexTok 相比,它无需在 decoder 内部添加额外 REPA 分支,而是在 token 输出端直接对齐语义,训练更简洁。
实验
实验设计
论文在 视频 tokenizer 和 AR 生成 两个层面评估。Tokenizer 训练使用 Kinetics-600 与 uCO3D 数据集(正文碎片提及),评估重构质量、DINO 语义对齐、OOD 类别准确率及不同 token 预算下的生成保真度。AR 模型对比 VideoFlexTok 与 SemanTok,覆盖多种模型规模,重点关注短 token 前缀预测效率。
- 重构评估:测试不同噪声级别(含纯噪声)下解码器的语义对齐。
- 生成评估:比较不同 token 预算(early tokens)下的生成指标。
- 扩展性评估:AR 模型参数从 201M 到更大规模。
关键发现
SemanTok 通过 冻结 DINO 特征 输入 encoder,并利用轻量 heads 从每个保留 token 前缀单独重构,使得早期 token 携带全局语义。这解决了现有灵活 tokenizer 中 REPA 损失 仅作用于早期 decoder 隐状态、且解码器可从噪声输入部分满足该目标的缺陷。
- 201M 的 SemanTok AR 模型即可匹配或超越 3.4 倍 大小的 VideoFlexTok AR 模型。
- 更大的 SemanTok AR 模型保真度进一步提升,扩展性良好。
- 在 OOD 类别上保持语义对齐,在纯噪声下解码器依然从 token 前缀获取语义,表明语义信息确实编码于 token 而非噪声。
与基线对比
与 VideoFlexTok 相比,SemanTok 的核心差异在于语义监督信号直接施加于 token 前缀本身,而不是解码器隐状态。这使得 AR 模型只需预测少量早期 token 即可生成高保真视频,显著降低推理计算成本。短 token 前缀成本更低且生成质量更好,像素细节由后续 token 补充,实现了从粗到细的高效生成。这一设计为视频世界模型提供了更可预测的离散表示,对实际工程中部署大规模 AR 视频生成具有直接参考价值。
行业影响
落地场景
SemanTok 可作为高效视频 tokenizer 嵌入各类视频生成与理解产品中。典型场景包括:
- 短视频平台的 AI 创作工具:用户输入文本或图像,快速生成带语义一致性的视频草稿,支持渐进式细化。
- 电商内容生成:根据商品图片自动生成多角度展示视频,降低商详页视频制作成本。
- 自动驾驶仿真:利用其世界模型能力生成多样化驾驶场景,用于感知模型训练与验证。
- 影视预演:低成本生成动态分镜,加速前期创意迭代。
商业价值
核心价值在降本与体验提升两条线:
- 降本:SemanTok 的灵活长度 token 前缀让 AR 模型只需预测短前缀即可获得高保真生成,同等质量下 AR 模型参数可减少 3.4 倍,直接降低训练与推理算力成本。
- 体验提升:早期 token 已携带全局语义,用户可先获得低分辨率、语义正确的快速预览,再逐步补全细节,提升交互响应速度与生成质量。
- 增收:对内容平台,更低的生成成本可支撑更多 UGC 视频创作场景,提高用户留存与付费转化。
与现有产品/工作流的接口
SemanTok 可作为即插即用 tokenizer 替换现有 AR 视频生成模型中的 tokenizer(如 VideoFlexTok)。其工作流集成点主要在:
- 模型训练阶段:用 SemanTok 编码视频得到多尺度 token 序列,替代传统 VAE/RVQ tokenizer,无需改动 AR 模型架构。
- 推理阶段:支持渐进式解码,先预测粗粒度 token 快速出图,再根据算力预算决定是否补全细节,适配从云端到边缘的多种部署环境。
- 与扩散模型结合:保留的 DINO 语义特征可同时用于指导扩散解码器,强化视频生成中的物体身份与场景一致性。
局限
- **依赖 DINO 语义空间**:SemanTok 使用 frozen DINO 特征作为语义监督信号,其有效性受限于 DINO 预训练数据分布和语义粒度。对于 DINO 表征能力较弱的领域(如高度风格化视频、非自然场景或某些专业内容),语义对齐可能退化,导致 tokenizer 无法捕获正确的全局语义,进而影响下游 AR 生成质量。论文仅在 OOD 类别上验证了语义对齐保持,但未覆盖更广泛的分布偏移或域外数据集,实际部署时需评估 DINO 特征对目标域的适用性。
- **额外计算与存储开销**:与 VideoFlexTok 仅对解码器早期隐藏状态施加 REPA 损失相比,SemanTok 要求从每个保留 token 前缀单独重建 DINO 特征,这增加了 tokenizer 的参数量和训练/推理计算成本。轻量头虽设计为 lightweight,但在多尺度 token 前缀上的并行解码仍可能引入额外延迟。此外,训练前需预先提取并存储所有训练视频的 DINO 特征,对存储和 I/O 造成压力,可能影响超大规模训练的可行性和成本。
- **灵活 token 预算选择敏感**:论文强调短 token 前缀更便宜且生成保真度更好,但未系统讨论不同 token 预算在重建质量与生成效率之间的 trade-off 曲线。实际应用时,如何根据视频复杂度动态调整 token 长度(例如是否引入自适应截断机制)尚不明确。实验评估可能局限于固定预算设置,缺乏对预算选择策略的深入分析,使得在资源受限场景下部署时仍需额外调优和验证。