超越两次循环:Looped Mixture-of-Experts 的可扩展配方
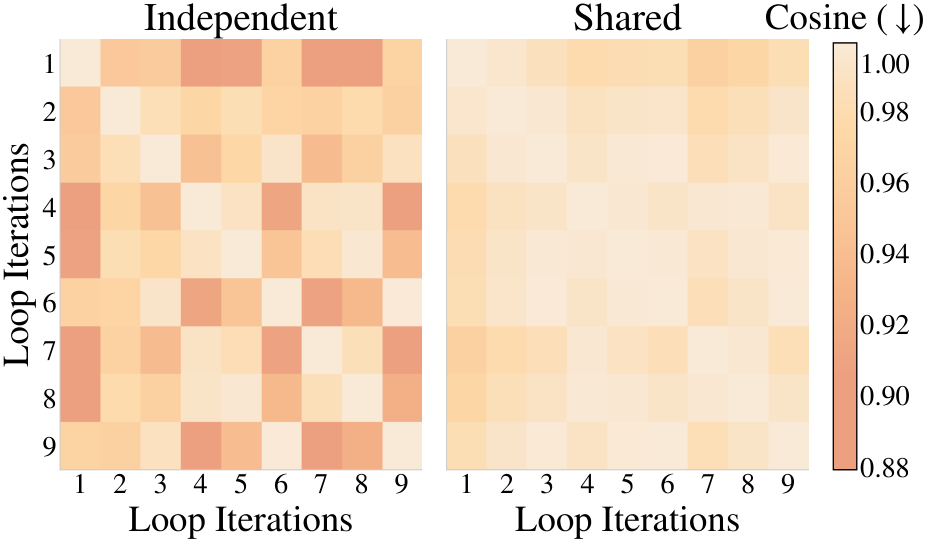
Looped Transformers 通过重复应用共享的 Transformer 块,在不增加参数量的前提下提升有效深度,为 LLM 引入了新的 scaling 轴。但在 FLOPs 匹配的比较下,循环对大型 MoE LLM 的收益仍不明确:额外迭代带来的增益会迅速衰减甚至转为退化,因此多花的算力难以换来实质提升,此前工作通常止步于两次循环。作者指出扩展到循环 MoE 的两大障碍: 1. 循环会继承并放大深度诅咒,残差更新逐次累积导致隐状态方差增长,深层递归不稳定、表示发生漂移; 2. 循环 MoE 存在专家选择坍缩,router 在多轮循环中反复选中同一批专家,额外迭代只增加计算量,却不增加计算多样性。 据此作者提出 LOOM,其单一原则是:每次循环都应贡献新的计算,同时保持循环状态稳定。LOOM 通过缩放残差更新以约束方差增长,并在每轮循环重新注入输入 embedding 来稳定递归;同时借助逐轮 router 激活不同专家,以及将早期输出向前传递的 Looping Residual 来提升多样性。 在 100M-1.7B 模型上的实验显示,LOOM 可稳定扩展到 9-12 次循环。在近等 FLOPs 设置下,700M 模型在 5 次循环时表现最佳:困惑度从 18.36 降至 16.54,平均零样本准确率从 38.84% 提升到 39.53%。在不做 FLOPs 匹配时,1.7B 模型在 60B tokens 上训练并于 9 次循环达到峰值:困惑度从 9.62 降至 7.77,平均零样本准确率从 42.4% 提升到 47.7%。代码见 https://github.com/hed-ucas/LOOM。
论文精读
TL;DR 针对 Looped MoE 循环多次收益递减的问题,LOOM 通过稳定残差方差、重注入输入、每循环独立路由,让模型稳定循环至 9 次以上,iso-FLOP 下显著降低困惑度并提升零样本准确率。
问题
问题背景
循环 Transformer (Looped Transformers) 将循环深度引入大语言模型 (LLM) 的缩放维度:通过重复应用共享 Transformer block,在不增加参数量的前提下提升有效深度。与 Mixture-of-Experts (MoE) 结合是当前参数高效缩放的重要方向。
现有方法局限
在 FLOPs 匹配的比较下,循环 MoE 的收益并不明确。主要问题包括:
- 增益快速衰减:额外循环带来的性能提升随迭代次数增加而迅速减小,甚至出现负增益,导致实际训练中通常只做两次循环。
- 深度诅咒被放大:循环继承并放大深度诅咒——隐藏状态方差随迭代增长,残差更新累加使深层循环不稳定,表征漂移。
- 专家选择崩溃:路由器在多个循环中反复选择相同专家,额外迭代只增加计算量而不增加计算多样性。
为什么这个问题难/重要
在 LLM 缩放效率备受关注的背景下,如何让循环深度在 MoE 架构上稳定扩展,是提高参数效率与推理 FLOPs 利用率的关键。同时解决状态稳定性和计算多样性,涉及残差连接、路由机制与训练策略的协同设计,工程与理论挑战并存。若无法克服专家选择崩溃,重复前向传递只会浪费算力,无法转化为模型能力提升。
行业类比
类似推理时的迭代优化(如 chain-of-thought 或 self-refine):重复前向传递必须产生新的有效计算,否则只是消耗算力而无法提升输出质量——正如代码生成中多次采样但模型重复输出相同片段。
核心洞察
- Looped MoE 的核心瓶颈不只是递归深度不稳定,而是 **expert selection collapse**:路由器在每一轮重复选择相同专家,导致额外循环只增加 FLOPs 而不增加计算多样性。以往工作默认两次循环,未系统区分深度稳定性与路由冗余。LOOM 通过 per-loop routers 和 Looping Residual 迫使每轮循环产生新计算,将循环扩量从“加深网络”重新定义为“增加不同专家贡献”,为大规模 MoE 的循环利用提供了新视角。
- 隐藏状态方差随循环迭代累积是深层递归失效的隐性原因;LOOM 用 **residual scaling** 约束残差更新幅度,并在每轮重新注入输入 embedding,把方差增长控制在有界范围,从而支持 9–12 轮稳定循环。相比已有 looped Transformer 仅依赖 LayerNorm/RMSNorm,LOOM 给出了明确的方差控制机制,使循环 MoE 在 FLOPs 匹配乃至非匹配场景下都能持续获益。
方法
输入与循环框架
LOOM 以 token 序列为输入,经过嵌入层得到初始隐藏状态,然后进入多个共享的 MoE Transformer block 迭代(循环)。每个循环内,隐藏状态先经过注意力与 MoE 前馈,再与残差连接结合。
关键模块设计
针对诊断出的两大障碍,LOOM 提出两个核心改进:
稳定循环状态:
- 残差缩放(residual scaling):对每层的残差输出乘以一个小于 1 的缩放因子,抑制隐藏状态方差随循环次数线性增长,防止表示漂移。
- 嵌入重注入(embedding re-injection):在每个循环开始时,将原始输入嵌入重新加到当前状态上,提供稳定的锚点,避免深层循环遗忘输入信息。
多样化循环计算:
- 每循环独立路由器(loop-specific routers):不同于传统 MoE 在所有循环共享同一个路由器,LOOM 为每个循环设置独立路由器参数,使不同循环选择不同的专家子集,增加计算多样性。
- Looping Residual:将前一个循环的输出作为额外残差传递到当前循环,使后续循环能够利用早期循环的计算结果,而不是完全从头计算。
训练技巧:使用分段反向传播(segmented backpropagation)来降低长循环的内存开销,将梯度回传限制在一定数量的循环内。
输出
经过 L 次循环后,最终隐藏状态通过输出层产生 logits,用于自回归语言建模或下游任务评估。论文报告 L 可从 2 扩展至 9–12。
与同类方法差异:此前循环 Transformer 通常只循环两次且共享路由器,LOOM 通过显式控制方差和路由差异性,使循环深度可作为有效扩展轴,而非仅仅复制相同计算。
实验
实验设计
- 模型规模:100M–1.7B 参数 MoE LLM,统一超参。
- 协议:对比 near-iso-FLOP(固定总 FLOPs,调节循环次数)与 non-iso-FLOP(允许 FLOPs 随循环增加)。
- 指标:困惑度(perplexity)+ 零样本常识推理平均准确率(zero-shot accuracy)。
- 消融:移除残差缩放、嵌入重注入、逐循环路由、循环残差等组件,观察性能变化;并对比分段反向传播。
关键发现
- LOOM 稳定将循环深度从以往 2 次 扩展到 9–12 次。
- Near-iso-FLOP:700M 模型在 5 loops 时最佳,困惑度从 18.36 → 16.54,平均零样本准确率 38.84% → 39.53%。
- Non-iso-FLOP:1.7B 模型训练 60B tokens,在 9 loops 达到峰值,困惑度 9.62 → 7.77,平均零样本准确率 42.4% → 47.7%(+5.3%)。
- 消融证实各组件对稳定循环和专家多样性均有贡献。
与基线对比解读
传统循环 MoE 受限于 深度诅咒(残差累积引起方差爆炸)和 专家选择崩溃(循环间路由重复),增益在 2 循环后迅速衰减甚至反转,导致额外 FLOPs 无效。LOOM 通过 残差缩放 + 输入嵌入重注入 控制方差,通过 逐循环路由器 + 循环残差 增加计算多样性,使每一轮循环都能提供新信息。在 iso-FLOP 协议下,循环深度还可作为替代宽度的效率维度;而在允许更多 FLOPs 时,更多循环能持续提升性能,证明了循环深度作为独立 scaling 轴的潜力。
行业影响
落地场景
LOOM 为循环 MoE 模型提供了可扩展的训练方法,适合需要深度推理能力且计算预算受限的场景。典型用例包括:
- 电商智能客服:基于循环 MoE 的对话模型可在相同 FLOPs 下提升零样本准确率(如 700M 模型从 38.84% 到 39.53%),支持更准确的意图理解与自动回复。
- 内容平台实时摘要/生成:在移动端或边缘节点部署时,利用参数共享的循环块减少内存占用,同时保持接近更大模型的表现。
商业价值
主要落在 降本 与 体验提升 两条线:
- 降本:循环结构避免为深度模型额外存储大量参数,降低推理显存与训练成本;iso-FLOP 下性能提升意味着相同算力可产出更优模型。
- 体验提升:非 iso-FLOP 扩展中,1.7B 模型循环 9 次后平均零样本精度从 42.4% 提升至 47.7%,直接改善面向用户的产品质量。
与现有产品/工作流接口
LOOM 可以平滑集成到现有 Transformer 训练/推理栈:
- 核心改动仅为残差缩放、输入嵌入重注入、逐循环路由器 与 Looping Residual,不改变整体架构假设。
- 训练采用分段反向传播,便于在资源有限的设备上优化长循环序列。
- 开源代码 LOOM 可直接作为参考实现,适配现有 MoE 训练框架(如 DeepSpeed、FairScale)与推理引擎(如 vLLM)。
局限
- **实验规模有限**:论文仅在 100M–1.7B 参数量、最多 60B tokens 上验证,未扩展到更大模型(>7B)或更长训练。Looped MoE 在更大规模下可能出现收益衰减或需要重新调节 `residual scaling` / `per-loop routers` 等超参数,因此 LOOM 的结论是否适用于生产级 LLM 仍存疑。
- **组件耦合与调优成本高**:LOOM 同时引入残差缩放、输入嵌入重注入、逐循环路由、Looping Residual 和分段反向传播共 5 个机制。消融实验虽证明各组件有效,但组件间可能存在非线性耦合,实际工程中需要额外搜索超参数;分段反向传播也改变了梯度流,可能对最终收敛质量有负面影响。
- **对比基线不足**:仅与标准 looped MoE 和非循环 baseline 比较,未系统对比已有的深度稳定化技术(如 DeepNorm、NormFormer)或 MoE 多样性增强方法(如 routing entropy regularization)。因此 LOOM 的改进幅度可能部分来自多组件组合,而非单一核心创新,且专家选择多样性的评估指标较单一。