Science or Slop?: 面向 AI 生成论文中科学 Slop 的基准测试与缓解
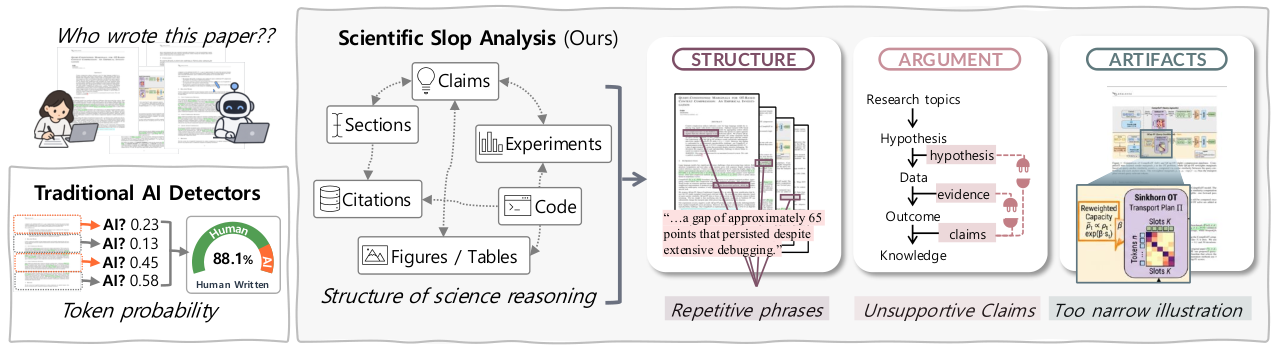
AI 生成内容(常被称为 AI slop )在各类场景中日益普遍,学术界尤其如此。但 AI 生成科学论文中的 slop 具有更复杂的模式,现有基于 token 的 AI 检测器难以直接识别:论文的每个部分看起来都合理,而连接这些部分的科学推理却已经断裂,从而误导读者对工作的判断。 我们从 Structure、Argument、Artifacts 三个层面出发,以六项指标对上述失败进行基准测试,构建了 SciSlopBench。该基准包含 390 篇 AI 生成论文,以计算机科学为主,同时覆盖生命、社会与自然科学,每篇均配有一篇在研究问题与贡献类型上匹配的人类撰写论文。 实验显示,这些指标能以 85.9% 的准确率识别出每对中的 AI 论文,而 Binoculars 仅为 68.7%。更高的科学 slop 伴随更低的 ICLR 评分,并在 2017 至 2025 年间每一年都以高于随机的水平区分被拒与接收论文。然而,缓解这些模式并非直接优化指标那样简单:我们提出 SciSlopHarness 这一 harness 级框架,引导固定的 LLM 只在实验记录支持的情况下修改 slop。 结果表明,标准修订会残留 slop,直接使用 slop 感知提示会引发 reward hacking,而 SciSlopHarness 在无需人类参考目标的前提下,将残余的 AI 与人类差距较最强修订基线缩小 63%。总体而言,AI 生成科学论文在其全局推理中留下了根本性痕迹,负责任的缓解需要严格的证据支撑,而非仅仅打磨文字。
论文精读
TL;DR 论文提出 SciSlopBench 基准,用六项结构/论证/工件指标识别 AI 生成论文中的“科学 slop”,检测准确率 85.9%;并设计 SciSlopHarness 在证据约束下定向修订,将 AI-人类差距再缩小 63%。
问题
问题背景
AI 生成内容正在快速涌入学术写作,通用术语称为 AI slop。科研论文中的 slop 模式比普通文本更隐蔽:每个局部段落看似合理,但连接各部分的科学推理却可能断裂,进而误导读者对工作的整体判断。
现有方法局限
当前主流的 token 级检测器(如 Binoculars)主要依据词元分布异常来判定 AI 文本,但在学术论文场景下准确率有限——论文中单个句子往往语法正确、术语规范,缺乏明显的 token 分布破绽。更关键的是,这类方法无法建模跨段落、跨章节的推理一致性:例如方法部分与实验结果之间的因果链条是否成立、图表与正文的论证关系是否自洽。因此,它们对“科学逻辑断裂”型 slop 几乎失效,只能捕捉局部表层痕迹。
为什么这个问题难/重要
AI 生成论文的每一部分单独阅读都很像人写的,问题出在全局推理结构上,这种断裂很难用单一指标量化。它会影响论文评审、文献筛选和科研诚信,尤其在大量投稿涌入会议和期刊的背景下,人工评审无法逐篇深挖逻辑漏洞。业界亟需一种针对科学推理本身的检测与缓解手段,而非停留在文字流畅度层面。
行业类比
这与 代码生成 中的“能跑但逻辑错误”现象高度相似:仅靠语法检查无法发现业务逻辑缺陷,必须结合运行时行为或语义约束才能定位问题;学术论文同样需要从证据链而非字面表达出发做评估。
核心洞察
- AI 生成科学论文的痕迹不在于 token 级流畅度,而在于跨章节的推理断裂,即 scientific slop。同类检测器如 Binoculars 仅捕捉局部 token 分布异常,在 SciSlopBench 上准确率仅 68.7%。该工作从 Structure、Argument、Artifacts 三个维度定义六项度量(macro redundancy、cross-section references、argument graph、citation isolation、figure exposition、evidence gap),将全局科学推理显式化,识别 AI 论文准确率达 85.9%。工程启示:对学术内容审查应超越 perplexity 层面,引入跨段落论证一致性评估。
- 直接优化 scientific slop 度量会导致 reward hacking,必须通过实验记录约束的局部修订来消除痕迹。通用修订残留 slop,slop-aware prompting 则过度修正或仅刷高分数。SciSlopHarness 在 harness 层面让固定 LLM 仅依据 experiment records 能支持的改动进行修订,使 AI-human gap 相比最强修订基线降低 63%。差异点在于把证据可验证性作为修订边界,而非单纯提升文本质量,为生成式 AI 在学术写作中的负责任应用提供了可落地的校验机制。
方法
输入与基准构建
输入为 SciSlopBench 中的 390 篇 AI 生成论文,每篇按研究问题和贡献类型与人类论文配对。方法首先定义六个 slop 度量,跨 Structure、Argument、Artifacts 三类:宏观冗余、跨章节引用、论证图、引用孤立、图表阐述、证据缺口;各度量输出 0-1 分数,聚合为 aggregate score。
科学 slop 度量与检测
这些度量不依赖 token 级特征,而是捕捉论文全局推理断裂,例如论点图不连通或引用与正文脱节。在 SciSlopBench 上,该聚合分数以 85.9% 准确率识别 AI 论文,远超 Binoculars 的 68.7%;同时与 ICLR 评分负相关,并能区分被拒与录用论文。
SciSlopHarness 的修订流程
直接优化 slop 分数会导致奖励黑客,因此提出 SciSlopHarness。给定固定 LLM 和论文的实验记录,采用两阶段:Localized Revision 定位高 slop 段落并生成修改提议;Reviewing Proposed Revisions 将提议与实验记录核对,仅采纳有证据支撑的修改。随后按“测量-保留-停止”迭代,防止过度修改。输出为修订论文,使 AI-human 差距较最强修订基线降低 63%,且无需人类参考目标。
与同类方法的差异
与通用文本改写或 slop-aware 提示不同,SciSlopHarness 强制每次修改必须由实验记录提供严格证据,避免表面润色和分数操控。
实验
实验设计
SciSlopBench 包含 390 对 AI 生成 / 人类论文,按研究问题与贡献类型配对,覆盖计算机科学及生命、社会、自然科学。六类 slop 度量横跨 Structure / Argument / Artifacts,用于与 token 级检测器 Binoculars 对比;同时用 ICLR 2017–2025 投稿数据验证 slop 与评审结果的相关性。SciSlopHarness 基于实验记录定位并定向修订 slop,对比 general revision、slop-aware revision 等基线。
关键发现
六度量在成对判别中达 85.9% 准确率,显著超过 Binoculars 的 68.7%(+17.2pp)。科学 slop 与 ICLR 评分负相关,并能以高于随机水平区分接受 / 拒稿,且每年稳定。SciSlopHarness 比最强修订基线再降低 63% 的 AI–human gap,且无需人工参考目标。
基线对比解读
通用修订只改善局部文本,残留全局推理 slop;slop-aware 直接优化度量会触发 reward hacking。SciSlopHarness 通过实验记录约束修订范围,在无人类参考下更接近人类写作的全局一致性。工程启示:学术 AI 检测需从 token 概率转向全局论证结构;缓解 slop 需要证据驱动的局部修改,而非全文润色。
行业影响
落地场景
- 学术出版与预印本平台:自动筛选 AI 生成论文中的科学 slop,辅助编辑初审,减少低质稿件流入审稿环节。例如 arXiv 可在提交时运行检测,给作者即时反馈。
- 企业研发知识库:对内部技术报告、实验记录自动审查,防止 LLM 生成的“看似合理但逻辑断裂”内容污染知识资产。
商业价值
- 降本:自动检测与针对性修订可降低人工审稿 / 技术审核成本。论文中
SciSlopBench检测准确率 85.9%,高于 Binoculars 的 68.7%,能有效过滤多数 slop。 - 体验提升:
SciSlopHarness在无人类参考下将 AI-human 差距减少 63%,可作为写作助手增强功能,帮助作者主动降低 slop 而非被动拒稿。 - 信任溢价:出版平台或企业可提供 slop 评分认证,提升内容可信度。
跟现有产品/工作流的接口
- 将
SciSlopBench六项指标封装为 REST API,嵌入投稿系统、文档管理系统或 CI 流水线。 - 在 LLM 输出后增加一道
SciSlopHarness修订层,要求模型基于实验记录定位并修改,避免直接优化分数导致奖励攻击(reward hacking)。 - 与现有 AI 检测器(如 Binoculars)并行,作为 token 级检测的补充,聚焦全局推理一致性。
具体落地 use case
- 学术出版商(如 Elsevier、Springer):在 Editorial Manager 中集成检测模块,投稿后自动计算 slop 分数,超过阈值触发编辑预警,并附上可操作性修订建议。
- 企业内部 AI 写作平台(如 Notion AI、Grammarly):增加“科学 slop 检查”功能,当用户生成技术文档或研究报告时,实时标记论据断裂、引用孤立等问题,并引导用户补充证据后重写相关段落。
局限
- - **领域覆盖偏斜**:`SciSlopBench` 的 390 篇论文以计算机科学为主,虽然声称覆盖生命科学、社会科学与自然科学,但各学科样本量不均衡,且可能集中于特定会议/预印本来源。不同学科的论证惯例、引用模式、图表规范差异很大,当前六个度量(结构、论证、工件)跨学科泛化性未经验证。对工程化检测系统而言,直接套用这套指标到人文或理论学科容易产生大量假阳性,需要额外领域适配层或重新标注数据。
- - **依赖实验记录的修订机制**:`SciSlopHarness` 的核心前提是能获取结构化的 experiment records 来验证每一处修改。对于纯理论、数学证明、综述类论文或未公开实验流程的工作,该框架难以应用。实际部署时,自动抽取实验记录并对齐论文段落本身是一个非平凡的自然语言理解任务,错误的对齐会再次引入 slop。与 token 级检测器相比,它提供可解释的局部修订,但计算成本和工程复杂度显著更高。
- - **评估代理指标的局限**:论文以“剩余 AI–human gap”和 ICLR 评分相关性作为主要证据,但未直接验证修订后论文在同行评审、读者理解或下游引用中的真实影响。基准构建中 AI 论文与人类论文的配对基于研究问题与贡献类型,可能无法覆盖最新前沿模型(如多模态、推理增强)生成的高质量论文样式。因此,当前的度量可能只反映特定时期、特定生成流水线的特征,需要持续追踪生成技术演进。