JevSpawn: 通过组合动作空间实现自适应智能体推理
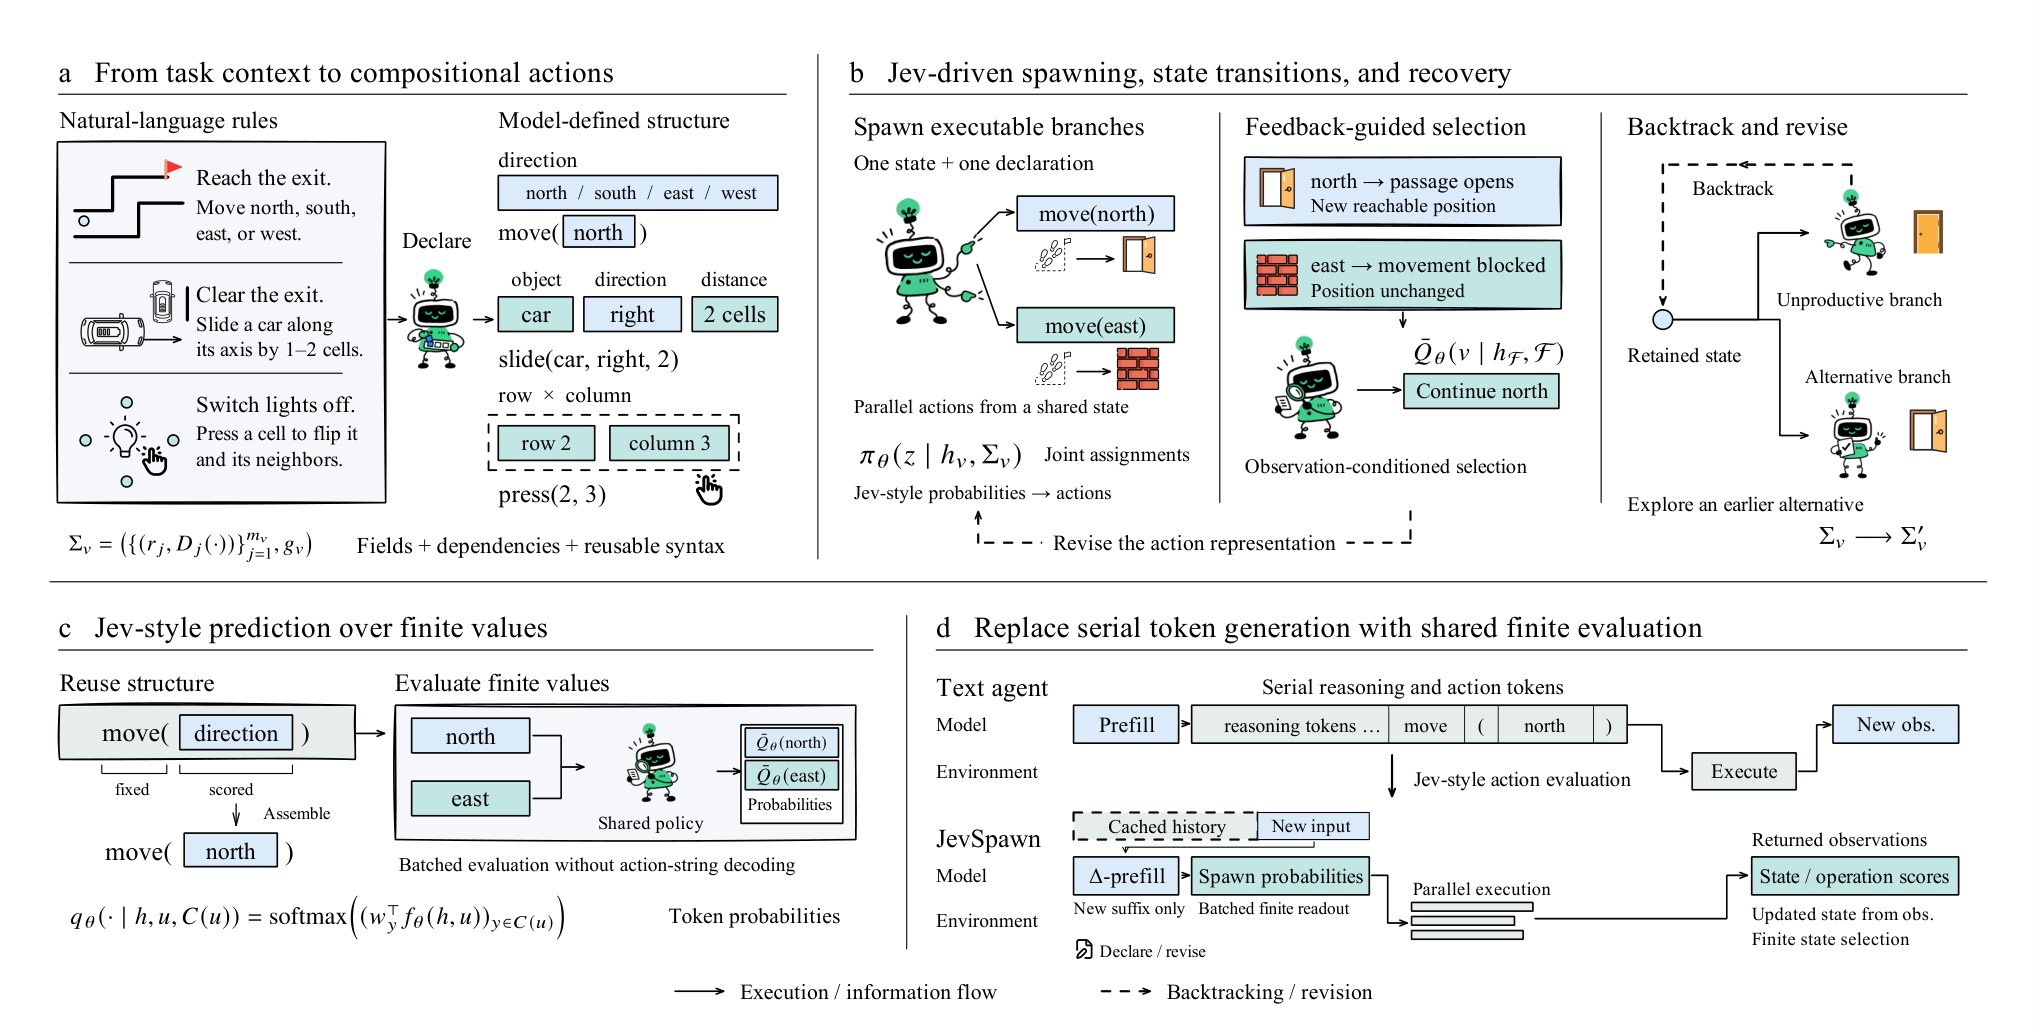
LLM 智能体逐 token 生成中间推理与动作,导致长程交互缓慢且计算开销高昂。Jev-style 模型虽能在有限域上提供快速概率预测,但要求预先指定该有限域,这限制了自主任务求解——可用动作需从自然语言指令中推导,并通过交互不断调整。 为此,我们提出 JevSpawn,一种将自然语言任务规范与有限概率探索相连接的分层组合策略。其核心机制包括: - 并行动作生成,配合反馈驱动的分支选择; - 表示修订,以及从保留备选方案中恢复; - 共享动作结构与模型前缀,减少重复生成和上下文计算,且无需额外训练。 我们在八个基准任务上,将 JevSpawn 与七种智能体基线及一个 TypeSafe Jev 变体进行对比评估。结果表明,JevSpawn 在结构化智能体推理方面表现优异,任务性能提升且导航速度更快。
论文精读
TL;DR JevSpawn 将自然语言指令映射到可并行探索的组合动作空间,通过反馈驱动分支选择与状态恢复,在不增加训练的前提下让 LLM agent 在八个基准任务上比七个基线更快达成目标。
问题
问题背景
LLM 驱动的 agent 在复杂任务解决中成为主流范式,其核心挑战是在有限推理预算下平衡多步交互、动作探索与执行效率。
现有方法局限
传统 LLM agents 逐 token 生成推理和动作,导致长时交互延迟高、上下文持续膨胀;虽然 Jev-style models 能对有限动作空间提供快速概率预测,但要求动作字段预先显式定义。这带来两个关键限制:
- 无法根据自然语言指令动态推导可用动作;
- 无法在交互过程中扩展或修订动作空间以响应环境反馈。
结果,要么放弃速度换取灵活性,要么牺牲灵活性换取速度,难以满足自主任务求解需求。
为什么这个问题难/重要
该问题的难点在于动作空间的组合性与动态性:自然语言任务规范隐含地定义了合法动作集合,且该集合会随交互状态变化。同时,计算预算约束下的并行探索、分支剪枝与上下文复用需要联合优化。业界对高效 agent 推理的关注度持续提升,因为现实部署中每次额外推理调用都意味着成本和延迟的增加。
行业类比
类似 SQL 查询优化器 根据查询语句动态生成执行计划而非依赖固定模板,JevSpawn 从任务描述中组合生成动作空间,在保持 Jev 类推理速度的同时提升 agent 的自主性与任务成功率。
核心洞察
- JevSpawn 将自然语言任务指令组合为有限动作空间,使 Jev 风格的概率模型能够用于开放式 agentic 任务。传统 Jev 模型需要预先定义动作字段,限制了其自主性;而 JevSpawn 通过组合策略从指令中动态构建动作树,并利用并行 spawning 扩展探索,结合反馈进行分支选择和表示修订。这一设计与 TypeSafe Jev 变体及逐 token 生成的 LLM agents 相比,在保持灵活性的同时获得了 Jev 模型的快速概率推理优势。
- 共享动作结构与模型前缀实现了免训练的高效推理,通过并行评估与保留备选分支降低重复计算。在相同推理预算下,LLM agents 逐个生成 token 并反复计算长上下文,而 JevSpawn 利用共享结构和前缀避免重复编码与生成;反馈驱动的分支选择和从保留备选方案中恢复的机制,使模型在探索与利用之间取得平衡。该方法在八个基准任务上相对七种 agent 基线取得了更优任务性能和更快导航速度,且无需额外训练。
方法
输入
- 自然语言任务指令(如“走出迷宫”“排列方块”)与环境初始状态。
- 每步交互后的环境反馈(状态变化、奖励或错误信号)。
关键模块
组合动作空间构建
利用大模型将任务指令解析为一组动作基元和组合规则,动态生成有限的动作树(action tree)。这替代了 TypeSafe Jev 依赖预先固定动作字段的做法,使动作空间可随任务自适应调整。并行动作生成
基于 Jev 模型在有限字段上快速给出概率预测,对动作树中的多个分支同时进行并行生成(parallel action spawning)。共享动作结构和模型前缀(prefix)减少了重复的上下文计算与 token 生成开销。反馈驱动的分支选择与修订
根据环境反馈对候选分支评分,选择高潜力分支继续展开;同时根据观察结果修订动作表示(representation revision),例如增删动作基元或调整组合条件。表现欠佳但仍有潜在价值的分支被保留,便于后续恢复(recovery from retained alternatives)。输出与交互循环
输出为结构化动作序列,逐步与环境交互直至任务完成。整个过程仅在推理时进行组合与并行,无需额外训练。
与同类方法差异
TypeSafe Jev 要求事先定义完整的有限字段,而 JevSpawn 通过组合策略将自然语言任务规范动态映射到可扩展的动作空间,并引入并行分支、反馈选择和保留备选机制,实现更高适应性与更低交互延迟。
实验
实验设计
JevSpawn 在八个 benchmark 任务上评估,涵盖 PPNL、Maze、Grid、LightsOut、RushHour 等环境,对比七个 agent 基线和一个 TypeSafe Jev 变体。实验关注任务完成性能与执行效率,包括导航步骤、推理延迟和上下文计算开销。由于论文未提供具体数值指标,以下发现基于定性描述。
关键发现
- 组合动作空间:JevSpawn 通过自然语言任务规范动态构建有限概率动作树,支持并行动作 spawning,避免预先固定动作字段。
- 自适应分支探索:反馈驱动的分支选择与表征修订(representation revision)使策略能够从保留的备选分支中恢复,提升复杂任务完成率。
- 计算复用:共享动作结构和模型前缀减少重复生成与上下文计算,无需额外训练,降低推理成本。
基线对比解读
相比 token 级生成的通用 LLM agent,JevSpawn 通过结构化有限动作空间避免逐 token 生成动作序列,缩短交互周期。相比原始 Jev 模型要求动作空间预先指定,JevSpawn 的组成式策略将自然语言任务转化为概率探索,摆脱了对人工定义动作字段的依赖。与 TypeSafe Jev 变体相比,JevSpawn 引入并行评估、分支保留与恢复,在自主任务求解中表现出更高的适应性和导航速度。
行业影响
落地场景
JevSpawn 适用于需要长程、多步交互的 LLM agent 产品。例如:
- 电商客服自动化:处理订单查询、退换货、物流追踪等多工具调用任务,动作空间大且需根据用户输入动态调整。
- 内容平台审核 agent:对文本/图片进行多轮规则校验与工具调用,需快速探索不同审核路径。
- 金融数据分析 agent:查询行情、财务数据、新闻等 API,根据中间结果动态选择下一步动作。
商业价值
- 降本:并行动作生成与共享前缀减少重复 token 生成和上下文计算,降低每任务推理成本;Jev 概率预测比自回归解码步数更少,延迟更低。
- 增收/体验:更高的任务完成率和更快的响应速度,让 agent 在固定预算内完成更长 horizon 的任务,提升自动化流水线的吞吐和客户满意度。
与现有产品/工作流接口
- 可作为 action decoding 层 嵌入现有 agent 框架,如 LangChain/LlamaIndex 的 ReAct 循环或 OpenAI function calling,将自然语言指令解析成有限动作字段后由 JevSpawn 并行评估。
- 与 constrained decoding、prefix caching、model router 组合:LLM 负责自然语言理解和表征修订,JevSpawn 负责快速探索,形成混合推理栈。无需额外训练,便于在现有模型服务上部署。
局限
- **有限动作空间假设**:JevSpawn 虽然通过**组合动作空间**从自然语言动态构建有限域,但其底层仍依赖 Jev-style 模型的有限概率预测,因此对于连续控制或高维原始动作(如机器人关节力矩、像素级操作)的扩展性未做讨论。论文实验集中在离散逻辑/棋盘类任务(如 Maze、Sokoban、2048),这些环境的动作空间本身较小且结构化,无法证明方法在开放式、非结构化或连续动作空间中的有效性。此外,组合规则的设计可能需要任务先验,泛化到全新领域时可能需要人工调整。
- **分支选择与探索策略缺乏细节**:摘要中提到 "feedback driven branch selection" 和 "recovery from retained alternatives",但正文未给出具体的分支选择机制实现(如启发式规则、学习型选择器或概率采样)。若选择策略依赖简单规则,可能在复杂任务中陷入局部次优;若需要额外模型,则可能与 "without additional training" 的声明冲突。并行 spawning 的数量与计算预算的权衡(expansion width)需要人工设定,缺少自适应调节机制,这在实际部署中可能成为超参数调优的负担。
- **基准范围与基线比较有限**:实验在八个任务上与七个 agent baselines 和一个 TypeSafe Jev 变体比较,但未与更通用的 LLM agent 框架(如 ReAct 的改进版、Tree-of-Thoughts 等)进行深度对比,也未报告在长 horizon 任务上的稳定性与失败案例分析。论文作为 arXiv 预印本,GitHub 星数为 1,社区验证尚不充分。此外,缺乏对计算开销的定量对比(如总 FLOPs、推理延迟 vs. 任务成功率),难以全面评估实际效率收益。